Perplexity AI本地版支持RTX显卡:隐私与性能兼得

Perplexity AI本地版支持RTX显卡:隐私与性能兼得
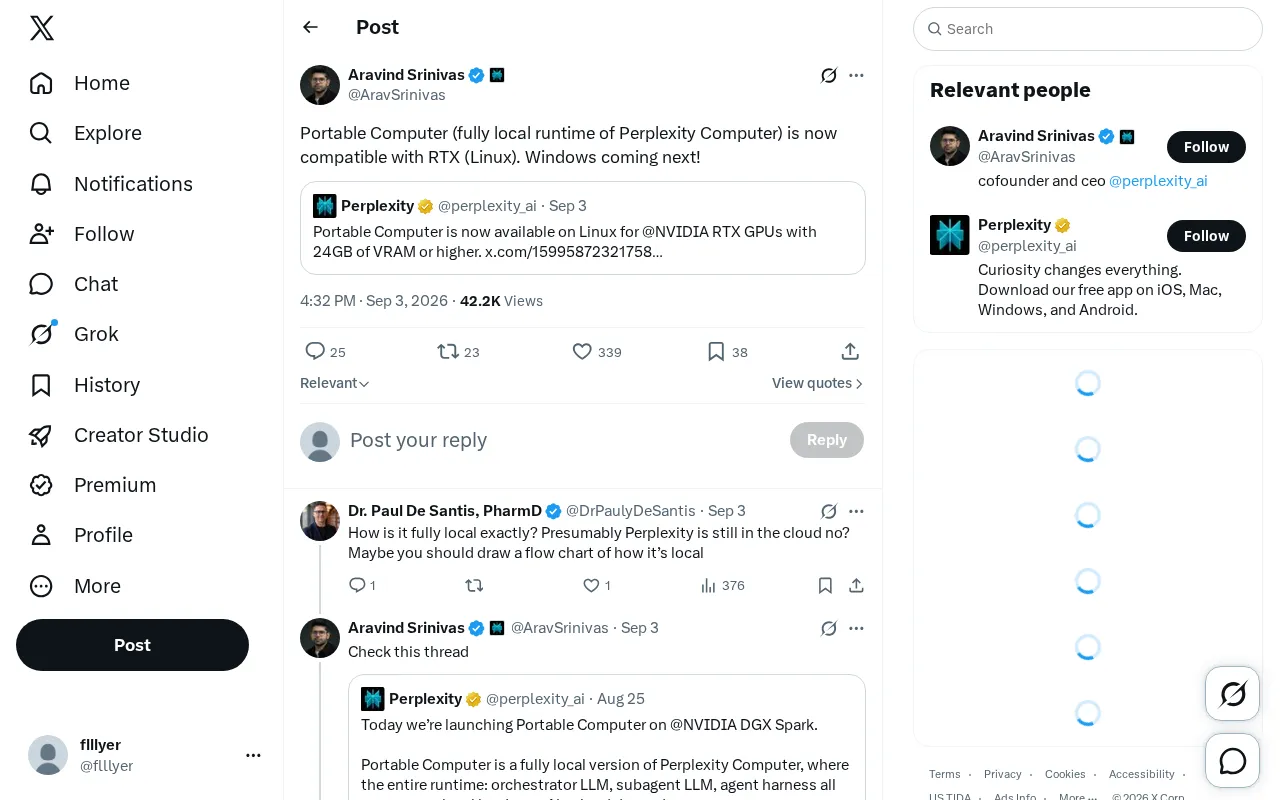
近日,Perplexity AI团队宣布其本地运行环境Portable Computer已实现对NVIDIA RTX显卡的完整支持(Linux平台),Windows版本也即将推出。这标志着AI搜索和推理工具正式迈入完全本地化、高性能运算的新阶段。
Perplexity AI 成立于2022年,由前OpenAI研究员Aravind Srinivas创立,定位为"答案引擎"而非传统搜索引擎。它结合了大语言模型的生成能力与实时网络检索能力,能够为用户提供带有来源引用的结构化答案。这种技术路线被称为检索增强生成(Retrieval-Augmented Generation,RAG)。RAG的核心思想是在大语言模型生成回答之前,先从外部知识库或互联网中检索相关信息,将检索到的上下文作为提示(prompt)的一部分注入模型,从而让模型的回答既具备语言生成的流畅性,又能锚定于真实、可验证的信息源。与纯LLM方案相比,RAG显著降低了"幻觉"(hallucination)问题的发生率;与传统搜索引擎相比,RAG不仅返回链接列表,而是直接合成结构化答案并标注出处。Perplexity正是将这一技术路线产品化做到极致的代表。截至2024年,Perplexity已完成多轮融资,估值超过90亿美元,成为AI搜索赛道最具影响力的独角兽之一。此次推出Portable Computer本地版,是其从纯云端服务向混合部署模式转型的关键一步。
Portable Computer:让AI完全在本地运行
Portable Computer是Perplexity Computer的完全本地运行版本,允许用户在自己的设备上运行Perplexity的AI能力,无需依赖云端服务器。这一设计与当前AI领域的"边缘计算"和"本地优先"趋势高度契合。
边缘计算(Edge Computing)是一种将数据处理从云端下沉到靠近数据源的本地设备上的计算范式。在AI领域,这一趋势被称为"本地优先"(Local-first)或"设备端AI"(On-device AI),其核心驱动力包括数据主权法规(如GDPR、中国《数据安全法》)日趋严格、云端API成本持续攀升、以及用户对隐私意识的觉醒。苹果的Apple Intelligence、高通的AI PC战略,以及Meta将Llama模型开源供本地部署,都是这一趋势的典型体现。值得关注的是,"本地优先"并不意味着完全放弃云端——更成熟的产品形态是"混合智能"架构:简单的查询和对隐私敏感的任务在本地处理,而需要超大模型能力或实时网络信息的复杂任务则选择性地调用云端资源。Perplexity的Portable Computer正是朝着这一方向演进的产品。
相比云端方案,本地运行具有明显优势:
- 数据隐私:所有数据在本地处理,不上传云端,完全符合数据主权法规的要求。在医疗、金融、法律等受监管行业,数据不出本地设备这一特性尤为关键,可以避免复杂的合规审查流程
- 响应速度:零网络延迟,即时获得结果。在典型的云端API调用中,网络往返延迟通常在50-200毫秒之间,而本地推理完全消除了这一开销
- 离线可用:不受网络连接限制,在飞行模式或网络不稳定环境中依然可用
- 成本透明:无需担心API调用费用,尤其适合高频使用场景。对于日均调用量超过数千次的开发者或团队,本地部署的成本优势尤为显著
对于企业用户和注重隐私的开发者而言,这种完全本地化的解决方案具有重要价值。
RTX显卡加持:性能提升数倍
NVIDIA RTX系列显卡配备了专用的Tensor Core,专为AI推理和深度学习任务优化。Tensor Core是NVIDIA从Volta架构(2017年)开始引入的专用矩阵运算单元,专门为深度学习中的矩阵乘加运算(FMA,Fused Multiply-Add)设计。传统的GPU计算依赖CUDA Core逐元素执行浮点运算,而Tensor Core可以在单个时钟周期内完成4x4矩阵的乘加运算,这与Transformer架构中大量的矩阵乘法操作(注意力机制的Q·K^T计算、前馈网络的线性变换等)完美匹配,从而将AI推理和训练的吞吐量提升数倍。
从架构演进来看,Tensor Core经历了四代迭代:第一代(Volta/Turing,RTX 20系列)支持FP16混合精度;第二代(Ampere,RTX 30系列)新增TF32和稀疏矩阵加速,引入了结构化稀疏性(Structured Sparsity)技术,可将具有规律性稀疏模式的矩阵运算速度再提升一倍;第三代(Ada Lovelace,RTX 40系列)进一步引入FP8精度支持。FP8是一种仅用8位表示浮点数的数据格式,相比FP16将每个参数的存储空间减半,这意味着相同显存可以加载更大的模型,同时计算吞吐量也翻倍。在实际AI推理任务中,FP8的精度损失通常可以忽略不计,因此它正在成为推理阶段的默认精度选择。这意味着即使是消费级的RTX 4060也具备了运行中等规模大语言模型的能力。
Portable Computer对RTX的支持带来显著提升:
推理速度大幅提升:利用RTX显卡的并行计算能力,大语言模型推理速度可提升数倍甚至数十倍,使本地AI应用接近甚至超越某些云端服务的响应速度。具体来说,大语言模型的推理过程分为两个阶段:预填充(prefill,一次性处理所有输入token)和解码(decode,逐token生成输出)。GPU的大规模并行能力在预填充阶段优势最为明显,而在解码阶段,显存带宽往往成为瓶颈。RTX 40系列显卡的高显存带宽(如RTX 4090的1TB/s)使其在解码阶段也能保持较高的token生成速率,实现接近实时对话的体验。
支持更大模型:RTX 4090等高端显卡拥有24GB显存,足以运行70亿至130亿参数的开源模型,为本地AI应用提供更强大的能力基础。值得注意的是,大语言模型在本地运行时,显存(VRAM)是最关键的硬件瓶颈。以FP16(半精度浮点数)格式加载模型为例,每10亿参数约需2GB显存。因此,7B参数的模型需要约14GB显存,13B参数的模型需要约26GB。不过,通过量化技术可以大幅压缩显存需求。
当前主流的量化方案各有特色:GPTQ(GPT-Quantized)是一种训练后量化方法,通过逐层最小化量化误差来保持模型质量,适合GPU推理,是最早被广泛采用的LLM量化格式之一;AWQ(Activation-aware Weight Quantization)则在量化时考虑激活值的分布特征,对"重要"权重保留更高精度,通常比GPTQ获得更好的量化质量;GGUF(由llama.cpp项目维护的格式)的最大优势在于支持CPU+GPU混合推理——当显存不足以完全加载模型时,可以将部分层卸载到系统内存,虽然速度会下降但至少能运行更大的模型。以4-bit量化为例,显存需求可压缩至原来的1/4左右——7B模型仅需约4GB显存,13B模型约需8GB显存,这使得RTX 3060(12GB)甚至更低端的显卡也能运行相当规模的模型。量化会带来一定的精度损失,但在实际使用中通常难以察觉,多项评测表明4-bit量化模型在大多数基准测试上的性能下降不超过1-3%。
长期成本更低:对于高频使用场景,本地GPU推理的边际成本远低于按Token计费的云端API,长期来看具有显著的经济优势。以GPT-4o的API定价为参照(输入约$2.50/百万token,输出约$10.00/百万token),一张RTX 4090的投资回报周期在高频使用场景下可能仅需数月。而且本地GPU不仅可用于AI推理,还可用于图形渲染、视频编辑等其他计算任务,进一步提高了硬件投资的利用率。
本地AI工具的发展趋势
这一进展反映了AI工具的重要转变:从云端集中式向本地分布式发展。OpenAI、Anthropic等公司提供云端API服务,而Ollama、LM Studio等工具专注于本地部署。
当前本地AI部署工具已形成丰富的生态,每个工具在架构设计和目标用户上各有侧重:
- Ollama 以命令行为核心,提供极简的模型拉取和运行体验(一条
ollama run llama3命令即可启动),支持Llama、Mistral、Gemma等主流开源模型。Ollama在底层使用llama.cpp作为推理引擎,并自动处理模型格式转换和GPU卸载等复杂配置,适合有一定技术背景的开发者快速上手。 - LM Studio 则提供图形化界面,用户可以通过拖拽操作下载、加载和切换模型,还内置了聊天界面和OpenAI兼容API服务器,降低了非技术用户的使用门槛。
- vLLM 是一个面向生产环境的高性能推理引擎,其核心创新是PagedAttention技术——借鉴操作系统虚拟内存管理的思想,将KV Cache分页存储,显著提高了显存利用率和并发请求的吞吐量,特别适合需要同时服务多个用户的本地API场景。
- llama.cpp 由Georgi Gerganov开发,是整个本地LLM生态的基石之一。它使用纯C/C++实现,支持CPU推理(通过AVX/AVX2/AVX-512指令集加速)和多种GPU后端(CUDA、Metal、Vulkan等),以极低的依赖要求和跨平台兼容性著称。
Perplexity的Portable Computer与这些工具的根本差异在于,它不仅是一个模型运行时,更集成了Perplexity独特的检索增强生成(RAG)能力和搜索流程——包括查询分解、多源检索、结果排序、答案合成与引用标注等完整的搜索管线。这意味着用户获得的是端到端的AI搜索体验而非单纯的对话接口。这种差异化定位使Portable Computer在本地AI工具生态中占据了独特的位置。
Perplexity通过Portable Computer同时提供云端和本地两种选择,展现了更灵活的产品策略。
对开发者而言,本地RTX支持降低了构建AI应用的门槛:
- 无需申请API密钥
- 不必管理配额限制
- 可自由实验和迭代
- 避免成本超支风险
这对AI创新生态的繁荣具有积极推动作用。本地运行还为开发者提供了更大的自由度来进行prompt工程实验、微调探索和应用原型开发,而不必担心每次实验的API费用累积。
Windows版本即将推出
公告提到Windows支持即将到来,这将进一步扩大用户基础。考虑到Windows在桌面操作系统市场的主导地位(全球市场份额超过70%),以及大量RTX显卡用户运行Windows系统(Steam硬件调查显示超过96%的游戏用户使用Windows),Windows版本的推出有望让Portable Computer触达更广泛的用户群体。
技术实现上,Windows环境下的CUDA驱动和深度学习框架支持已相当成熟。CUDA(Compute Unified Device Architecture)是NVIDIA于2006年推出的并行计算平台和编程模型,它允许开发者使用C/C++等高级语言编写在GPU上执行的并行程序,将GPU从单纯的图形处理器转变为通用计算加速器。经过近20年的发展,CUDA生态在Windows平台已高度成熟:PyTorch、TensorFlow等主流深度学习框架均提供Windows原生CUDA支持,cuDNN(CUDA Deep Neural Network Library,提供高度优化的卷积、归一化等神经网络基本操作)和TensorRT(NVIDIA的高性能推理优化引擎,通过算子融合、精度校准、内核自动调优等技术将推理延迟降至最低)等推理优化库也全面兼容Windows环境。此外,NVIDIA的Game Ready驱动和Studio驱动已内置CUDA运行时,用户无需额外安装即可获得GPU加速能力。
值得一提的是,Windows 11的WSL2(Windows Subsystem for Linux 2)也已支持GPU直通(GPU Passthrough),开发者甚至可以在Windows上通过WSL2运行Linux版本的AI工具并获得完整的GPU加速。但原生Windows版本仍然是体验最流畅、配置最简单的选择。这些技术基础为Portable Computer的Windows移植提供了坚实的支撑,理论上甚至可以实现"开箱即用"的体验。
预计Windows版本将保持与Linux版本相同的性能表现和功能特性。
总结
Portable Computer对RTX显卡的支持是本地AI运行时发展的重要里程碑。它为用户提供了隐私保护、低延迟、成本可控的AI能力,同时保持了与云端服务相当的性能水平。
随着Windows版本的推出和生态的进一步完善,完全本地化的AI工具有望成为开发者和企业用户的重要选择。对于关注AI技术发展的从业者,这一趋势值得持续关注:本地运行能力的提升将重新定义AI应用的架构模式,并可能催生新的产品形态和商业模式。随着开源模型能力的持续进步(Llama 3、Qwen 2.5、Mistral等开源模型在多项基准上已接近甚至匹配闭源模型的表现)和消费级GPU算力的不断增长,"人人拥有本地AI"正在从愿景变为现实。未来,本地AI与云端AI的界限将越来越模糊,真正的智能将无处不在——既在云端,也在你的桌面上。
核心要点
相关推荐
企业级AI Agent全栈开发实战:从零搭建可上线智能体的学习路径
一份企业级AI Agent全栈开发课程导学解析:涵盖为什么学Agent、适合人群、LangChain与CrewAI框架学习路径,以及从单智能体到多智能体的实战落地方案,助你搭建可上线的智能体应用。
从真实项目拆解AI智能体:基于LangGraph的学习助手架构实践
以真实上线的AI学习助手为例,拆解基于LangGraph、Neo4j知识图谱、Redis与MinIO的智能体架构实践,解析为何面试官偏爱复杂真实项目,以及FDE岗位的求职方向。
LangChain 1.3 入门指南:大模型与Agent核心概念解析
LangChain 1.3入门教程:解析大语言模型的三大局限、框架的统一接口与模块化架构,以及LLM、Agent、DeepAgent与Harness架构的层级关系,助你理解大模型应用开发核心概念。