Praxis:把研究论文转化为可落地的工程蓝图
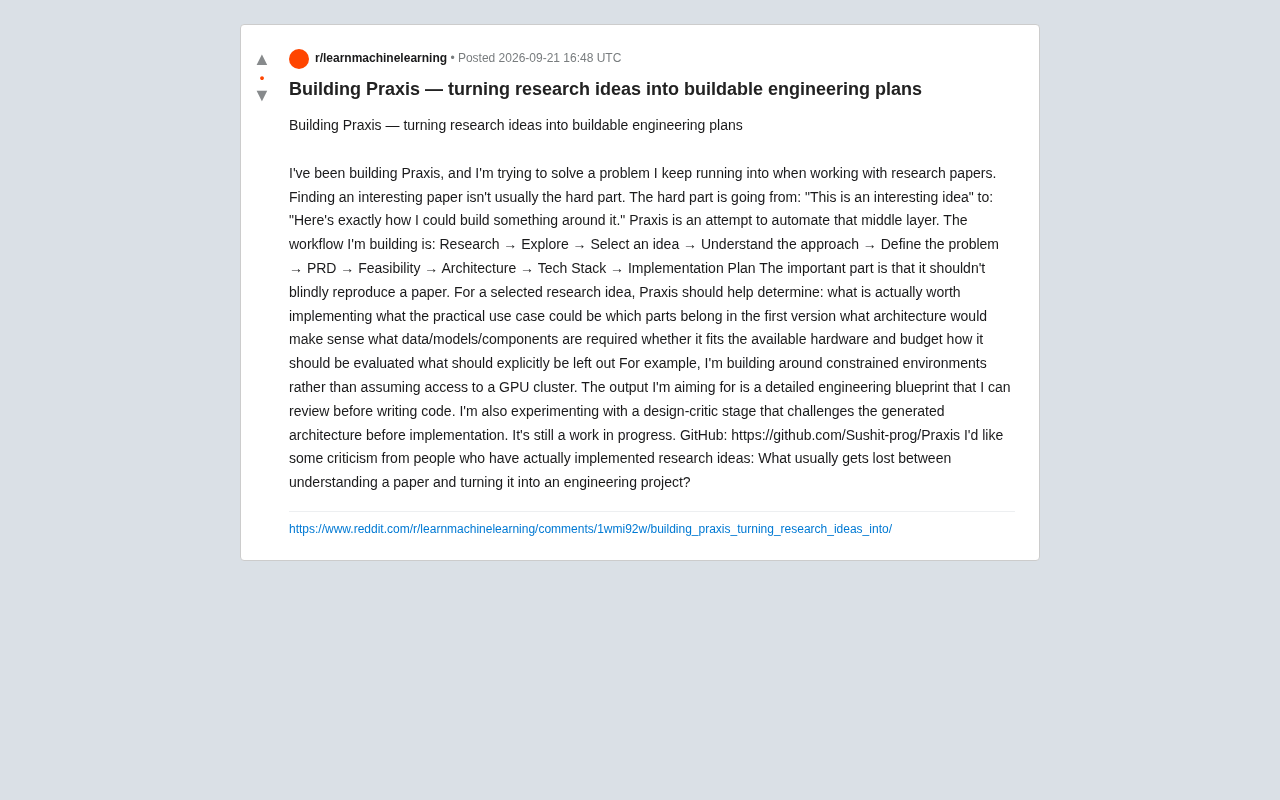
Praxis 是一个开源工具,将论文研究思路自动转化为可评审的工程蓝图,填补「理解论文」与「动手写代码」之间的断层。
Praxis 是开发者 Sushit 开源的一个工具,专门解决研究者和开发者从「读懂一篇论文」到「知道具体该做什么」之间的断层问题。它不追求直接生成代码或复现论文,而是将研究想法转译成一份覆盖 PRD、可行性分析、架构设计与实现计划的工程蓝图。其设计针对受限硬件和预算环境,将可行性判断前置于蓝图阶段。项目还引入了「设计批评」环节,在进入实现前对架构进行对抗性评审,以提前暴露方案中的隐患。作者认为,论文到工程之间真正丢失的不是算法细节,而是工程决策的上下文——那些论文默认、省略或无法迁移到实际约束下的假设。项目目前已在 GitHub 开源,仍处于开发阶段。
从「有趣的想法」到「能动手做」的鸿沟
读论文的人大多有过这样的体验:找到一篇有意思的研究并不难,真正卡壳的往往是下一步——如何把「这个想法很有趣」变成「我具体该怎么围绕它做出一个东西」。这个中间层的断裂,正是开发者 Sushit 在 Reddit 上分享的开源项目 Praxis 想要解决的核心问题。
Praxis 的定位不是复现论文,而是把论文中的研究思路转译成一份可评审的工程蓝图。用作者的话说,它试图自动化的是「理解论文」与「动手写代码」之间那段最容易掉链子的路程。
Praxis 的工作流设计
作者把整个流程拆解成一条清晰的链路:
Research → Explore → 选定想法 → 理解方法 → 定义问题 → PRD → 可行性 → 架构 → 技术栈 → 实现计划
这套流程的关键在于「不盲目复现论文」。对于一个选定的研究想法,Praxis 会尝试回答一系列工程决策问题:
- 什么部分真正值得实现
- 实际的应用场景可能是什么
- 哪些功能应该进入第一个版本
- 什么样的架构才合理
- 需要哪些数据、模型和组件
- 是否适配现有的硬件和预算
- 应该如何评估效果
- 哪些内容应当明确排除在外
这些问题恰恰是很多研究复现项目失败的地方——不是技术不行,而是从一开始就没想清楚「做到哪一步为止」。
面向受限环境而非 GPU 集群
一个值得关注的设计取向是:Praxis 假设的是受限环境(constrained environments),而不是默认你手握一整个 GPU 集群。这一点对独立开发者和小团队尤其务实。很多论文的实验设置本身就建立在充裕算力之上,直接照搬往往在硬件和预算这一关就走不通。Praxis 把「是否适配可用硬件和预算」作为显式的决策节点,等于在蓝图阶段就把可行性问题前置了。
「设计批评」阶段:让架构先接受质疑
Praxis 中一个比较有意思的实验性设计是 design-critic(设计批评)阶段:在进入实现之前,先由一个批评环节挑战已生成的架构方案。
这个思路对应了工程实践中常见的痛点——生成式工具往往会给出一份看似完整、实则未经压力测试的方案。加入一个专门「找茬」的环节,本质上是在写代码之前先做一轮对抗性评审,尽早暴露架构中的隐患。作者也坦言项目仍在推进中(work in progress),这一阶段属于正在打磨的部分。
「设计批评」的思路在软件工程中有更广泛的先例。传统的架构评审(Architecture Review Board)和红队测试(Red Teaming)都遵循类似逻辑:让一个独立视角在方案固化前找出漏洞。在 AI 辅助开发的语境下,这种模式有时被称为「批评者-生成者」分离(critic-generator separation),即用不同的提示或 agent 角色分别负责「产出方案」和「挑战方案」,以对抗语言模型倾向于自我确认(self-confirmation)的偏差。单一 agent 在生成后立刻被要求自我批评时,往往效果有限;而将批评设计为独立阶段,更容易暴露假设过于乐观、边界条件未覆盖、依赖未声明等常见问题。Praxis 将这一环节前置到写代码之前,而非放在代码评审阶段,理论上能减少因架构缺陷导致的大规模返工成本。
真正会丢失的是什么?
作者在帖子结尾抛出了一个值得所有做过研究复现的人思考的问题:
在「理解一篇论文」和「把它变成一个工程项目」之间,通常会丢失什么?
从 Praxis 的流程设计可以反推出作者的判断:丢失的往往不是算法细节,而是工程决策的上下文——论文默认的实验条件、被省略的取舍、无法迁移到实际约束下的假设。一篇论文告诉你「这个方法有效」,却很少告诉你「在你的预算和硬件下,第一版该做什么、不该做什么」。
Praxis 想填补的正是这层信息。它输出的不是代码,而是一份可以在写代码前反复审阅的详细工程蓝图。这种「先规划、再实现」的思路,对于把学术成果转化为实际产品的开发者来说,方向是对的。
这类从学术成果到工程实现的「翻译」困难,在 MLOps 和研究工程化(Research Engineering)领域已被广泛讨论。论文通常在理想化条件下报告结果:固定的数据集分割、专用计算集群、经过反复调参的超参数,以及往往被压缩进附录的实现细节。当开发者试图复现时,面对的是「复现差距」(reproducibility gap)——即便完全按论文描述实现,结果也常常无法对齐,原因可能是随机种子、库版本、硬件差异,甚至是论文中未明确说明的数据预处理步骤。更深层的问题是「工程意图」的缺失:论文作者清楚哪些 ablation 是关键的、哪些 trick 是必须的,但这些判断很少被写进正文。Praxis 试图通过系统性追问「什么应该进第一版」来显式化这些被省略的工程决策。
小结
Praxis 目前仍处于开发阶段,代码已在 GitHub 开源(github.com/Sushit-prog/Praxis)。它代表了一类正在兴起的工具思路:不追求端到端的自动代码生成,而是聚焦于研究到工程之间那段最难自动化、也最需要判断力的「翻译层」。对于经常在论文与产品之间来回挣扎的开发者,这样的工具值得保持关注。
作者也公开征求实际做过研究复现的人的批评意见,这本身也是开源早期项目健康的信号。
相关推荐
一周告别美国科技巨头:替换17项技术依赖的实战复盘
一个欧洲创业团队用一周时间替换了17项美国科技巨头依赖:从Google Cloud、GitHub、Cloudflare迁移到Hetzner、Forgejo、Scaleway等欧洲及自托管方案。本文复盘迁移清单、动因与仍未解决的难题。
客服AI实战选型:实时辅助、自动化与QA全覆盖指南
一位美国互联网服务商客服运营负责人分享250人团队的AI选型需求:通话实时辅助、常规问题自动化、QA全覆盖与Salesforce集成。本文拆解客服AI落地的五大核心考量,为同类团队提供选型框架。
三星向Kairos Power投资1亿美元,为谷歌建核反应堆
Kairos Power获三星物产最高1亿美元投资,共建首座50兆瓦核电站,核心客户为谷歌。这笔交易折射出AI数据中心对稳定清洁电力的巨大需求,以及科技巨头加速布局核能的行业趋势。