Prefixwise v0.10.0:跨平台诊断LLM提示缓存未命中,零文本存储
开源工具Prefixwise v0.10.0专注诊断和修复LLM提示缓存未命中,覆盖多平台。
Prefixwise v0.10.0是一款MIT协议开源工具,旨在识别、修复并预防跨平台的LLM提示缓存未命中问题,支持vLLM、SGLang、LMCache、Claude和OpenAI等主流推理框架与API。文章指出,缓存未命中会显著增加推理成本和延迟,却难以定位。Prefixwise提供“诊断-修复-预防”三阶段工作流,并强调零提示文本存储以降低隐私风险。该工具适合自托管推理和商业API两类场景,但当前信息仅来自Reddit社区分享,实际效果、平台支持程度和零存储的具体含义仍需进一步验证。
为什么提示缓存未命中值得关注
在大模型应用的成本结构中,提示缓存(prompt cache)的命中率直接影响推理开销和响应延迟。当相同或相似的前缀被重复使用时,缓存命中可以避免重复计算,从而显著降低成本。然而,缓存未命中往往难以定位——开发者通常只能看到账单上涨或延迟抖动,却不知道是哪个环节破坏了缓存。
据Reddit社区分享,开源工具Prefixwise v0.10.0(MIT协议)正是针对这一痛点设计。它能够识别、修复并预防跨平台的LLM提示缓存未命中问题,覆盖vLLM、SGLang、LMCache、Claude和OpenAI等主流推理框架与API服务。
提示缓存(prompt cache) 是大模型推理中的一种优化机制:当多个请求共享相同的前缀(如系统提示、少样本示例或多轮对话的历史部分)时,推理引擎可以复用已计算的键值缓存(KV cache),避免对相同 token 序列重复执行自注意力计算。以 vLLM 的 PagedAttention 和自动前缀缓存(APC)为例,系统会按块(block)对 KV 缓存进行哈希索引,只有前缀完全一致且块对齐时才能命中。一旦前缀中插入动态内容(如时间戳、随机 ID)或调整了消息顺序,后续所有 token 的缓存都会失效,导致计算量和延迟成倍增加。对于商业 API,OpenAI 和 Claude 也提供类似的自动缓存机制,但计费规则不同:缓存命中的输入 token 通常享受折扣(如 OpenAI 的缓存命中价格约为未命中的 10%–50%),因此命中率直接决定成本。
核心功能:诊断、修复与预防
Prefixwise的定位并非简单的监控面板,而是围绕缓存未命中构建了一套工作流。根据项目描述,其能力可归纳为三个层面:
- 识别:分析请求模式,找出导致缓存失效的提示结构或调用顺序。
- 修复:针对已发现的问题提供调整建议或自动修正。
- 预防:在开发阶段建立防护机制,避免后续引入破坏缓存的变更。
这种“诊断-修复-预防”的闭环,对于频繁迭代提示词或使用多轮对话的应用尤为重要。因为缓存未命中常常源于细微的提示变动,例如系统消息顺序调整、动态时间戳插入、或者工具调用结果的格式变化。
跨平台覆盖:从自托管到商业API
Prefixwise宣称支持vLLM、SGLang、LMCache、Claude和OpenAI。这意味着它同时面向两类场景:
- 自托管推理:vLLM和SGLang是流行的开源推理引擎,LMCache则专注于KV缓存管理。在这些环境中,缓存机制通常与具体配置和版本相关,Prefixwise可以帮助开发者理解缓存行为并优化命中率。
- 商业API:Claude和OpenAI的提示缓存功能由服务商管理,开发者对底层不可见。Prefixwise能够从调用侧分析哪些请求可能未命中缓存,从而调整提示设计。
跨平台支持降低了团队在混合部署环境中的工具碎片化问题,但实际效果可能因平台特性而异。
vLLM 是一个高吞吐的开源 LLM 推理和服务引擎,其核心创新包括 PagedAttention(将 KV 缓存分页管理以降低显存碎片)和连续批处理(continuous batching)。它内置自动前缀缓存功能,但默认可能未开启或需配置 enable_prefix_caching=True。SGLang 是另一个面向结构化生成和高效推理的开源框架,其 RadixAttention 使用基数树(radix tree)管理 KV 缓存,支持跨请求的前缀共享和更细粒度的缓存复用。LMCache 则专注于将 KV 缓存从 GPU 显存卸载到 CPU 内存或外部存储,并支持跨实例共享缓存,常用于长上下文和多轮对话场景。三者的缓存实现和配置项各不相同,这也是跨平台诊断工具需要分别适配的原因。
隐私设计:零提示文本存储
项目标题中特别强调“zero prompt text stored”(零提示文本存储)。在LLM应用开发中,提示内容可能包含敏感信息或业务逻辑,将提示全文上传到第三方工具存在合规风险。Prefixwise声称不存储提示文本,这有助于它在对数据隐私要求较高的场景中落地。
不过,具体实现方式(例如是否存储哈希、元数据或统计信息)在原始素材中未详细说明,开发者在使用前应查阅项目文档以确认数据流向。
适用场景与局限
Prefixwise适合以下团队:
- 使用vLLM、SGLang等自托管推理服务,希望优化缓存命中率的工程团队。
- 通过OpenAI或Claude API构建应用,需要控制提示缓存成本的开发者。
- 对提示隐私敏感,不愿将完整提示内容交由外部工具处理的组织。
需要注意的是,原始信息仅来自Reddit社区分享,尚未经过独立验证。工具的实际效果、对各个平台的支持程度、以及“零存储”的具体含义,都需要进一步考察。此外,缓存未命中的根因可能涉及服务商侧的缓存策略调整,Prefixwise能否完全覆盖这些情况尚不明确。
小结
Prefixwise v0.10.0以MIT协议开源,切入LLM推理成本优化中一个具体但常被忽视的环节——提示缓存未命中。其跨平台覆盖和零文本存储的设计具有吸引力,但作为社区分享的新工具,建议开发者以审慎态度评估,并结合自身技术栈进行测试。
相关推荐
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
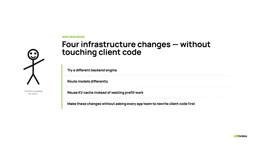
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。