Premortem:用AI智能体给创业想法做"死前验尸"

Premortem用AI多智能体对创业想法执行"事前验尸",系统性暴露失败风险以对冲创业者的乐观偏差。
Premortem是一款将"事前验尸"方法论与AI智能体结合的创业验证工具。它让AI以红队视角——而非通用AI惯常的迎合式反馈——对创业想法发起系统性批判,覆盖市场需求、商业模式、竞争壁垒与执行可行性等维度,帮助创业者在投入资源前发现被乐观情绪掩盖的风险。工具采用多智能体分工扮演不同质疑角色,试图构建对抗性评估环境,对冲确认偏误。然而工具当前仍处早期、社区反响平淡,核心局限在于大模型难以捕捉行业特定的监管、渠道与用户细节,分析存在流于通用模板的风险。最合理的使用方式是将其作为低成本风险自查的起点,而非决策依据,真正的验证仍需走向真实市场。
一个反向思考的创业验证工具
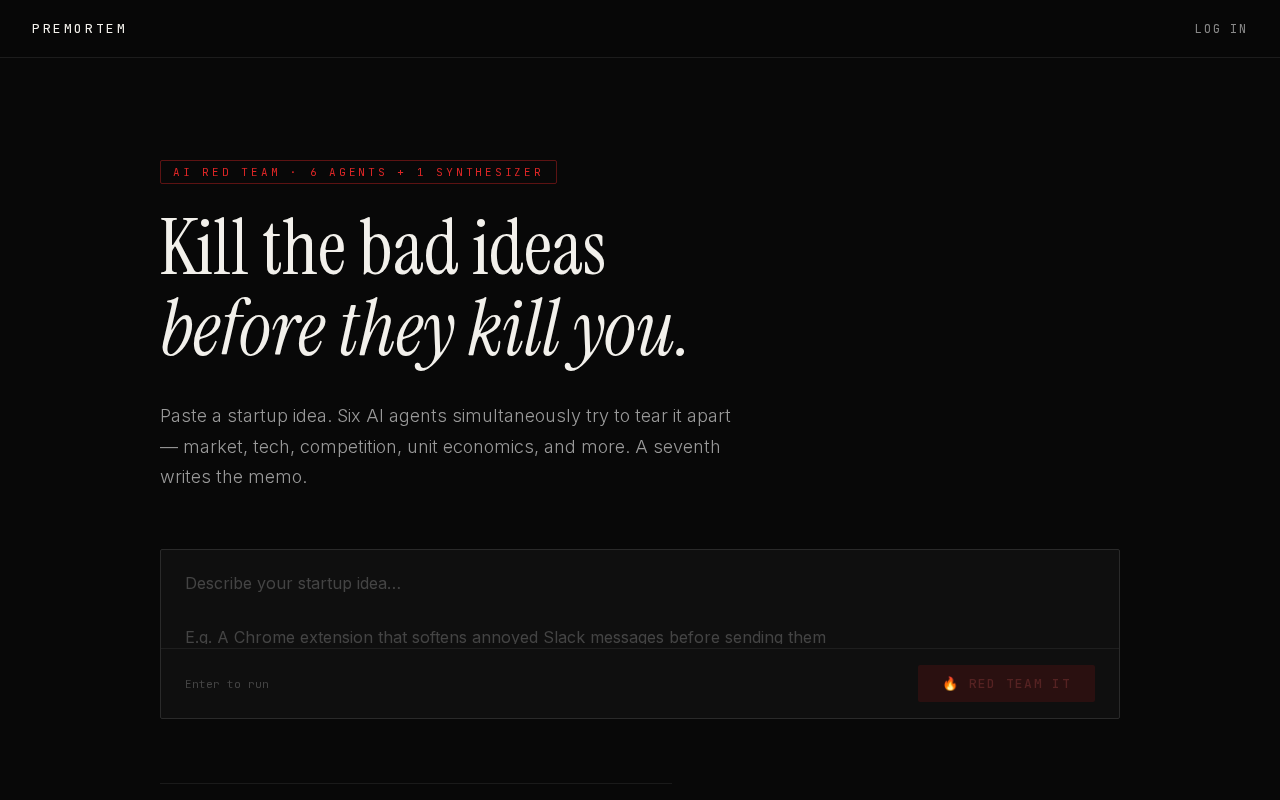
在Hacker News的Show HN板块,一款名为Premortem的工具引发了小范围讨论。它的核心思路并不复杂,却触及了创业者最容易回避的痛点:在真正投入资源之前,让AI智能体对你的创业想法进行"红队攻击"(red-team),系统性地挖掘它可能失败的所有理由。
"Premortem"(事前验尸)这个概念本身来自心理学和项目管理领域。它要求团队在项目启动前假设项目已经彻底失败,然后倒推可能导致失败的原因。相比传统的乐观评估,这种预设失败的框架能显著降低认知盲区,帮助决策者发现那些被兴奋情绪掩盖的风险。Premortem工具正是把这套方法论交给了AI来执行。
红队思维与AI智能体的结合
所谓"红队"(red-team),源自军事与网络安全领域,指专门扮演对手角色、主动寻找系统漏洞的团队。将这一概念应用到创业想法上,意味着AI不会像常见的ChatGPT对话那样一味给出鼓励式反馈,而是刻意站在批判者的立场,质疑市场需求、商业模式、竞争壁垒和执行可行性。
这种定位解决了AI辅助决策的一个普遍问题:大语言模型天然倾向于迎合用户、给出正面回应。创业者如果只是把想法丢给通用AI,很容易得到一堆"这是个好主意"的廉价肯定,反而强化了确认偏误。Premortem通过多个智能体(AI agents)分工扮演不同的质疑角色,试图构建一个对抗性的评估环境。
为什么创业者需要被"泼冷水"
大量创业失败的根源并非执行力不足,而是最初的方向性假设就站不住脚——没有真实的市场需求、低估了获客成本、高估了用户付费意愿。传统的早期验证依赖用户访谈和MVP测试,成本高、周期长。一个能在几分钟内给出结构化风险清单的工具,哪怕只是作为"第一道筛子",也具备一定的实用价值。
多智能体(multi-agent)架构是Premortem此类工具的技术基础。与单一大模型对话不同,多智能体系统会将任务分解给多个专门化的AI角色,例如一个专门质疑市场规模、一个专门挑战财务假设、一个专门模拟竞争对手视角。这种分工的意义在于:单一对话中AI容易被用户的叙事框架所引导,而多个相互独立的"质疑者"能从不同角度施压,减少某一盲区被忽略的概率。当然,多智能体架构也引入了新的复杂性——各智能体的角色定义质量、协调机制,直接决定输出是否真正具备对抗性,还是流于表面的分工表演。
确认偏误(confirmation bias)是创业早期最危险的认知陷阱之一。心理学研究表明,人们在形成初步判断后,会不自觉地筛选支持该判断的信息、忽视反驳证据。创业者往往对自己的想法投入了大量情感与沉没成本,这使得确认偏误尤为严重——用户访谈中稍微正面的信号会被放大,质疑声音则被归因为"对方不懂"。事前验尸方法论之所以有效,正是因为它通过"假设失败已发生"这一前提,强制切换认知框架,暂时绕过情感防御机制,让当事人更容易接受和产出负面信息。这也是为什么这套方法论在麦肯锡、谷歌等机构的项目评审中有实际应用记录。
工具的定位与局限
从Hacker News上的热度来看(发布时仅4个赞、2条评论),Premortem目前还处于早期阶段,社区反响平淡。这类工具面临的核心质疑也很明确:AI生成的风险分析究竟有多少是真正的洞察,又有多少只是基于训练数据的通用模板。
创业想法的失败往往藏在行业特定的细节里——某个监管政策、某个渠道的隐性成本、某类用户难以察觉的真实痛点。这些恰恰是通用大模型难以准确捕捉的部分。因此,Premortem更合理的使用方式是作为头脑风暴的补充,而非决策依据。它可以帮创业者快速列出需要进一步验证的假设清单,但真正的验证仍然需要走向市场、接触真实用户。
AI工具在决策辅助领域的探索
Premortem代表了AI应用的一个有趣方向:不是替代人类决策,而是通过模拟对抗性视角来改善决策质量。类似的思路还可以延伸到合同审查、投资评估、产品设计评审等场景——让AI扮演"魔鬼代言人",主动暴露方案中的薄弱环节。
这种"对抗式AI辅助"的价值,取决于智能体能否被设计得足够尖锐、足够具体。如果只是把批评包装成模板化的套话,用户很快就会失去兴趣。能否结合行业数据、真实案例库来增强分析的针对性,将决定这类工具是昙花一现还是真正进入创业者的工具箱。
大语言模型在行业特定知识上的局限,本质上源于其训练数据的分布问题。公开互联网上关于监管细节、渠道隐性成本、区域市场差异的深度信息严重稀缺,模型在这些维度上的"知识"往往是统计平均的泛化结论,而非真正的专家洞察。这也是为什么同类AI分析工具在金融合规、医疗、政府采购等重度监管行业中表现远弱于通用场景。对Premortem而言,如果能整合结构化的行业数据库或接入真实失败案例库(如CB Insights的创业尸检报告),其分析针对性会有本质提升,但这也意味着更高的数据获取与维护成本。
小结
Premortem把"事前验尸"这一经典决策方法与AI智能体结合,切入了创业验证这个高价值但充满不确定性的场景。它的思路值得肯定——用对抗性视角对冲创业者的乐观偏差。但工具当前仍处早期,其实际效果取决于AI分析的深度与行业针对性。对创业者而言,不妨把它当作一个低成本的风险自查起点,而把最终判断权留给真实市场的反馈。
相关推荐

免费白嫖Gemini 4与Claude Sonnet 5.5?实测Free.pi教程
实测Free.pi平台免费调用Gemini 4 Argon与Claude Sonnet 5.5的完整流程,包括CLI安装、GitHub登录获取每日15000积分、模型切换与代码任务测试,并分析免费通道的潜在限制。

Microduck:用Rust打造的双足机器鸭,GitHub一日斩获421星
Pollen Robotics开源项目microduck:一个用Rust编写的微型双足机器鸭,GitHub单日新增421星,总星数超1万。本文解析其技术栈、双足行走控制原理及对机器人学习者的价值。

2.2万Star的电子书宝库:一个GitHub仓库如何聚合四大读书App资源
GitHub项目ebook-treasure-chest获2.2万Star,聚合帆书、微信读书、京东读书、喜马拉雅等读书App电子书下载链接。本文分析其价值、链接失效风险与版权边界,探讨资源聚合类开源项目的可持续性。