Prompt Caching 是什么?原理、场景与工程避坑指南

Prompt Caching 是跨请求的前缀 KV 复用优化,能省时省钱但有诸多工程坑。
Prompt Caching 是跨请求、跨用户、跨对话的 KV 复用优化,与单请求内的常规 KV 缓存不在一个维度。由于因果注意力机制中每个 token 的 KV 只依赖其前缀,因此只有前缀完全一致的提示词才能命中缓存。业界分闭源 API 精确前缀匹配与开源框架前缀树复用两条路线,核心价值是大幅降低首 token 延迟(70%-90%)和推理成本(命中 token 计费约原价 10%-30%)。文章还给出四类典型落地场景和四个易踩的坑,并总结了由浅入深的面试答题思路。
面试中被问到 Prompt Caching,很多人只能答出"把提示词缓存起来,省算力加快速度"这句表层回答。面试官一旦追问"它和 KV 缓存是一回事吗""具体缓存的是什么""哪些场景能用、哪些坑容易踩",当场卡壳的人不在少数。
B站 UP 主彭宇在一期大模型面试真题讲解中,把这道高频题从概念到落地再到踩坑完整拆解了一遍。下面结合他的讲解,把 Prompt Caching 的核心逻辑梳理清楚。
Prompt Caching 和 KV 缓存,根本不是一回事
最容易被混淆的问题,是 Prompt Caching 和常规 KV 缓存的关系。据 UP 主彭宇的分析,这两者压根不在一个维度上。
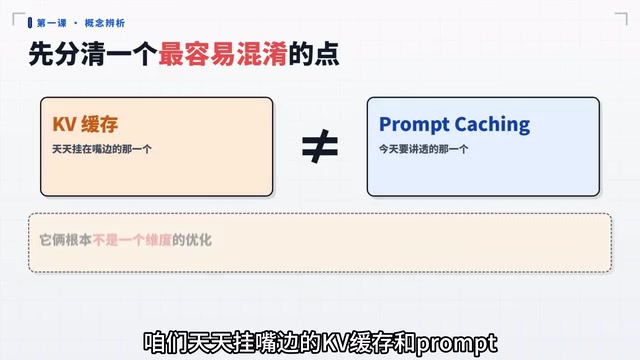
常规 KV 缓存是单请求内的优化。同一轮对话里,历史消息生成的 KV 不需要重复计算,只增量计算新输入的内容,服务的是单次对话的增量解码。
Prompt Caching 则是跨请求、跨用户、跨对话的优化。只要不同请求的提示词前缀完全一致,这部分对应的 KV 结果就能全局共享,不用每个人来了都从零算一遍。
一个是单次对话里省算力,一个是海量请求间复用算力,收益量级完全不同。
为什么必须是前缀匹配
答案藏在 Transformer 的因果注意力机制里。每个输入 token 经过自注意力层生成对应的 Key 和 Value 向量,而因果注意力有个关键规则:每个 token 的 KV 只和它前面的所有 token 相关,跟后面的内容无关。
所以只要两段提示词的前缀完全一样,生成的 KV 就完全一样,自然可以直接复用。
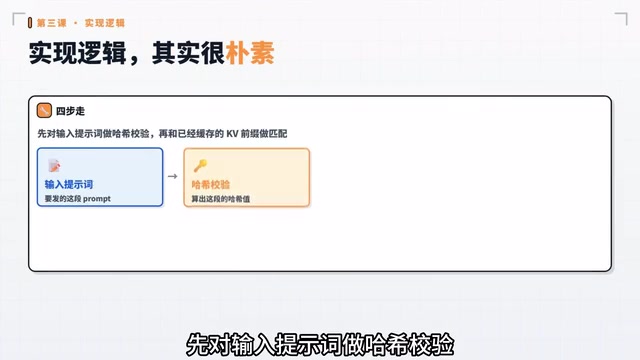
实现逻辑并不复杂:先对输入提示词做哈希校验,和已缓存的 KV 前缀做匹配,命中就直接跳过这部分 Transformer 计算,现成的 KV 拿来就用;只有后面不一样的后缀部分才走推理计算,生成新的 KV 再拼到缓存后面。
**因果注意力(Causal Attention)**是 Transformer 解码器的核心机制,也是 Decoder-only 架构(如 GPT 系列)能逐 token 生成文本的基础。它在自注意力计算时加了一个下三角掩码:位置 (i) 的 token 只能「看见」位置 (0) 到 (i) 的 token,无法看到后面的内容。这就保证了对第 (i) 个 token 而言,它生成的 Key 和 Value 向量只取决于前缀 ([0, i]),与后续 token 无关。正是这个「只看前面」的特性,让两段前缀完全相同的提示词在相同位置得到完全相同的 KV,成为 Prompt Caching 能安全复用 KV 的理论前提。反过来,如果模型用的是双向注意力(如 BERT 编码器),每个 token 的表示都会受全文影响,前缀 KV 就无法独立复用,这也是 Prompt Caching 主要出现在生成式大模型而非编码模型上的根本原因。
**前缀树(Prefix Tree / Trie)**是开源推理引擎做更细粒度 KV 复用时的常用数据结构。相比简单的整段前缀哈希匹配,前缀树把缓存的 KV 按 token 序列组织成树形:每个节点对应一段公共 token 前缀,分支对应后续不同的内容。多个请求只要共享任意长度的公共前缀,就能在树上命中对应节点,复用该路径上的 KV,而不要求两段提示词前缀整段完全一致。这种结构能显著提升多用户、多模板混合场景下的缓存命中率,但也带来节点管理、内存碎片和淘汰策略(如 LRU 配合引用计数)的复杂度。vLLM 的 Automatic Prefix Caching 和 SGLang 的 RadixAttention 都是这一思路的工程实现。
业界两条落地路线
目前 Prompt Caching 的业界落地主要分两条路线:
闭源 API 侧,主流大模型服务商基本都原生支持,采用精确前缀匹配机制。命中缓存的 token 计费通常只有原价的 10% 到 30%,长上下文场景能省下大量成本。
开源框架侧,vLLM、SGLang 这些主流推理引擎都实现了跨请求 KV 复用,部分还支持更细粒度的前缀树匹配,搭配 LRU、TTL 等缓存淘汰策略,平衡显存占用和命中率。
核心价值:省时间也省钱
Prompt Caching 的价值集中在两点。
大幅降低首 token 延迟。 长文档问答、带复杂工具的 Agent 这类长 prompt 场景,前缀命中缓存后可以跳过数千甚至上万 token 的计算,首 token 速度通常能提升 70% 到 90%,交互体验的提升非常直观。
显著降低推理成本。 对模型服务商来说,单块 GPU 能承载更多请求,直接提升吞吐;对 API 调用方来说,缓存命中的部分计费更低,模板化调用、RAG 这类高频场景整体成本能降一半以上。
做过批量推理的同学应该有体感:长提示词任务的算力大头全在公共部分,缓存相当于把这部分固定成本摊薄到无数次请求里,性价比一下就拉开了。
四个典型落地场景
以下场景在面试中说出来,能直接体现落地经验:
- 带固定系统提示的对话服务:角色设定、输出规范、安全规则全局统一前置,几乎百分百命中缓存。
- RAG 知识库问答:文档内容放前缀,用户问题放最后,文档部分直接缓存,每次只计算用户的新问题。
- 工具调用型 Agent:固定的工具列表和调用格式前置,天然适合缓存。
- 批量标准化处理:批量内容审核、翻译、信息分类等场景,指令模板完全一致,模板部分可以全量缓存。
四个容易踩的坑
这部分是面试官最爱追问的深水区,能答出来才算真懂。
匹配要求苛刻。 主流方案都是字符级精确匹配,多一个空格、换个标点、调一下段落顺序,都会直接命中失败。
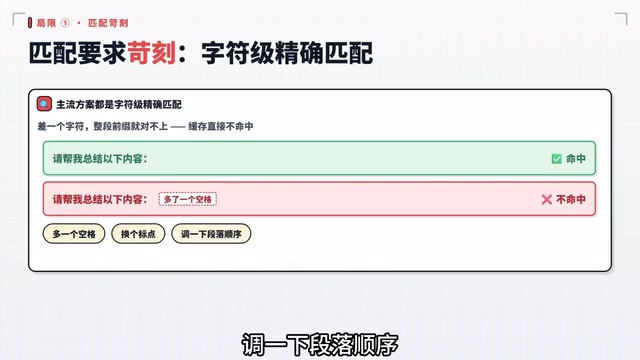
落地必须做好 prompt 标准化治理。很多团队刚上线缓存时命中率低得可怜,大概率就是没做规范,提示词写得太随意。
仅支持前缀匹配。 只有放在最前面的重复内容才能复用,中间或后缀重复没用。工程上要遵循"固定内容前置,动态内容后置"的原则。
显存占用需要权衡。 缓存存在 GPU 显存里,无限制缓存会挤占推理可用显存,反而影响并发量,需要配套合理的冷热淘汰策略。
语义缓存要慎用。 业界有尝试用语义相似匹配提升命中率,但容易导致注意力偏移、输出质量下降,目前工业落地仍以精确匹配为主。
LRU 与 TTL 是缓存淘汰的两种常见策略,直接决定显存占用与命中率的平衡。LRU(Least Recently Used,最近最少使用)按访问时间淘汰:一段时间内没被命中的缓存块优先被释放,适合访问有明显冷热分布的场景。TTL(Time To Live,存活时间)给每个缓存块设定有效期,超时即回收,适合内容更新频繁、过期数据复用价值低的场景。推理引擎中常将两者结合,并配合引用计数——正在被某个请求使用的缓存块不能被淘汰。选择不当会带来两类问题:淘汰太激进则命中率骤降,缓存形同虚设;淘汰太保守则显存被占满,反而挤压并发推理的可用空间。工程上需要根据 prompt 模板的复用频率、文档更新节奏来调参。
语义缓存(Semantic Caching) 指不要求字符级完全一致,而是用向量相似度判断两段提示词「意思相近」就复用结果。它理论上能提升命中率,但风险很高:一是语义相似不等于 KV 可复用,因果注意力下不同 token 序列生成的 KV 本就不同,强行复用会导致注意力分布偏移,输出质量下降;二是可能把本应区别对待的请求误判为相同,带来安全和正确性问题。因此工业界主流仍坚持精确前缀匹配,语义缓存更多停留在探索阶段。
首 token 延迟(Time To First Token, TTFT) 是大模型推理最关键的体验指标之一,指从发出请求到收到第一个输出 token 的时间。它主要由「预填充(prefill)」阶段决定——模型需要先把整段输入提示词编码成 KV。提示词越长,预填充计算量越大,TTFT 越高。Prompt Caching 命中后跳过的正是这段预填充计算,因此对长文档问答、Agent 等长 prompt 场景的 TTFT 改善尤其显著,用户能直观感到「秒回」而不是「卡半天」。
面试答题思路
把上面的内容串起来,就是一套由浅入深的答题逻辑:
先给出核心定义——它是跨请求的 KV 复用优化;再区分它和常规单请求 KV 缓存的区别;接着讲底层原理和主流实现;然后举几个落地场景;最后补充局限性和工程注意点。
这套逻辑走下来,面试官能听出来你不是只背了概念,而是真的有理解、有思考。
相关推荐

@ai-sdk/vue 3.0.306 补丁发布 同步 [email protected] 更新
@ai-sdk/vue 3.0.306 发布,与 [email protected] 同步更新。这是 Vercel AI SDK 生态的一次常规补丁发布,无公开 API 变更,Vue 适配层保持与核心包版本对齐。

Gemini 4 Argon API发布:百万级输出Token时代来临
Google 正式发布 Gemini 4 Argon,稀疏 MoE 架构支持最高 100 万输出 token,Vals Index 以 68.90% 登顶,覆盖 API、AI Studio 和 Gemini 应用三端。

DukaanAI:用开源AI把商品照片变成库存清单
DukaanAI 是一款面向小零售商的 AI 库存工具,通过 Gemma 3 开源模型将商品照片转为库存条目,支持本地推理、字段编辑与 CSV 导出,探索 AI 辅助商品目录创建的可行路径。