Prompt缓存实战:稳定内容放前面,别为重复Token付两次钱

将稳定内容置于提示词前端,是让LLM Prompt缓存真正生效、大幅降低API成本的核心原则。
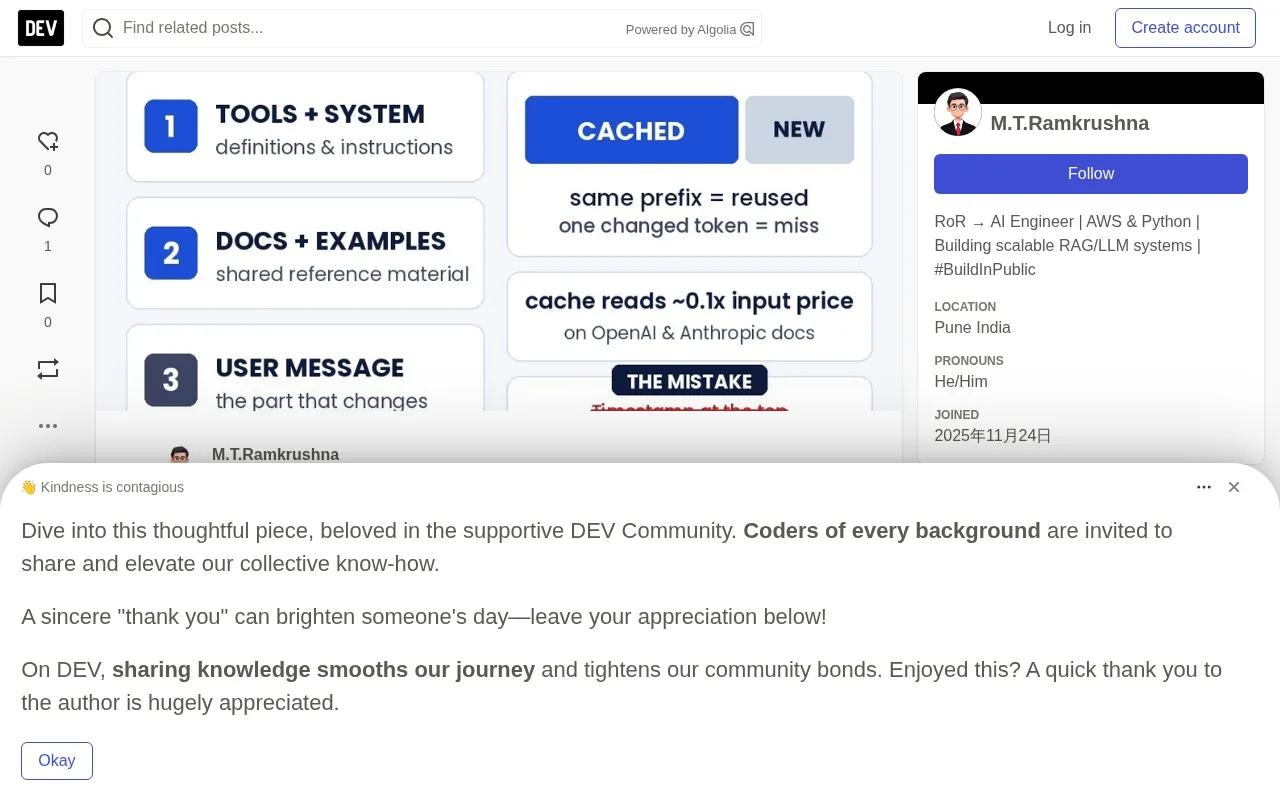
本文系统讲解了LLM服务商提供的Prompt缓存机制:其本质是复用提示词不变前缀的KV计算状态,缓存读取费率仅为正常输入的0.1倍,能同时降低成本与首Token延迟。要让缓存命中,必须遵循"稳定内容前置、动态内容后置"的构建顺序——依次为工具定义、系统提示、参考文档、对话历史,最后才是含时间戳等动态信息的用户消息。最常见的失效原因是将时间戳写在系统提示开头,导致每次请求前缀都不同;此外,工具顺序变化、JSON键序随机化同样是隐蔽的缓存破坏者。由于缓存失败完全静默,必须通过`cached_tokens`等字段主动监控,才能确认优化实际生效。
大多数LLM应用在每次请求时都会发送相同的几千个Token:工具定义、系统提示、一段参考文档、几个示例。真正变化的往往只有末尾那几百个Token——用户的实际提问。如果不做缓存,你就得为重新处理这段完全相同的前缀支付全额输入费用,一遍又一遍。
Prompt缓存(Prompt Caching)正是为解决这个问题而生,但前提是你得按正确的顺序构建提示词。本文最值得记住的一条原则就是:稳定的内容放前面,变化的内容放最后。
缓存到底缓存了什么
当模型读取你的提示词时,它会为每个Token计算中间的键值(KV)状态。Prompt缓存保存的,正是可复用前缀(即提示词开头那些不变的Token)的这些状态。如果你的下一次请求以完全相同的前缀开头,服务商就会复用已保存的计算结果,只处理新增的部分。
这里的关键词是完全相同。OpenAI和Anthropic都是基于渲染后的完整前缀进行匹配的。只要顶部有一个Token发生变化,其后的所有内容都会缓存未命中。
可以把它想象成一本厚书里的书签:模型能直接跳回上次读到的地方,但前提是没人改写过前面的内容。
KV缓存(Key-Value Cache)是Transformer架构中注意力机制的核心组成部分。模型在处理每个Token时,会为其生成Key和Value两个向量,用于计算后续Token与前文的注意力权重。在自回归生成过程中,这些向量本可以复用,但每次新请求都从零重新计算整个前缀的KV状态,会造成大量重复运算。Prompt缓存的本质,就是将这份计算结果持久化存储在服务商的推理基础设施中(而非用户端),使后续请求在前缀匹配时可以直接跳过这段计算。这也解释了为什么最小Token阈值(OpenAI为1024个Token)的存在有其意义——前缀过短时,缓存的调度开销会超过节省的计算量,缓存反而得不偿失。
为什么值得关注
来自服务商官方文档的数据很有说服力:
- Anthropic: 在大多数Claude模型上,缓存读取的计费为基础输入价格的0.1倍。写入默认的5分钟缓存费用为1.25倍,1小时缓存为2倍。5分钟缓存每次被使用时会免费刷新。
- OpenAI: 支持的模型默认开启缓存。在GPT-5.6及以后版本,缓存写入费用为1.25倍、读取为未缓存输入费率的0.1倍,可缓存的最小前缀为1024个Token。OpenAI官方给出的实例:一次写入加上九次完整读取,总成本为前缀输入价格的2.15倍——而没有缓存时则需要10倍。
除了省钱,缓存还能缩短首个Token的响应时间(time-to-first-token),因为模型跳过了对长前缀的重新处理。
让缓存生效的排序方式
每次请求都应按以下顺序构建:
- 工具与系统提示。 这些极少变动。在Anthropic上,缓存的层级结构明确为先
tools、再system、最后messages。 - 共享参考资料。 文档、政策条款、few-shot示例,或者你要提问的一份长合同。
- 对话历史。 追加新的轮次,不要改写旧的内容。
- 新的用户消息及任何动态内容。 时间戳、用户名、每次请求特有的上下文。
这个顺序背后的逻辑简单直接:变化频率越低的内容越靠前,缓存命中的概率就越高。
几乎所有人都会犯的错误
最常见的错误,就是把动态内容放在了顶部。经典案例是系统提示以Current date and time: 2026-10-12 09:04:31这样一行开头。这一行每次请求都在变,于是前缀永远匹配不上,你永远拿不到缓存命中。
Anthropic的文档还描述了同一陷阱的更糟糕版本:如果你把cache_control放在了包含时间戳和用户消息的块上,那么你会在每次请求时都触发一次全新的缓存写入,却从来读不到缓存。把断点(breakpoint)移到最后一个保持不变的块上,之后的每次请求就都能从缓存读取。
文档中还列出了其他一些悄无声息的缓存破坏者:
- 改动工具的名称、描述、Schema,或它们的顺序。
- 某些语言在序列化工具调用时会随机化JSON键的顺序(Anthropic特别点名了Swift和Go)。
- 切换会被渲染进提示词的设置,例如
tool_choice、图片,或推理/思考相关设置。 - 对历史记录做摘要或压缩,这会改写前缀。
JSON键顺序随机化是一个值得特别警惕的工程细节。在Python中,dict自3.7起保证插入顺序,json.dumps的输出是稳定的;但在某些语言的标准库实现中,map或struct序列化为JSON时的键顺序并不确定。Anthropic的SDK文档点名了Swift(Encodable协议不保证顺序)和Go(encoding/json对map的序列化按字母序排列,但struct字段顺序由定义决定,不同版本或反射调用可能产生差异)。实践中的解法是:使用能保证序列化顺序的自定义编码器,或在构建工具定义时使用有序数据结构,并在上线前通过对比两次相同请求的原始报文来确认工具定义的字节级一致性。
代码中的样子
Anthropic的做法是在稳定部分的末尾设置一个显式断点:
response = client.messages.create(
    model="<your-claude-model>",
    max_tokens=1024,
    system=[
        {"type": "text", "text": "You are a support assistant for Acme..."},
        {
            "type": "text",
            "text": "<full product docs and policy here>",
            "cache_control": {"type": "ephemeral"},  # 缓存到此为止
        },
    ],
    messages=[
        {"role": "user", "content": f"(sent at {now}) {user_question}"},  # 动态内容,置于断点之后
    ],
)
print(response.usage)  # 查看 cache_read_input_tokens / cache_creation_input_tokens
OpenAI在支持的模型上无需任何代码改动即可实现基础缓存。保持前缀稳定,并检查usage.input_tokens_details.cached_tokens来确认它是否生效。
要验证,别想当然
缓存失败是静默的。一个长度低于最小限制的提示词根本不会被缓存,而且不会报任何错误。所以必须去测量:
- Anthropic: 关注
cache_read_input_tokens和cache_creation_input_tokens。如果两者都为0,说明什么都没缓存上。 - OpenAI: 关注
usage.input_tokens_details.cached_tokens,以及Prompt Caching仪表盘。
一个实用建议是:每天追踪一个简单的比值——缓存Token数除以总输入Token数。如果某次部署后它突然下降,那大概率是有人往前缀里塞了动态内容。
快速检查清单
- 工具和系统提示放最前,每次调用都保持一致
- 文档和示例紧随其后
- 用户输入、时间戳、每个用户的个性化数据放最后
- 永远不要重排工具,也别让JSON键的顺序打乱
- 把断点设在最后一个永不变化的块上
- 每次改动提示词后,都盯一眼缓存Token相关字段
在你花一周时间精简提示词以降低成本之前,先确认你究竟有没有拿到缓存命中。重排顺序,通常是更便宜的那个解法。
相关推荐

AI数字分身实战:用DOT自动追踪Bug与用户反馈
DOTS 团队工程师演示如何用 AI 数字分身 DOT 跨平台收集用户反馈、自动归类问题主题、开线程调查 Bug 根因并直接提交 PR,展示 AI 代理参与缺陷分诊的完整工作流与可审计设计。

晶体管为何不再扁平?从平面到环绕栅极的演进
晶体管从平面到FinFET再到环绕栅极的演进:为何栅极需要从三面包裹到四面环绕,以抑制短沟道效应和泄漏电流,延续摩尔定律。

蜂群思维=单个RL智能体?多臂老虎机等价性证明
一篇论文证明蜂群通过局部模仿进行的集体决策,在数学上等价于单智能体强化学习。N个盲目模仿者相当于N个并行环境采样,有效学习率为1/N。本文解读Maynard-Cross Learning算法的推导与影响。