PTC-Bias:用音素级时间竞争提升语音大模型的稀有词识别

PTC-Bias用音素级时间竞争两阶段框架,在大规模偏置词表下高效提升语音大模型的稀有词识别准确率。
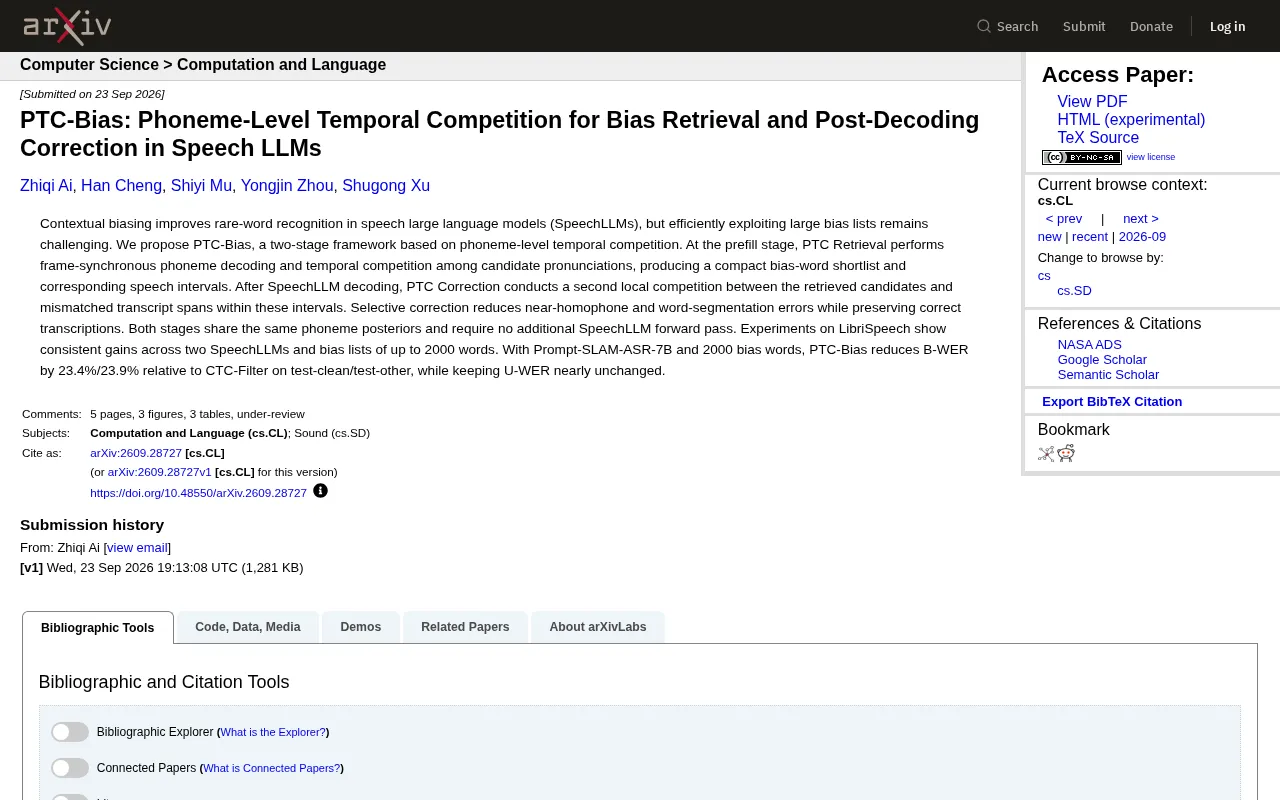
语音大模型在识别专有名词、人名地名等稀有词时准确率偏低,上下文偏置是主流补救手段,但词表规模扩大到数百乃至两千条时,传统方法面临计算开销与误召回的双重困境。PTC-Bias 框架将流程拆分为两阶段:预填充阶段用帧同步音素解码让候选词在时间轴上展开竞争,筛出紧凑短名单并定位语音区间;解码完成后再对不匹配片段做选择性局部纠正,专攻近音词和分词错误。两阶段共享同一套音素后验概率,无需额外调用 SpeechLLM 进行前向推理。在 LibriSpeech 2000 词偏置场景下,B-WER 相对基线降低约 23%,而 U-WER 基本不变,实现了稀有词提升与普通词准确率的两全。
语音大模型(SpeechLLM)在通用语音识别任务上表现强劲,但面对专有名词、生僻术语、人名地名这类稀有词时,识别准确率往往大幅下滑。上下文偏置(Contextual Biasing)是解决这一问题的主流思路——给模型提供一份候选词表,帮助它优先考虑这些词。可当偏置词表规模膨胀到成百上千个条目时,如何高效地利用这份长列表就成了棘手难题。arXiv 最新一篇论文提出的 PTC-Bias 框架,给出了一种基于音素级时间竞争的两阶段解法。
稀有词识别为何是个硬骨头
语音识别系统对高频词的建模非常充分,但稀有词由于训练语料中出现次数少,模型缺乏足够的统计支撑,容易识别错误。上下文偏置通过外部词表注入先验信息,理论上能改善这一情况。
问题在于扩展性。当偏置词表只有几十个词时,逐一比对成本不高;一旦词表扩大到 2000 个词,传统方法要么带来沉重的计算开销,要么因为候选空间过大而误召回大量无关词,反而拖累了原本正确的识别结果。论文正是瞄准了「如何在大规模偏置词表下既准又快」这一痛点。
上下文偏置(Contextual Biasing)在工程实现上主要有两种路线:一是基于注意力机制的方法,将候选词编码后与声学特征做交叉注意力,允许模型"看到"偏置词表;二是基于前缀树(Prefix Tree / Trie)的解码时干预,在波束搜索过程中对命中候选词的路径施加额外分数奖励。前者灵活但计算代价随词表规模线性增长;后者轻量但依赖字符或子词粒度的匹配,容易被读音相近却拼写不同的词干扰。传统 ASR 系统中还有一种更轻量的"热词权重"做法,直接在语言模型分数上叠加偏置项,但这类方法对语义上下文感知有限,在大模型时代效果已明显不足。PTC-Bias 的创新之处在于把竞争粒度下沉到音素层,绕开了子词粒度匹配的歧义问题,同时通过时间对齐将搜索范围限定在特定帧段,从而在不依赖解码树的情况下实现高效过滤。
PTC-Bias 的两阶段设计
PTC-Bias 的核心思想是音素级时间竞争(Phoneme-Level Temporal Competition),并将整个流程拆分为检索和纠正两个阶段。
第一阶段:PTC 检索
在预填充(prefill)阶段,PTC Retrieval 执行帧同步的音素解码,让各个候选词的发音在时间轴上展开竞争。通过这种时间维度上的竞争机制,系统能够筛选出一份紧凑的候选偏置词短名单,并同时定位到这些词对应的语音区间。
这一步的价值在于「先做减法」——不是把整份 2000 词的列表直接塞给大模型,而是先用轻量的音素后验概率过滤出真正可能出现的词,大幅压缩后续处理的搜索空间。
音素后验概率(Phoneme Posterior Probability)是语音识别系统在每一帧输出的、对应各个音素的归一化概率分布,通常来自 CTC(Connectionist Temporal Classification)或混合声学模型的输出层。帧同步解码则是指在时间轴上逐帧推进、维护活跃假设路径的解码方式,与批量的"先跑完全句再打分"的方式相对。利用帧同步解码对候选词做音素展开,本质上是把每个词的发音序列投影到时间轴上,查看它在哪些帧区间内与声学信号最匹配。这一操作的计算复杂度主要取决于音素词典的大小和候选词数量,而非 SpeechLLM 的参数量,因此即便词表有 2000 条,对整体推理延迟的冲击也远小于额外调用一次大模型。
第二阶段:PTC 纠正
当 SpeechLLM 完成解码、输出初步转写结果后,PTC Correction 会在此前定位的语音区间内,对检索到的候选词与转写文本中不匹配的片段进行第二轮局部竞争。
这种选择性纠正的设计颇为巧妙:它专门针对近音词(near-homophone)和分词错误(word-segmentation errors)这两类高发问题,只在确有必要时才动手修改,从而避免破坏那些原本已经正确的转写内容。
关键优势:零额外前向计算
PTC-Bias 的一个重要工程亮点是两个阶段共享同一套音素后验概率,且不需要额外的 SpeechLLM 前向传播。
这意味着无论是检索还是纠正,都不用重复调用体量庞大的语音大模型进行推理。对于部署成本敏感的场景来说,这一点极具吸引力——在几乎不增加模型推理负担的前提下,就能获得偏置能力的提升。这也是该方法相比部分需要多次前向或重新解码的方案的差异化所在。
实验结果:大词表下的稳定增益
论文在 LibriSpeech 数据集上进行了验证,覆盖两种不同的 SpeechLLM,偏置词表最大规模达到 2000 词。结果显示 PTC-Bias 在各种设置下都能带来一致的性能提升。
具体到量化指标,使用 Prompt-SLAM-ASR-7B 模型、配合 2000 词偏置列表时:
- 在 test-clean 测试集上,B-WER(偏置词错误率)相对 CTC-Filter 基线降低了 23.4%;
- 在 test-other 测试集上,B-WER 相对降低 23.9%;
- 同时,U-WER(非偏置词错误率)基本保持不变。
B-WER 大幅下降而 U-WER 稳定,恰好印证了 PTC-Bias 「选择性纠正」设计的初衷:在提升稀有词识别的同时,没有以牺牲普通词的准确率为代价。这种「只补短板、不伤长板」的特性,对实际生产系统尤为关键。
B-WER(Biased Word Error Rate)和 U-WER(Unbiased Word Error Rate)是上下文偏置研究中常用的拆分指标,分别衡量偏置词表中的词和词表之外的词各自的识别错误率。使用这两个指标而非整体 WER,是为了更细粒度地观察偏置方法是否真正提升了目标稀有词的识别,同时是否引入了副作用——即把原本能正确识别的普通词误改成了偏置词表中发音相近的词(过触发,over-triggering)。U-WER 保持稳定是衡量一个偏置方案是否"克制"的关键信号:过于激进的偏置往往能拉低 B-WER,却会同时推高 U-WER,导致整体 WER 改善有限甚至倒退。LibriSpeech 作为标准英文朗读语音基准,其 test-clean 和 test-other 两个子集分别代表录音质量较好和背景噪声较多的场景,在两者上同时验证有助于评估方法的鲁棒性。
对行业的意义
随着语音大模型逐步走向语音助手、会议转写、医疗与法律等垂直领域的落地,稀有词与领域专有名词的准确识别成为绕不开的门槛。PTC-Bias 提供的思路——用轻量的音素级信号在大模型之外完成检索与纠正——为大规模上下文偏置提供了一条兼顾效果与效率的路径。
需要注意的是,当前实验主要基于英文 LibriSpeech 数据集和特定的 SpeechLLM,方法在中文等其他语言、真实嘈杂环境以及更大偏置词表下的表现,仍有待更多验证。但从公开数据来看,这一框架在稀有词识别的效率与精度平衡上,展示了值得关注的潜力。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。