Python+AI零基础入门:从语法到大模型API实战全路径

面向普通人的AI时代Python学习路线:四阶段规划与正确的AI工具使用姿势
文章以DeepSeek等低成本大模型降低AI开发门槛为切入点,论述为何普通人应选择Python作为AI入局的起点——超过80%的AI应用基于Python,其语法简洁、生态丰富、社区庞大的三重优势使其成为绝对主导。文章梳理了一条四阶段学习路线:环境搭建→核心语法→AI应用实战(重点是DeepSeek API调用)→爬虫实战,并覆盖AI应用、数据分析、Web后端等主流方向。文章最值得借鉴的洞察在于AI工具使用时机的判断:基础语法阶段应手动敲代码以建立代码思维,实战阶段再借助AI提升效率,顺序颠倒则会导致基础空洞、项目遇变即卡壳。文章同时提示,课程描述带有营销色彩,从入门到真正交付企业级应用仍需大量实战积累,不存在速成捷径。
为什么AI时代普通人应该从Python入手
很多人每天都在使用AI,却只把它当成聊天、写文案、生成图片的娱乐工具,忽略了背后正在发生的产业变革。自GPT问世点燃全球AI浪潮后,国内文心一言、通义千问广告、讯飞星火、豆包等大模型接连登场,AI生态快速成型。而DeepSeek广告这类低成本高性能大模型的出现,又进一步把AI开发的门槛拉低,普通人也拿到了入场券。
企业落地AI并非做一个简单的聊天框,而是依靠大模型替代重复性工作,实现降本增效。大厂负责训练底层大模型,而数量庞大的中小企业急需会调用API、能开发业务AI工具的开发者——这恰恰是普通人的机会窗口。
据原视频引用的不完全统计,目前超过80%的AI应用与项目都基于Python开发,Python在人工智能领域已占据绝对主导地位。
Python成为AI首选语言的三个底层原因
Python能成为AI开发首选,并非偶然,可以归结为三点。
语法简洁,入门门槛低。 相比C++、Java等语言,Python不需要花大量精力纠结复杂语法,让初学者能把注意力放在逻辑本身,而不是语言细节上。
AI生态库极其丰富。 几乎所有主流的AI工具与框架都优先支持Python,从数据处理到模型调用,都有成熟的库可以直接使用,这大幅降低了AI应用的搭建成本。
社区庞大,资源充足。 遇到问题时,网络上有海量教程和开源项目可供参考,非常适合AI项目的快速原型开发。对于零基础学习者,这意味着踩坑时更容易找到解决方案。
Python的AI生态库中,有几个名字几乎贯穿所有项目:NumPy 和 Pandas 负责数值计算与数据处理,Matplotlib 用于数据可视化,Scikit-learn 覆盖传统机器学习算法,而 PyTorch 和 TensorFlow 则是深度学习模型训练的两大主流框架。在大模型应用层,LangChain 和 LlamaIndex 提供了将大模型与业务逻辑串联起来的"脚手架",Requests 和 FastAPI 则分别承担HTTP请求与后端接口搭建。正是这套高度分工、互相衔接的库生态,让开发者无需从零造轮子,几行代码就能调用大模型、处理数据、部署接口——这是其他语言在AI赛道难以竞争的核心壁垒。
一条清晰的四阶段学习路线
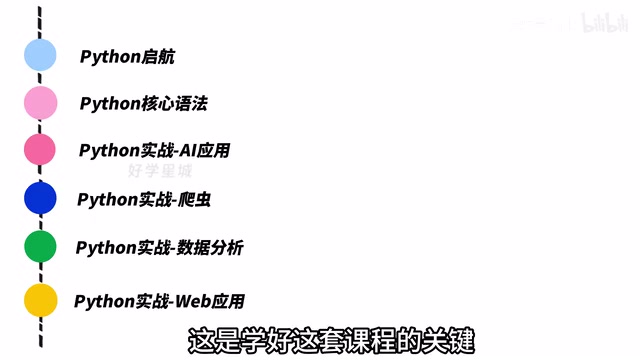
原视频将整套课程规划为四个循序渐进的章节,这套结构对自学者同样有参考价值。
第一阶段:Python启航
从搭建开发环境、熟悉编辑器开始,重点是避开新手安装环境时的各种报错坑,完成第一行代码,正式进入编程学习。环境配置往往是劝退第一关,提前规避这些问题能保住学习热情。
第二阶段:核心语法
系统学习变量、数据类型、运算符、流程控制、函数、面向对象等核心知识点。这是后续所有项目开发的地基,学完后应具备独立读写基础代码的能力。
第三阶段:AI应用实战(核心重点)
这是整套路线的重中之重。先讲解人工智能和大模型的基础原理,学习网络协议,再掌握DeepSeek大模型API调用。通过实战,学习者就具备了开发基础企业级AI应用的能力。对想入局AI开发的人来说,这一阶段才是真正的分水岭。
API(应用程序编程接口)调用是这一阶段的核心技能。大模型厂商将模型能力封装成API服务,开发者只需按照文档发送HTTP请求、传入提示词(Prompt),即可获得模型的文字、代码或结构化数据输出,无需自行部署动辄数百GB的模型权重。DeepSeek的API采用与OpenAI兼容的接口格式,意味着学会调用其中一家,切换到其他大模型厂商的成本极低。企业级AI应用的典型形态包括:自动生成报告、智能客服机器人、合同审查助手、代码审计工具等——这些本质上都是"业务逻辑 + 提示词工程 + API调用"的组合,而非需要从头训练模型的复杂工程。
第四阶段:爬虫实战
学习网络请求原理,并着重强调爬虫合规问题——分清哪些数据可以采集、哪些绝对不能碰。随后通过豆瓣电影榜单、壁纸采集等项目,完整掌握数据抓取、清洗、保存的流程。
整套路线覆盖了Python几乎所有主流应用方向,包括AI应用、爬虫、数据分析、Web后端开发。学完后若想继续深耕AI大模型微调、深度学习,或爬虫数据分析方向,也能据此规划后续技术成长地图。
爬虫合规边界在国内有明确的法律参照:2017年施行的《网络安全法》、2021年的《数据安全法》与《个人信息保护法》共同构成基本框架。实践中需关注几条红线:其一,robots.txt协议——网站根目录下的这份文件声明了哪些路径禁止爬取,违反虽不直接构成违法,但常被视为恶意访问的证据;其二,涉及用户个人信息(姓名、手机号、身份证等)的数据采集须有明确授权;其三,以高频请求冲击服务器、造成服务中断,可能触犯《刑法》第285条关于非法侵入计算机信息系统的条款。豆瓣电影榜单、公开壁纸等属于典型的合规练习场景,而社交平台用户数据、金融交易记录则属于高风险区域,初学者应主动回避。
关键的学习方法:什么时候该用AI,什么时候不该用
整套路线中最值得强调的,是关于AI工具使用时机的建议,这一点对零基础学习者尤为重要。
在前两个基础语法阶段,建议尽量不依赖AI编程工具,所有案例和练习都手动敲写代码。这个阶段的核心目标是理解语法逻辑、锻炼代码思维。如果基础阶段直接复制AI生成的代码,看似学得很快,但底层逻辑没吃透,后续项目稍有改动就会无从下手。
等进入实战项目阶段后,就可以合理借助AI工具提升效率,学习基于AI进行开发、调试bug、优化程序等技巧。原视频特别指出:课程教的是如何用AI辅助编程、解读代码、排查修复bug,但不鼓励直接复制AI生成的成品代码。
这个判断背后的逻辑是:未来优秀的开发者,是懂得利用AI工具快速落地项目的人,而不是把AI当成代做作业工具的人。先建立独立能力,再用AI放大效率,顺序不能颠倒。
适合哪些人以及现实预期
按原视频描述,这类学习路线主要面向四类人群:希望入行IT抓住AI风口的零基础小白;希望把AI用作副业、提升办公效率的技术爱好者;想转型AI应用开发赛道的在职人员;以及需要丰富毕业设计、竞赛、校招简历的在校大学生。
需要客观看待的是,这是一份偏向招生导向的课程介绍,其中对就业前景和副业收入的描述带有一定营销色彩。普通人确实能通过Python切入AI开发,但从入门到真正交付企业级AI应用,仍需要大量实战积累,不存在速成捷径。
真正值得采纳的,是其中朴素但正确的忠告:学编程不要只看视频,一定要动手敲代码。看懂不等于会写,只有亲手敲、亲自踩坑,才能把技术真正变成自己的能力。
相关推荐

M&M's斥资数百万换掉人工蓝色素,为什么这么难?
玛氏公司投入数百万美元,试图用螺旋藻天然色素替代M&M豆中的人工蓝色素,却因物料浓稠堵塞管道、残留物引发霉菌风险而被迫改造整条产线。本文解析这场配方迁移背后的工程难题、消费者与监管推力,以及"无人工色素不等于健康"的清醒判断。

Meta全球AI开发者黑客松组队需求:计算机视觉与医疗AI方向
Reddit开发者发帖为Meta Global AI Developer Hackathon招募队友,方向聚焦计算机视觉与医疗AI。本文分析这一组队信号背后的赛道逻辑、技能互补需求与黑客松选题策略。

Claude 多个模型报错:Fable 5.1、Sonnet 5.5、Haiku 5.5 故障复盘
Claude Fable 5.1、Sonnet 5.5、Haiku 5.5 及 Opus 5.5 fast mode 出现错误率升高,官方 17 分钟内完成定位与恢复。本文梳理故障时间线、多模型连带故障的技术原因,以及对开发者重试与降级策略的实际启示。