PyTorch张量从入门到实战:核心概念与操作全解析

系统梳理PyTorch张量的核心概念与高频操作,为搭建神经网络打牢地基。
本文基于一套PyTorch实战教程,系统梳理张量的核心概念与高频操作。首先澄清标量、向量、矩阵统一为张量,本质是带有形状的多维数据容器,用阶、轴、形状描述。接着论述将现实世界数据转化为张量的必要性。然后详细讲解张量的创建、CPU/GPU设备管理、NumPy与张量转换、广播机制、reshape只改形状不改数据、矩阵乘法的行乘列规则与matmul/bmm区别,以及换轴操作中transpose与permute的用法。文章强调理解这些基础操作比急于搭建模型更重要,并建议查阅官方API而非死记函数。
PyTorch构建神经网络的基础在于理解张量。很多初学者急于搭建模型,却忽略了张量这一数据容器的本质。本文基于一套完整的PyTorch实战教程,系统梳理张量的核心概念与高频操作,帮助你在动手写网络之前,先把地基打牢。
张量到底是什么?从标量到高维数据容器
教程开篇便澄清了一个关键认知:在PyTorch中,标量、向量、矩阵都可以统一称为张量。向量是一维张量,矩阵是二维张量,而张量本身可以理解为带有形状的多维数据容器。这个定义看似简单,却决定了后续所有操作的逻辑。
理解张量需要抓住三个基础概念。阶指的是张量有几个轴,几个轴就是几阶;轴则是每个方向上的维度,类似数学坐标系中的X轴、Y轴、Z轴;形状描述的是各维度上的大小。标量没有形状,因为它只有一个数;一个三维向量的形状为3;三行四列的矩阵形状为(3,4);形状为(2,3,4)的张量则可以理解为两个三行四列的矩阵叠在一起。
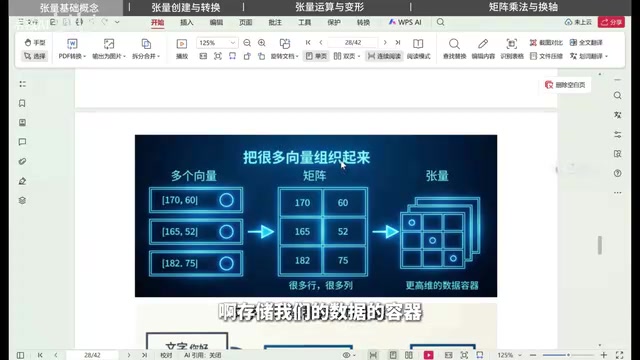
教程中反复强调一个理解方式:矩阵的本质是把很多向量放在一起,方便一次性计算。一个向量表示一个对象,比如人的身高体重、房子的面积楼层价格;多个对象就组成矩阵。如果还要表示不同班级的人,就需要引入班级这个新维度,于是自然过渡到三维张量。
为什么要把现实世界变成张量
这是教程中很有洞见的一段论述。现实中的文字、图片、车辆、道路、行人、红绿灯,模型本身是"看不到"的。模型跑在计算机里,计算机只认识数字。因此第一步必须把这些事物变成数字,模型才能进行计算、比较、判断和学习。
一个向量中,我们关心的不是数字本身,而是每个位置上的数字代表什么含义。对象越复杂,需要的特征越多,向量的维度就越高。把多个对象的向量组织成矩阵,再把多个矩阵组织成更高维的张量,这些容器最终服务于同一个目的:让数据更容易被计算。在深度学习和大型模型中,文字和图片都会被转换为数字,再变成张量,因为张量是模型统一处理数字的容器。
张量的创建与设备管理
创建张量的代码非常直观。定义一个标量只需传入单个数字;定义向量传入列表;定义矩阵传入二维数组;定义三维张量传入嵌套列表。教程给出了一个判断维度的小技巧:看左边开括号的数量,一个括号是一维,两个是二维,三个是三维。
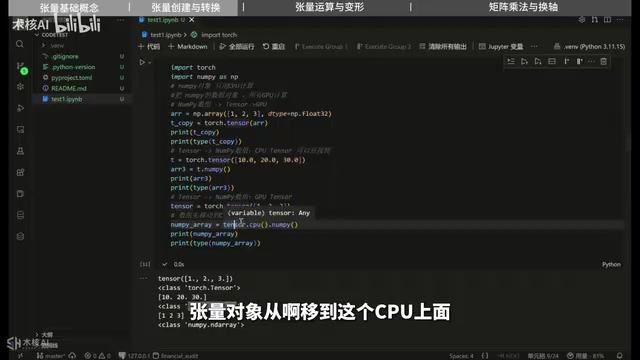
张量运算可以指定设备,通常有CPU和GPU两种选择。默认情况下张量在CPU上计算。若要使用GPU,先判断电脑是否安装了CUDA,然后通过.to(device)把张量放到对应设备上,或用.cuda()、.cpu()显式迁移。教程演示者的电脑只有CPU,因此data.cuda()会报错,这也提醒读者设备迁移需要硬件支持。
PyTorch还提供了类似NumPy的特殊张量创建方法:全零张量、全一全一张量、随机初始化张量、对角线为1的单位矩阵,以及直接调用Sigmoid、Tanh、ReLU等激活函数。教程特别提醒,这些函数不必死记,用到时查阅PyTorch API即可。
NumPy数组与张量之间的转换是常见操作。NumPy的ndarray只能在CPU上计算,若想用GPU处理这些数据,需要先转为张量再迁移到GPU。反过来,CPU上的张量可以直接调用.numpy()转换;GPU上的张量则必须先.cpu()再转换。
CUDA(Compute Unified Device Architecture)是NVIDIA推出的并行计算平台和编程模型,允许开发者利用GPU的数千个计算核心进行通用计算。在PyTorch中,torch.cuda.is_available()用于检测当前环境是否支持CUDA,即是否存在兼容的NVIDIA GPU及正确安装的驱动和CUDA工具包。若返回False,则所有试图将张量移至GPU的操作(如.cuda()或.to('cuda'))都会抛出运行时错误。因此,在编写跨设备代码时,通常先定义device = torch.device('cuda' if torch.cuda.is_available() else 'cpu'),再统一使用.to(device),以保证代码在有无GPU的环境下都能运行。
广播机制:形状不同也能运算
广播机制是张量运算中绕不开的规则。矩阵加法通常要求形状一致,但PyTorch允许在特定条件下自动扩展。比如形状为(3,1)的矩阵与形状为(1,2)的矩阵相加,前者会按后者的列数复制列,后者会按前者的行数复制行,最终都扩展为(3,2)再逐元素相加。同理,一个形状为(1,3)的向量与(2,3)的矩阵相乘时,向量会复制成两行,使形状对齐。
这套机制在NumPy前置课程中已有铺垫,PyTorch沿用了同样的设计哲学,理解一次即可迁移使用。
广播(Broadcasting)是NumPy引入的一种机制,PyTorch完整继承并用于张量运算。其规则可概括为:从尾部维度(最右侧)开始逐维比较,若两个维度相等或其中一个为1,则视为兼容;兼容时大小为1的维度会被扩展(逻辑上复制)以匹配另一维度的大小。例如形状(3,1)与(1,2)相加,尾部维度1与2兼容(1扩展为2),次尾维度3与1兼容(1扩展为3),结果形状为(3,2)。若某一维度既不相等也不为1(如3与4),则抛出错误。广播不会实际分配内存复制数据,而是通过步长(stride)为0的虚拟扩展实现,因此高效且节省显存。
reshape:只改形状,不改数据
reshape是写代码时高频使用的方法,核心语义是把同一组数据重新摆成新的形状。它只改变形状,不改变数据内容和排列顺序。
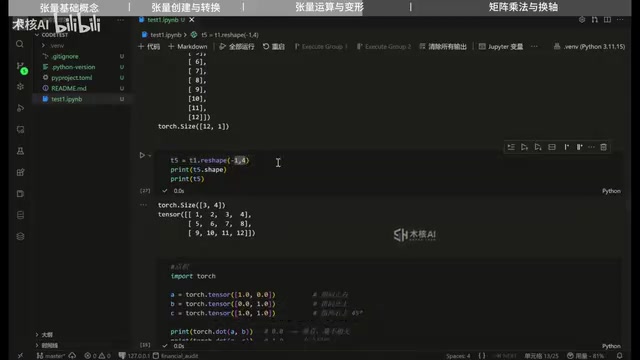
使用reshape有一条铁律:元素总数必须相同。12个元素的向量可以变成三行四列,也可以变成两行六列,但不能变成五行三列,因为后者需要15个元素,前后总数不等会直接报错。顺序重排也有规则:一维数组[1,2,3,4,5,6]变成两行三列时,第一行是1、2、3,第二行是4、5、6;变成三行两列时,则是1、2 / 3、4 / 5、6。
reshape还支持用-1作为占位符,表示该维度大小由PyTorch根据元素总数自动推断。传入(-1,4)时,PyTorch会用12除以4得到3,等价于reshape(3,4)。教程现场测试了两个维度都设为-1的情况,结果报错——只能有一个维度被推断,这一点值得初学者留意。
矩阵乘法:行乘列与批量运算
点积是两个向量之间的运算,调用dot方法,结果是一个标量。余弦相似度则由点积除以两个向量的模长乘积得到。转置是矩阵行和列互换,三行两列转置后变成两行三列。
矩阵乘法有严格的数学规则:若A的形状为(M,N),B的形状必须是(N,K),结果C的形状为(M,K)。教程用具体例子演示了"行乘列"的计算过程:结果矩阵第一行第一列的值,等于A的第一行与B的第一列对应元素相乘再求和;第一行第二列则用A的第一行乘B的第二列,依此类推。这一规则没有为什么,是数学定义,不满足就会报错。
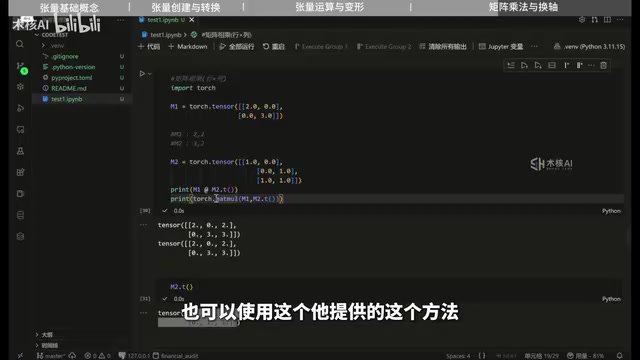
PyTorch提供两种矩阵乘法写法:@运算符和torch.matmul。教程演示了直接相乘形状不匹配的矩阵会报错,对其中一个矩阵转置后才能成功。
此外还有bmm方法,专为批量矩阵乘法设计,要求输入必须是三维张量。两个二维张量直接传给bmm会报错。教程建议日常矩阵乘法优先选择更通用的matmul,因为它对维度的兼容性更好。
torch.bmm(Batch Matrix Multiplication)要求输入为三维张量,形状为(b, n, m)和(b, m, p),输出为(b, n, p),即对每个批次独立执行二维矩阵乘法,批次间不共享数据。而torch.matmul(或@运算符)更通用:对于二维张量,它执行标准矩阵乘法;对于更高维张量,它将最后两个维度视为矩阵维度,前面的维度视为批次维度,并自动应用广播规则。例如形状(2,3,4)与(4,5)相乘,结果形状为(2,3,5)。因此,在需要处理批量数据或不确定维度时,matmul是更安全的选择;bmm则适用于明确的三维批量场景,且性能略优。
换轴操作:理解索引顺序的变化
换轴比前面的操作稍复杂。二维数组的换轴本质上就是转置,即行和列互换;向量只有一个轴,不存在换轴操作。轴的概念可以类比坐标系:矩阵的行是0轴,列是1轴,轴本质上描述的是索引的取数顺序。
以具体元素为例,某个值位于第2行第2列,索引为(1,1)。换轴之后,原来的行变成列、列变成行,同样一个元素现在需要用(1,0)来索引,取数顺序随之改变。这就是换轴改变索引顺序的含义。
PyTorch提供两种换轴方法:transpose和permute。transpose只能交换两个维度,而permute可以一次性按任意顺序重排所有维度。对于三维、四维张量的换轴,permute明显更方便。教程坦言三维及更高维的换轴理解起来会麻烦一些,但掌握二维转置的直觉后,向高维推广并不困难。
transpose(dim0, dim1)交换指定的两个维度,返回一个新的张量视图(不复制数据),但交换后张量在内存中可能不再连续(contiguous),此时调用.view()会报错,需先.contiguous()。permute(*dims)接受一个维度顺序的排列,一次性重排所有维度,例如对形状(2,3,4)的张量执行permute(2,0,1)得到形状(4,2,3)。两者都返回视图,修改视图会影响原张量。若需独立副本,应使用.clone()。理解换轴的关键是:它改变的是维度的顺序,从而改变索引元组的解读方式,但元素在内存中的物理排列可能保持不变(对于transpose)或按新顺序重新解释(对于permute)。
写在最后
这套教程覆盖了张量概念、创建、设备管理、广播、reshape、矩阵乘法和换轴等核心操作,几乎都是实战中每天都会用到的内容。对于想用PyTorch搭建神经网络的学习者来说,把这些基础打扎实,远比急着调用模型接口更有价值。遇到不熟悉的函数,查阅官方API文档是最高效的路径,不必死记硬背。
相关推荐
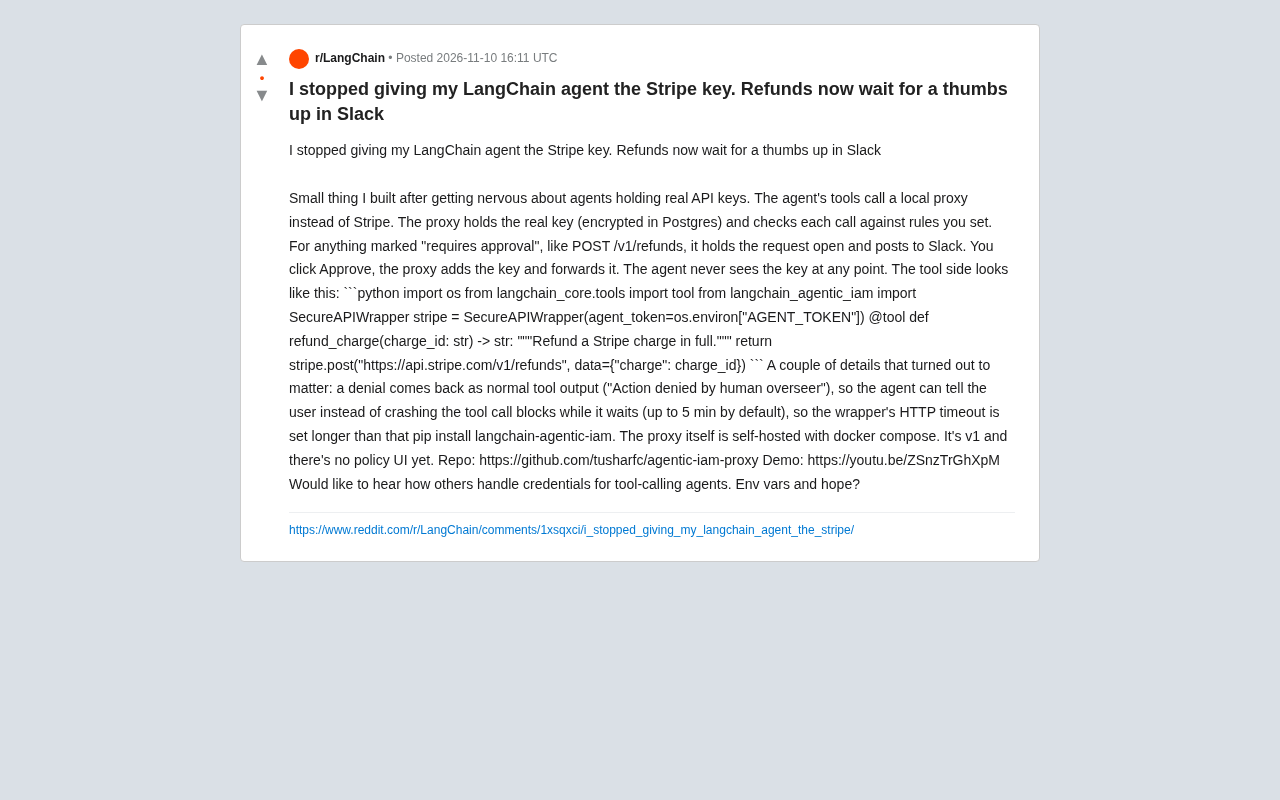
LangChain Agent 不再持有 Stripe 密钥:退款需 Slack 审批
开发者分享 LangChain Agent 凭证管理方案:Agent 不持有 Stripe 密钥,敏感操作如退款通过本地代理转发,并在 Slack 中人工审批后才执行,附代码示例与工程细节。
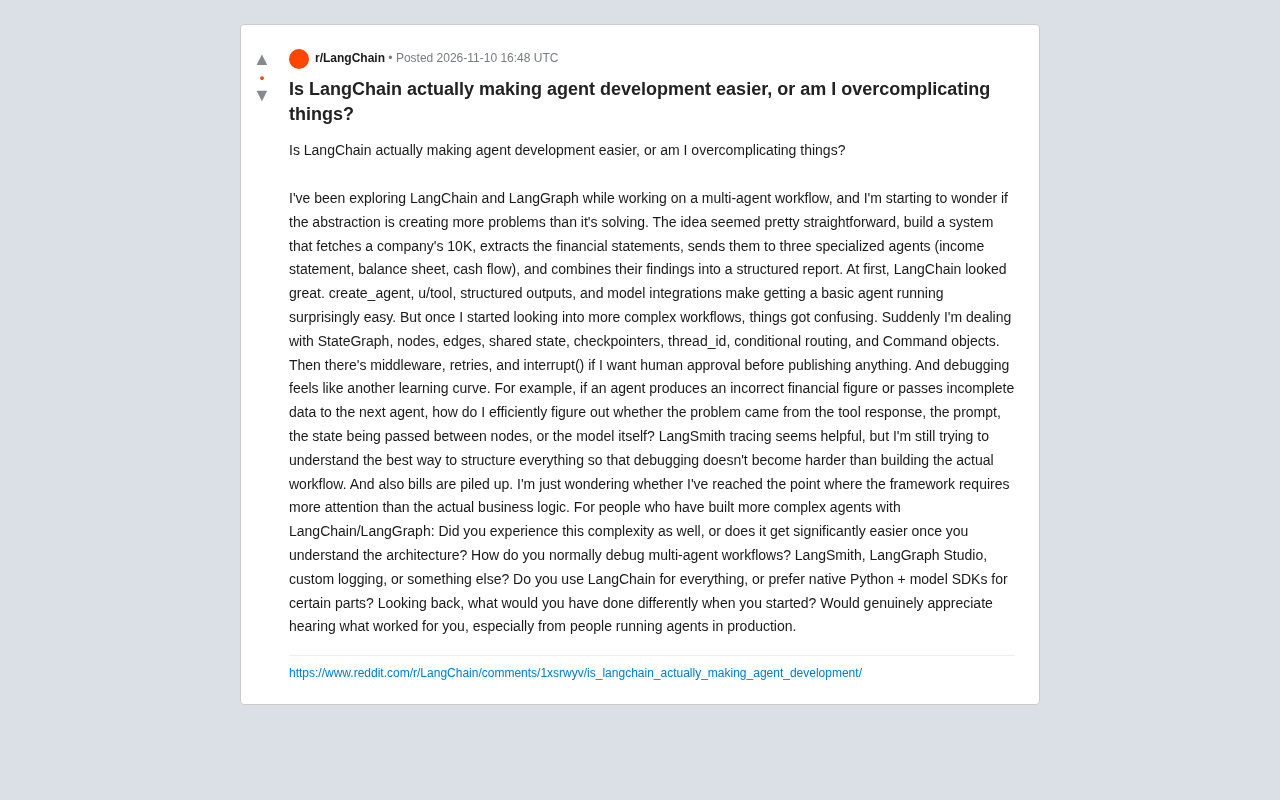
LangChain真让Agent开发更简单?开发者反思抽象代价
Reddit开发者反思LangChain与LangGraph在多智能体工作流中的抽象代价:入门容易,但StateGraph、状态管理、调试与成本控制带来新复杂度。讨论调试方法、是否混用原生Python+模型SDK,以及生产环境中的经验取舍。
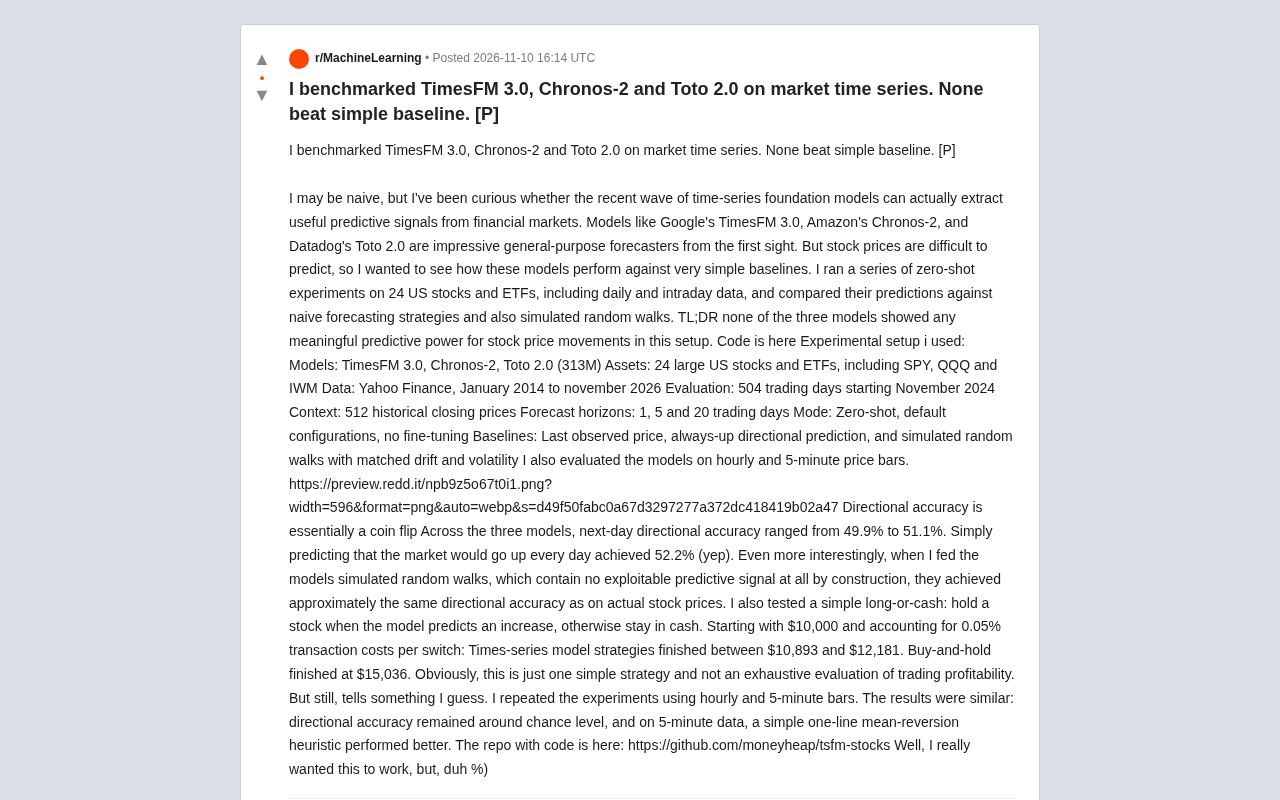
实测TimesFM 3.0、Chronos-2、Toto 2.0:时序大模型跑不赢简单基线
开发者零样本实测TimesFM 3.0、Chronos-2和Toto 2.0在24只美股及ETF上的预测表现,方向准确率仅49.9%-51.1%,模拟交易跑输买入持有策略,时序基础模型在金融数据上未展现超越简单基线的能力。