Q2D-Web:用1.9亿网页重构检索评测的真实性标准
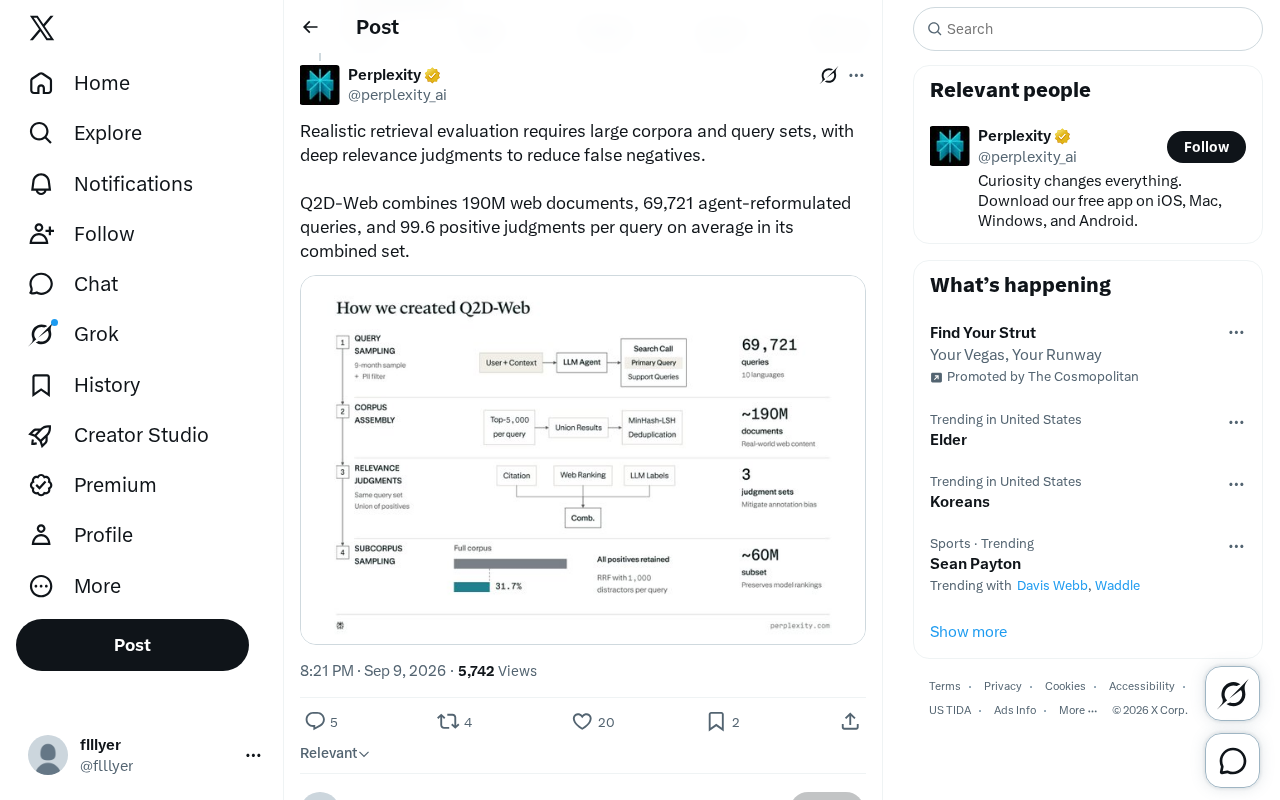
Q2D-Web 以1.9亿网页、近7万条查询和平均每查询近百个正例,为检索评测假阴性问题提供大规模解决方案。
信息检索评测长期因标注遗漏而存在假阴性偏差——系统检索到的正确文档因未被标注而被错误判为无关,导致评测结论失真。Q2D-Web 数据集针对这一痛点,构建了包含1.9亿网页文档的超大语料库,配合69,721条由智能体自动重构的多样化查询,并在组合集合中实现平均每条查询99.6个正相关性判断,标注密度远超传统数据集的个位数水平。Agent辅助的查询重构技术使得在亿级语料上进行深度标注在成本上成为可能。这一基准对检索模型与RAG系统的评测可靠性具有重要意义,但其完整构建方法与数据可用性仍有待更多官方资料确认。
检索评测为何需要更大的语料与查询集
信息检索系统的评测长期面临一个隐忧:测试集规模不够大、相关性判断不够深,导致模型明明检索到了正确文档,却因为标注遗漏而被判为“错误”。这类**假阴性(false negatives)**问题会系统性地低估检索质量,让不同方法之间的对比失去意义。
要让评测更贴近真实场景,需要三个条件同时成立:足够大的文档语料库、足够多样的查询集合,以及对每条查询进行深度相关性判断——不是只标注少数几个正例,而是尽可能覆盖所有真正相关的文档。只有这样,评测结果才能反映系统在真实开放网络环境中的表现。
Q2D-Web 的核心数据规模
根据该来源披露的信息,Q2D-Web 数据集正是围绕上述三个维度构建的。其规模指标包括:
- 1.9 亿(190M)网页文档构成的语料库,接近真实网络检索的量级;
- 69,721 条由 agent 重构(reformulated)的查询,覆盖多样化的检索意图;
- 在其组合集合(combined set)中,平均每条查询有 99.6 个正相关性判断。
这组数字中最值得关注的是“平均每查询 99.6 个正例”。传统检索评测数据集往往每条查询只有个位数的相关文档标注,Q2D-Web 将这一密度提升到近百个量级,直接针对假阴性问题下手。判断越密集,模型检索到的正确结果被“误判为无关”的概率就越低,评测的可信度也随之提高。
Agent 重构查询意味着什么
数据集中的查询由 agent 进行“重构”(reformulation),这是一个值得展开的设计选择。查询重构指的是将原始查询改写、扩展或规范化为更清晰、更能表达检索意图的形式。用 agent 自动完成这一过程,既能规模化生成近 7 万条查询,又能保持查询的语义质量。
这种做法反映了当前检索评测的一个趋势:借助语言模型与智能体能力,突破人工标注在规模和成本上的瓶颈。对于需要覆盖 1.9 亿文档的大型语料而言,纯人工构建查询与判断几乎不可行,agent 辅助成为让“深度相关性判断”落地的关键手段。
对检索与 RAG 研究的意义
更大的语料、更多的查询、更密集的正例判断,共同指向一个目标:让检索评测结果更接近生产环境的真实表现。这对当前火热的检索增强生成(RAG)和向量检索研究尤为重要——如果评测基准本身存在系统性偏差,那么基于它得出的模型优劣结论也可能不可靠。
Q2D-Web 这类数据集的价值在于提供一个更接近网络规模、且相关性判断更充分的测试床,帮助研究者更准确地衡量检索模型的召回与排序能力。
需要说明的是,本文基于单一来源的简要披露整理,关于 Q2D-Web 的完整构建方法、具体基准结果与数据可用性,仍有待更多官方资料补充确认。
相关推荐

34款AI编程助手混战终端,如何避免选错?
34款AI编程助手涌入终端,Orca工具支持多代理并行。本文分析淘金热背后的整合趋势、多代理并行的成本陷阱,以及如何保持代理中立的工作流,避免选错工具。

Gemini CLI实战:终端里的AI编程Agent
深入解析Gemini CLI:从安装认证到实战构建任务管理应用,涵盖计划模式、自动调试、GEMINI.md上下文持久化与token成本统计,帮助开发者用终端AI Agent提升编码效率。

Open Design:免费开源版Claude Design,激活你的编程智能体
Open Design 是一款免费开源的 Claude Design 替代品,本地运行,内置 250+ 设计技能,自动检测 16 种编程智能体,支持原型、幻灯片、移动端界面等设计任务。