Qdrant vs pgvector:向量数据库选型经验谈
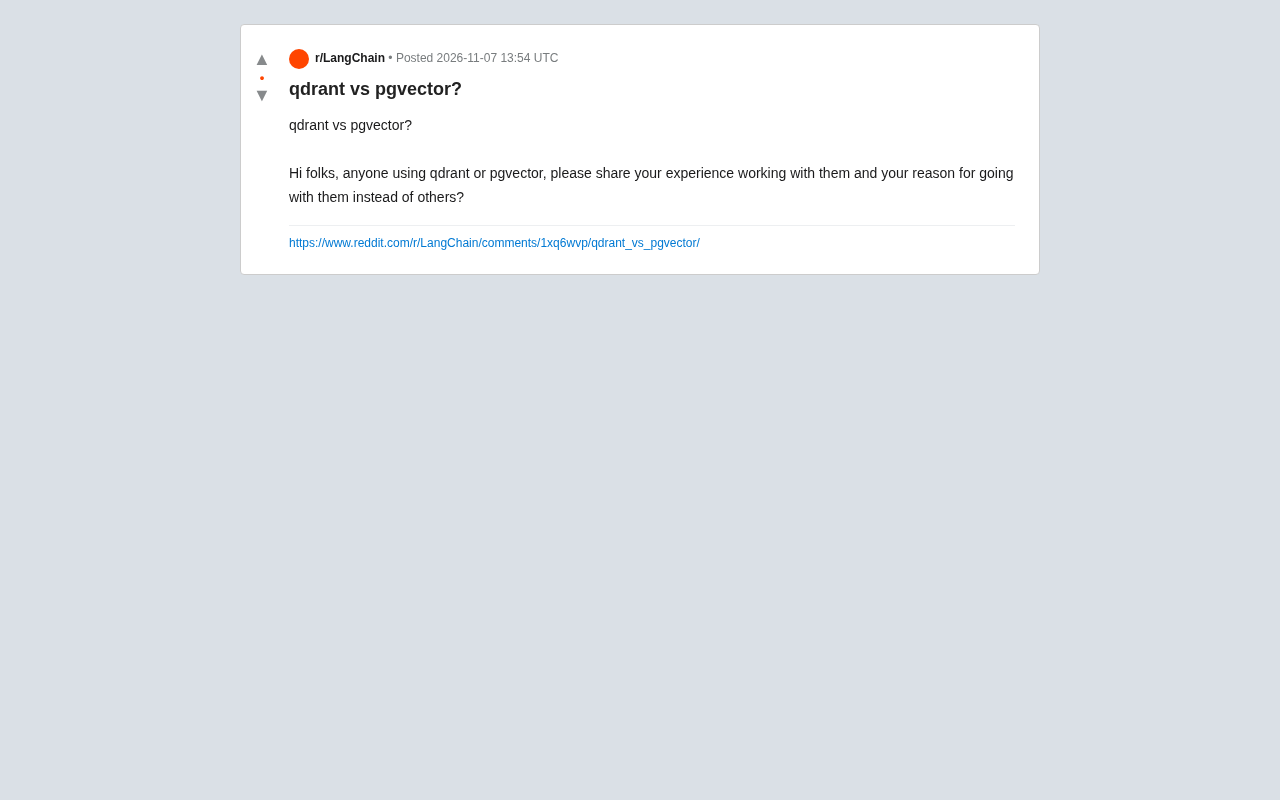
Qdrant 与 pgvector 选型取决于数据规模、查询复杂度与运维能力。
文章围绕 Reddit 开发者关于 Qdrant 与 pgvector 的提问,梳理了两种向量检索路线的取舍。pgvector 是 PostgreSQL 扩展,让向量与关系数据同表同事务,运维零新增组件,适合已有 Postgres 体系、数据量百万级以内、查询模式简单的早期业务。Qdrant 是专用向量引擎,索引与查询引擎为向量场景从头设计,支持原生 payload 过滤和水平扩展,在千万级数据、复杂混合查询和低延迟要求下更具优势。社区共识指出数据量、过滤查询能力和运维复杂度是三个关键分水岭。文章建议先用 pgvector 验证业务,待规模与 QPS 成为瓶颈后再评估迁移,并强调选型应量化自身数据规模、查询复杂度和团队运维能力。
为什么大家都在比较 Qdrant 和 pgvector
在 AI 应用开发中,向量检索几乎是绕不开的一环。RAG、语义搜索、推荐系统背后都需要一个能高效存储和检索向量数据的数据库。Reddit 上一位开发者发帖询问:"有人用过 Qdrant 或 pgvector 吗?请分享一下你们的使用体验,以及为什么选择它们而不是其他方案?"
这个问题戳中了很多人的痛点。向量数据库的选项越来越多,但落到实际工程中,讨论最集中的往往还是 Qdrant 和 pgvector 这两条路线——一个是专门为向量检索设计的独立数据库,一个是 PostgreSQL 的向量扩展。选择哪一个,本质上是"专用 vs 通用"的架构决策。
两条路线的本质差异
pgvector 的思路是把向量能力装进你已有的 PostgreSQL。如果你的业务数据本来就在 Postgres 里,向量列和关系数据可以放在同一张表、同一个事务里查询,运维体系也不需要变动。这对中小规模应用来说非常省心。
Qdrant 则是独立的向量搜索引擎,从索引结构到查询引擎都为向量场景从头设计,支持更丰富的过滤条件组合,在数据规模增大时更容易做水平扩展。
两者的取舍点很清晰:pgvector 赢在简单和统一,Qdrant 赢在专用场景下的性能上限和扩展能力。
向量索引是理解两者性能差异的关键。近似最近邻(ANN)搜索依赖索引结构来避免全量扫描,常见的有 HNSW、IVF 等。pgvector 支持 HNSW 和 IVFFlat 两类索引,但它们构建在 PostgreSQL 的存储与执行器之上,索引构建和查询会受限于 Postgres 的页面管理、并发控制和内存模型。Qdrant 则从存储层到索引层都为 HNSW 做了定制,包括向量量化(如标量量化和乘积量化)来压缩内存占用、分段(segment)式的索引组织、以及面向过滤条件的索引优化。这解释了为什么在数据量攀升时,专用引擎往往能在内存效率和查询延迟上取得更好的平衡。
社区反馈中的常见共识
从这类讨论中反复出现的观点来看,几个方向比较一致:
数据量是第一个分水岭。 当向量规模停留在百万级以内、且查询模式不复杂时,pgvector 往往够用,而且省去了引入新组件的成本。当数据量往千万级甚至更大走,或者需要复杂的元数据过滤加向量相似度的混合查询时,专用方案的索引和查询优化优势会逐渐显现。
过滤查询是 pgvector 的软肋。 很多开发者提到,在带条件过滤的向量检索场景里,pgvector 的执行计划有时不理想,需要手动调优索引策略。Qdrant 原生支持在向量检索中组合 payload 过滤,这类查询开箱即用的体验更好。
运维复杂度是反向的。 Qdrant 意味着一个新的服务、一套新的监控和备份流程;pgvector 只是多装一个扩展。团队规模小、运维人手有限时,这个因素的分量很重。
payload 过滤是 Qdrant 的核心设计之一。在 Qdrant 中,每个向量点可以附带一个 JSON 形式的 payload,存放元数据(如用户 ID、时间戳、类别标签等)。Qdrant 会对 payload 字段建立索引,并在 HNSW 图搜索过程中结合过滤条件进行遍历,从而在保持召回率的同时减少无效候选。与之对照,pgvector 的过滤依赖 SQL 的 WHERE 子句,执行计划可能先做向量排序再过滤,也可能先过滤再排序,哪种更优取决于数据分布和索引选择,开发者常常需要手动干预。需要说明的是,payload 过滤并不等同于传统数据库的任意复杂查询,它更侧重于在向量检索路径中高效地施加条件约束。
实践中的选择建议
如果团队已经在用 PostgreSQL,业务处于早期,向量规模可控,pgvector 是阻力最小的起点——不用改架构,不用新增技术栈,迭代速度最快。之后如果遇到性能瓶颈,再评估迁移。
如果向量检索是产品的核心能力,对延迟敏感,或者预期数据量会快速增长,Qdrant 更值得从一开始就投入。独立服务带来的扩展性和查询优化空间,在长期看能省下不少返工成本。
一个务实的做法是:先用 pgvector 验证业务价值,把向量维度和查询模式摸清楚;等数据量和 QPS 真正成为问题时,迁移到 Qdrant 的路径也相对成熟。
迁移成本值得提前评估。从 pgvector 迁往 Qdrant 并非只是导出再导入:向量维度、距离度量(余弦、内积、欧氏)需要保持一致,元数据要重新映射为 payload 结构,原有的 SQL 过滤逻辑要改写为 Qdrant 的过滤 DSL,应用层的查询接口也要相应调整。反之,从 Qdrant 退回 Postgres 也需要类似工作量。因此选型时除了当前的性能对比,还应考虑数据模型的耦合程度——如果业务逻辑高度依赖关系型事务,留在 pgvector 的收益会更持久;如果检索逻辑相对独立、可封装成服务接口,迁移的摩擦会更小。
延伸思考
这场比较背后反映的是 AI 基础设施的一个普遍问题:通用数据库在加上向量能力后,能不能满足 AI 原生的检索需求? 目前来看答案是"看场景"。pgvector 让向量检索的门槛降到极低,推动了大量 AI 应用的快速落地;Qdrant 这类专用引擎则承接了规模化和复杂查询的需求。两者并非替代关系,更像是同一技术栈在不同阶段的接力选手。
如果你正在做选型,不妨先量化自己的数据规模、查询复杂度和团队运维能力,再对照上面的取舍点做判断——这比追随任何单一推荐都更可靠。
相关推荐
 科技前沿
Caro揭秘:LBJ如何用伪装骗过种族隔离派
罗伯特·卡罗在LBJ传记中记录前参议员塔尔梅奇的采访:约翰逊初入参议院时刻意迎合南方保守派,塔尔梅奇称未察觉其民权倾向。掌权后约翰逊推动1964年民权法案与1965年投票权法案,揭示政治伪装与改革时机的关系。
 科技前沿
GitHub日报·11月07日:Agent就绪与上下文压缩
2026年09月02日(周三)午间版 AI新闻速递+热点深度讨论
 科技前沿
ToolLens:用Rust打造的MCP网关,将数千工具精简为三个
ToolLens 是一个用 Rust 编写的开源 MCP 网关,只向 AI 智能体暴露三个工具而非数千个,通过网关模式解决工具数量膨胀带来的上下文压力,为 MCP 生态提供工程化参考。