弃用向量数据库:SQLite BM25与3.6ns Rust哨兵重构多智能体
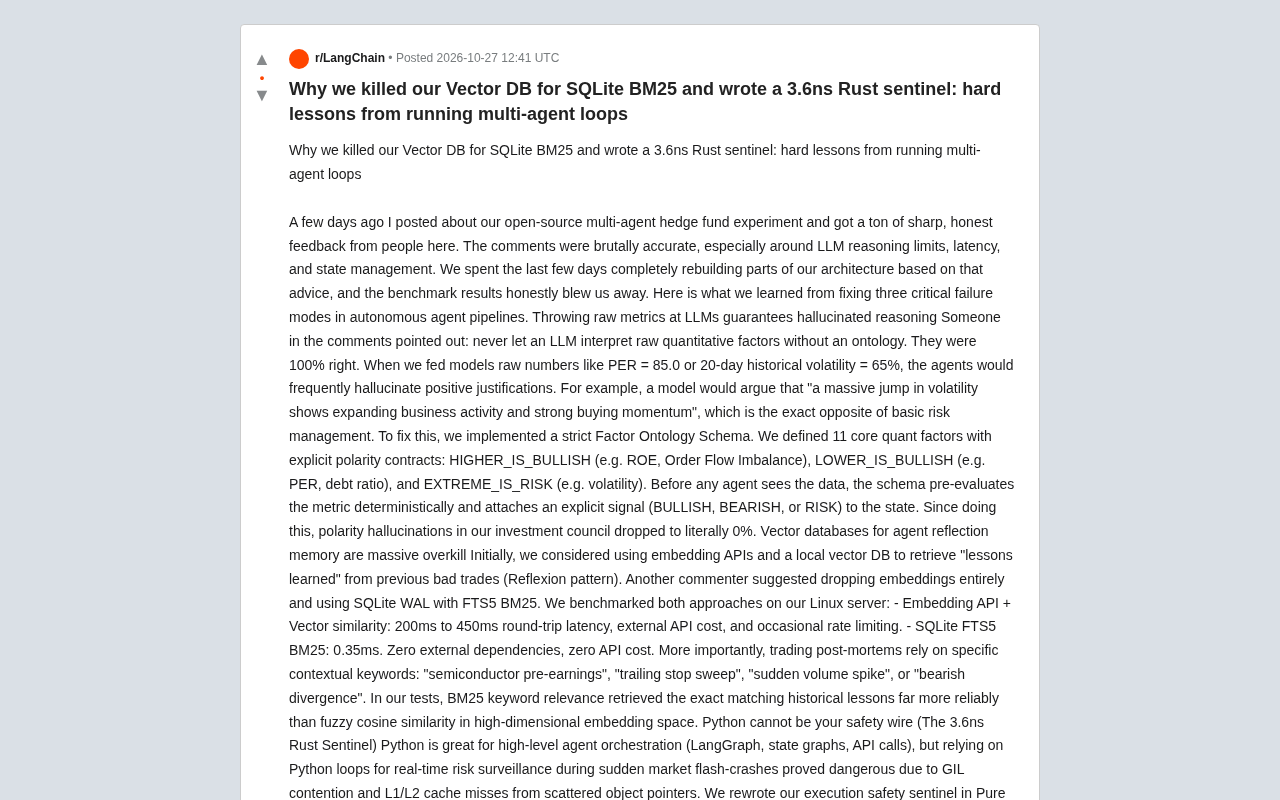
开源对冲基金团队用确定性 schema、SQLite BM25 与 Rust 哨兵重构多智能体交易系统。
一个开源对冲基金实验团队根据社区反馈重构了多智能体交易架构,修复了三个关键失败模式。其一,裸指标直接喂给大模型会诱发极性幻觉,团队引入因子本体模式,为 11 个量化因子绑定 BULLISH/BEARISH/RISK 极性契约,使投资委员会的极性幻觉降为零。其二,反思记忆放弃 embedding 加向量库,改用 SQLite FTS5 BM25,往返延迟从 200-450ms 降至 0.35ms,且关键词检索更精准。其三,实时风控用纯 Rust 的 Struct-of-Arrays 布局重写,禁用 unsafe 代码,单仓位评估仅 3.63 纳秒。最终分工是 Python 负责慢思考的智能体委员会,Rust 哨兵负责纳秒级组合监控,两者通过持久管道 IPC 连接。
多智能体系统在真实交易场景中运行时,哪些环节应该交给大模型,哪些必须用确定性系统兜底?一个开源对冲基金实验团队在社区反馈的推动下,对自己的架构做了彻底重构:放弃向量数据库、改用 SQLite 的 BM25 全文检索、并用 Rust 重写实时风控哨兵。他们的基准测试结果和踩坑记录,对任何正在搭建智能体流水线的人都有参考价值。
三个关键失败模式的修复
一、让大模型直接解读原始指标,必然导致极性幻觉
社区里有评论者指出:不要让大模型在没有本体(ontology)约束的情况下解释原始量化因子。团队验证后承认,这个批评完全正确。当他们把 PER = 85.0、20 日历史波动率 = 65% 这类裸数字直接喂给模型时,智能体频繁编造看多理由。例如模型会论证"波动率大幅跳升说明业务活动扩张、买盘动能强劲"——这恰恰与基本风险管理逻辑相反。
修复方式是引入严格的因子本体模式(Factor Ontology Schema):定义 11 个核心量化因子,并为每个因子绑定明确的极性契约,分为 HIGHER_IS_BULLISH(如 ROE、订单流失衡)、LOWER_IS_BULLISH(如 PER、负债率)、EXTREME_IS_RISK(如波动率)三类。在任何智能体看到数据之前,模式层先对指标做确定性预判,并把明确的信号(BULLISH、BEARISH 或 RISK)附着到状态上。团队称,实施之后投资委员会中的极性幻觉降到了 0%。
这个思路的普适意义在于:大模型擅长综合与辩论,但不擅长对数值做方向性判断。把方向判断从模型推理中剥离出来,用 schema 固化,既消除了幻觉,也让每次决策可审计。
BM25 与向量相似度检索的本质差异
BM25 是信息检索领域的经典概率排序函数,它基于词频、逆文档频率和文档长度归一化来给每个文档打分,核心假设是查询词在文档中出现得越多、越罕见,相关性就越高。与之相对,embedding 检索把文本压缩成一个稠密向量,用余弦相似度衡量语义接近程度。BM25 的优势在于精确匹配:当查询包含"移动止损扫单"这类术语时,只有真正含这个词的文档才会得高分;而稠密向量会把"止损"和"风险控制"拉近,却也可能把语义相关但情境无关的片段排到前面。BM25 无需训练、无需外部 API,单次查询常在微秒级完成,因此在结构化日志和复盘笔记这类短文本、强术语的场景中,往往比高维嵌入更可靠。
二、用向量数据库做反思记忆,属于严重过度设计
在实现 Reflexion 模式(从过往失败交易中检索"经验教训")时,团队最初考虑用 embedding API 加本地向量库。另一位评论者建议干脆放弃 embedding,改用 SQLite 的 WAL 模式配合 FTS5 的 BM25 全文检索。团队在 Linux 服务器上对两种方案做了基准对比:
- Embedding API + 向量相似度:往返延迟 200ms 到 450ms,有外部 API 成本,且偶发限流。
- SQLite FTS5 BM25:延迟 0.35ms,零外部依赖,零 API 成本。
更关键的是检索质量的差异。交易复盘依赖的是高度具体的情境关键词,比如"半导体财报前""移动止损扫单""成交量骤增""看跌背离"。团队测试发现,BM25 的关键词相关性比高维 embedding 空间里的模糊余弦相似度更可靠地命中了精确匹配的历史教训。
这对智能体记忆设计的启示是:当你的检索需求本质上是"找到包含这些具体术语的历史片段"时,关键词检索往往优于语义检索,而且延迟和成本低了不止一个数量级。
三、Python 无法充当安全防线:3.6ns 的 Rust 哨兵
团队认为 Python 适合高层智能体编排(LangGraph、状态图、API 调用),但在市场闪崩期间用 Python 循环做实时风险监控是危险的:GIL 争用和分散对象指针导致的 L1/L2 缓存未命中都会拖垮响应。
他们把执行安全哨兵用纯 Rust 重写,采用 Struct-of-Arrays(SoA)内存布局,并加上 #![forbid(unsafe_code)] 禁用不安全代码。把价格、止损触发线、移动止损阈值都放在连续平坦的切片里,CPU 无需追逐指针,数据始终留在缓存行内。团队在 Ubuntu 服务器上给出的真实基准:
- 单仓位止损/止盈评估:3.63 纳秒
- 1000 仓位批量评估:3.62 微秒
- 1000 根 K 线的量钟转换:3.90 微秒
- Python 到 Rust 的持久管道 IPC 往返:2.88 微秒
架构分工因此变得清晰:Python 负责"慢思考"——一次智能体委员会会议长达 15 分钟;Rust 哨兵以纳秒级监控整个投资组合。
Struct-of-Arrays(SoA)内存布局
在传统 Array-of-Structs(AoS)布局中,每个仓位对象把价格、止损线、触发阈值等字段装在一起,遍历时 CPU 会随对象指针跳到内存各处,容易产生 L1/L2 缓存未命中,而一次缓存未命中的代价可达上百个时钟周期。SoA 则把同一字段在所有仓位上的取值连续排成一条平坦切片,迭代时数据在内存中严格紧邻,能整条缓存行加载,也便于编译器自动向量化。在纳秒级风控循环中,这种布局带来的吞吐提升往往在数倍以上,且与语言无关,是任何延迟敏感系统都值得借鉴的底层技巧。
这套架构的通用经验
团队在结论中把教训提炼为一句话:大模型只应处理它擅长的事——上下文综合与对抗性辩论;所有确定性的部分,包括硬止损、因子极性和快速记忆检索,都应该交给严格的 schema、快速的本地数据库和编译型系统语言。
三条结论可以迁移到几乎任何智能体系统:
- 数值的方向性判断不要交给模型,用 schema 做确定性预判,模型只做解释与辩论。
- 反思记忆未必要向量化,关键词检索在特定情境下又快又准,成本几乎为零。
- 实时安全防线必须脱离解释器,内存布局和语言选择直接决定响应下限。
值得一提的是,团队在帖子末尾说明英语并非母语,原始笔记借助大模型做了格式整理与润色;代码与基准测试已在 GitHub 开源(lumina-ai-hedge-fund),可供验证 Rust SoA 哨兵与本体模式的具体实现。
相关推荐
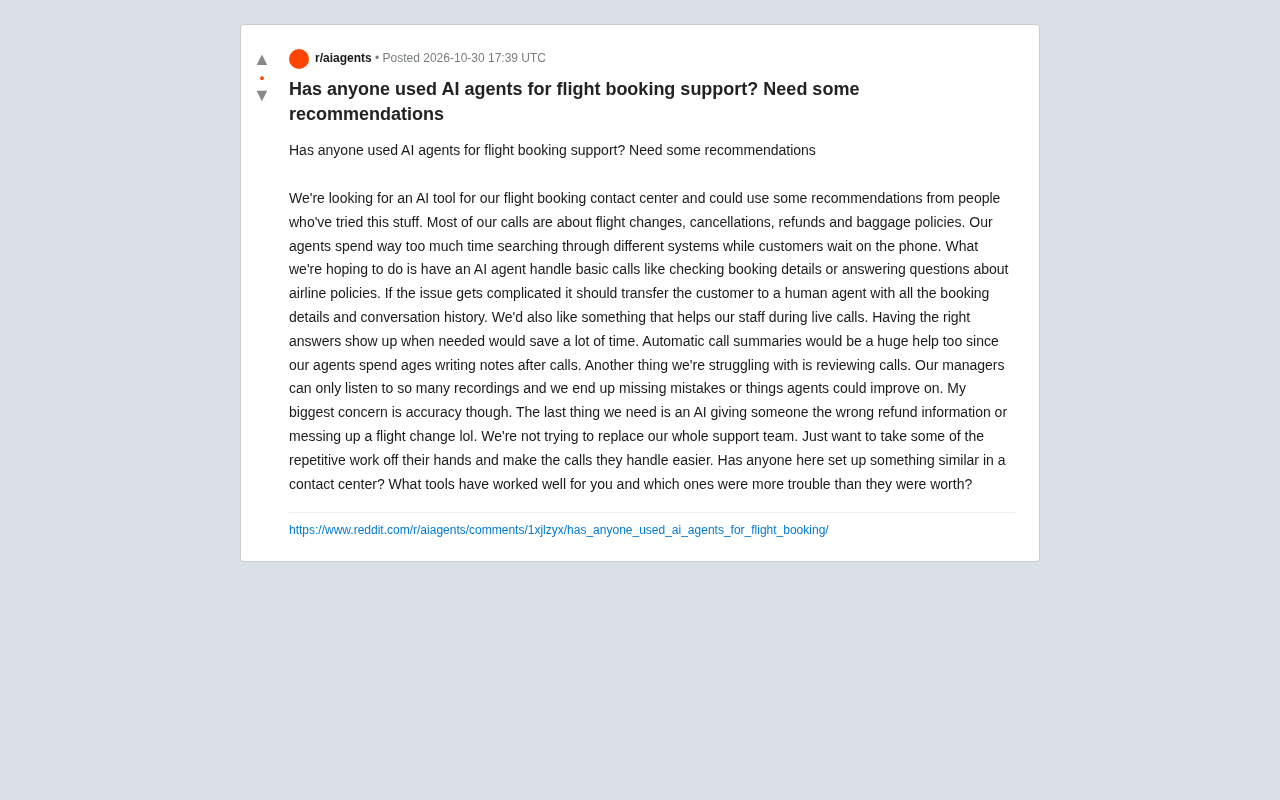
机票预订客服引入AI Agent:真实需求与落地难点
从Reddit真实提问出发,拆解机票预订呼叫中心引入AI Agent的四类需求:基础问答、座席辅助、通话摘要与质检,并分析准确性顾虑与转人工边界的设计要点。

Vercel 统一运行时缓存:Data Cache 并入 Runtime Cache
Vercel 将 Data Cache 并入 Runtime Cache,统一 Next.js fetch 缓存、unstable_cache、getCache 与 use cache: remote 的存储配额与计费,Pro 和 Enterprise 项目获得更大存储空间,缓存读写开始按 Runtime Cache 定价计费。

谷歌卫星AI服务器升空:Gemma模型在轨生成首条回复
谷歌宣布其搭载TPU的卫星成功启动,板载Gemma 4模型从太空生成首条回复,完成在轨AI推理验证。本文分析太空AI服务器的技术路径、现实约束及对边缘计算与卫星遥感的意义。