千万亿参数Transformer:训练可行性与工程挑战
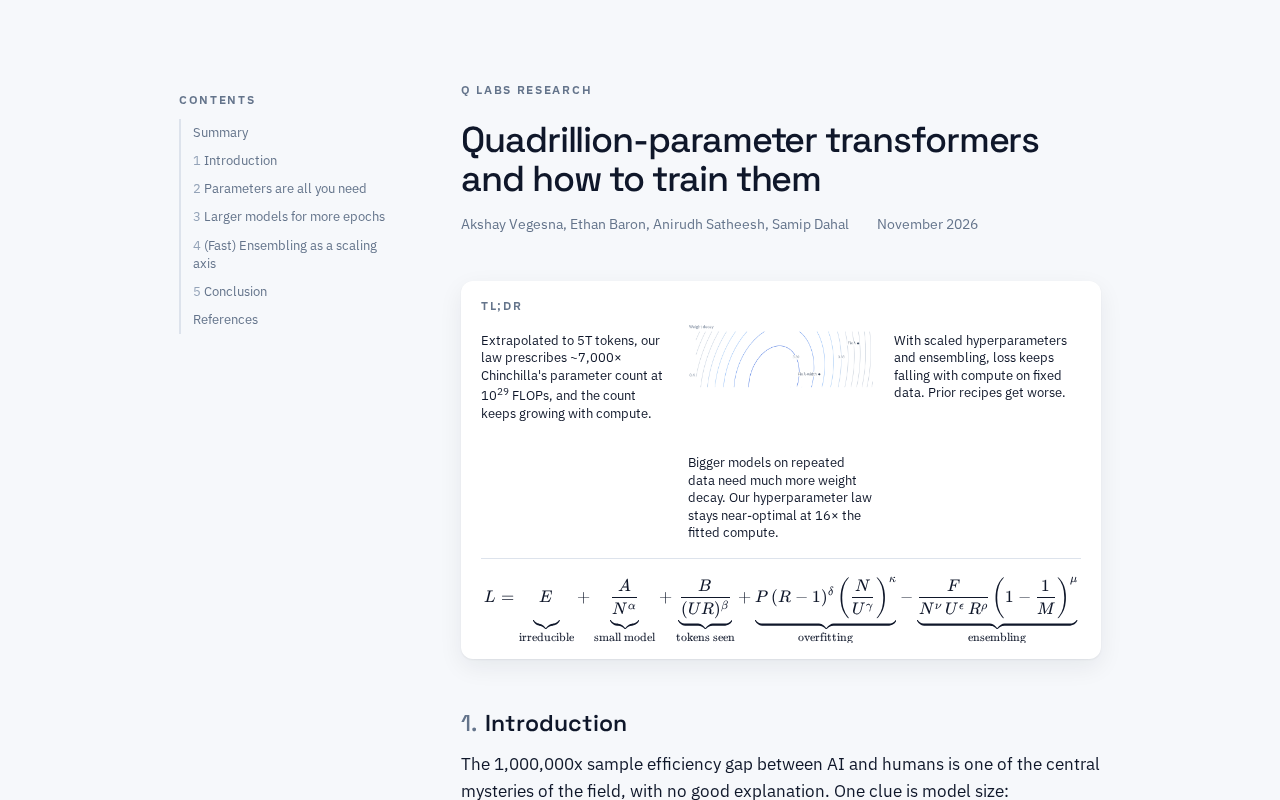
千万亿参数Transformer迫使重新审视显存、并行与Scaling law的物理边界
文章以Hacker News上一则关于千万亿(10^15)参数Transformer训练的冷门讨论为引,拆解了从万亿到千万亿三个数量级跃迁所面临的根本约束。存储上,即便FP8精度也需约1000TB量级显存,远超单Pod容量;训练上,极致并行带来的通信开销、MoE的路由与all-to-all难题、低精度与权重卸载都从优化项变为必需项。更尖锐的追问是值不值得:Scaling law收益能否外推、高质量token总量是否支撑如此庞大的参数,均无公开证据。文章认为这类讨论的真正价值在于为下一代训练基础设施标定工程边界。
从万亿到千万亿:一次数量级的跃迁
Hacker News 上最近出现了一个标题引人注目的讨论:Quadrillion-parameter transformers and how to train them(千万亿参数 Transformer 及其训练方法)。帖子目前只有 7 分和 1 条评论,热度不高,但它指向的问题本身并不小——当模型参数规模从万亿(trillion)再往上跳三个数量级,达到千万亿(quadrillion,即 10^15)级别时,现有的训练范式还能不能成立?
这个问题的价值不在于“某家公司马上要训练一个千万亿参数模型”,而在于它迫使我们重新审视 scaling law 的物理边界:显存、带宽、能耗、并行策略,每一层都会在某个数量级上撞墙。
千万亿参数意味着什么
先把数字拆开看。一个千万亿参数的稠密模型,即便用 FP8 精度存储,仅权重本身就需要约 1000 TB 量级的显存——这已经远超单机乃至单个 Pod 的容量。哪怕采用 MoE 稀疏架构把激活参数量压下来,总参数对应的存储和通信开销仍然是绕不开的硬约束。
作为参照,当前公开讨论的前沿模型多在万亿参数以内。从万亿到千万亿,是三个数量级的跨度,而不是一次常规的版本迭代。这也解释了为什么这个话题在 Hacker News 上引发的第一反应往往是“先问怎么存,再问怎么训”。
MoE(Mixture of Experts,混合专家) 是一种稀疏激活架构:模型包含多个独立的“专家”前馈网络,每个 token 经由路由器(router)只被分配到其中少数几个专家计算。因此总参数量可以远大于每个 token 实际激活的参数量,例如总参数 1 万亿而单次激活仅几百亿。这使得“总参数膨胀、计算量可控”成为可能,也是千万亿规模讨论中绕不开的结构。代价是路由决策本身需要训练、专家负载容易不均衡,且专家分布在不同设备上时会产生跨节点 all-to-all 通信,规模越大调度越困难。
训练路径的几种可能
围绕千万亿参数训练,原讨论并未展开成体系的技术方案,但结合当前大规模训练的主流思路,可以梳理出几条被反复提及的方向:
极致并行与分片
张量并行、流水线并行、数据并行以及序列并行的组合几乎是必然选择。问题在于,当并行度推到极端,通信开销会迅速吃掉计算效率,梯度同步的延迟成为瓶颈。如何在数万甚至更多加速器之间维持可接受的 MFU,是第一个要回答的问题。
稀疏化与 MoE
稠密模型在千万亿规模下几乎不可行,MoE 被普遍视为让总参数膨胀而计算量可控的手段。但 MoE 带来路由均衡、专家负载倾斜、跨节点 all-to-all 通信等新问题,规模越大越难调。
低精度与内存层级
FP8 乃至更低精度的训练、权重卸载到主机内存或外部存储、checkpoint 的分层管理,都会在这个量级上从“优化项”变成“必需项”。
MFU(Model FLOPs Utilization,模型浮点运算利用率) 衡量的是训练过程中实际用于模型前向与反向计算的算力占总峰值算力的比例。大规模分布式训练中,梯度同步、流水线气泡、all-to-all 通信等都会让加速器空转,MFU 因而成为判断并行策略是否划算的核心指标。业界大规模训练的 MFU 常在 30%–50% 区间,当并行度推到数万加速器时,通信开销会显著压低这一数值,所以在千万亿参数场景下,“能否维持可接受的 MFU”等价于“并行方案是否真正可行”。
更现实的追问:值不值得
比“怎么训”更尖锐的问题是“为什么训”。Scaling law 的收益曲线是否还能在千万亿参数上延续,目前没有公开证据支持。数据侧的约束同样明显——高质量 token 的总量是有限的,参数规模远超数据规模时,模型能否有效利用这些容量存在疑问。
Hacker News 这类技术社区的讨论往往会在此时转向成本收益:训练一次的成本、推理部署的可行性、以及相比一个精心调优的中等规模模型能否带来实质提升。原帖信息量有限,没有给出结论,但这恰恰是值得读者自己判断的地方。
Scaling law(缩放定律) 指模型损失随参数量、数据量和计算量按幂律下降的经验规律,是过去几年大模型“堆规模”的理论依据。但幂律收益是递减的:每提升一个数量级所换来的损失下降越来越小,且定律通常在训练数据充足的前提下成立。当参数规模远超高质量 token 总量时,模型可能无法充分利用其容量,收益曲线是否还能外推存在争议。这正是千万亿参数讨论中最根本的不确定性——它不是一个工程问题,而是经验规律能否跨越三个数量级继续成立的问题。
工程之外:一个思想实验的价值
把千万亿参数当作思想实验来看,它的意义在于标定边界。当研究者认真推演“如果要做,卡点在哪里”,实际上是在为下一代基础设施划定 roadmap:互联带宽要做到什么水平、存储层级如何设计、容错与 checkpoint 策略如何演进。
对于关注大规模训练的工程师来说,这类讨论的价值不在于结论,而在于它把问题拆解得足够具体,让人看清每一个数量级背后对应的工程代价。原帖虽然只有寥寥数语,但它提出的问题足够大,值得被认真对待。
(注:原始素材仅包含标题与互动数据,未提供具体技术方案或数据,本文基于标题所指问题展开分析,未引用素材外未经验证的具体数值。)
背景补充
FP8 与低精度训练:FP8 指 8 位浮点格式(如 E4M3、E5M2),相比 FP16/BF16 可将权重与激活的显存占用减半。其可行性依赖于细粒度的缩放因子(per-tensor 或 per-block scaling)来抑制数值溢出与下溢。在千万亿参数规模下,低精度不只是提速手段,更是把权重、优化器状态和激活压进可用显存层级的必要前提;与之配套的还有优化器状态分片(如 ZeRO)和把不活跃参数卸载到主机内存或 NVMe 的分层策略。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。