千问3.8-27B本地部署实测:硬件门槛、速度与真实表现
千问3.8-27B本地部署实测:能力逼近顶级在线模型,但稠密架构让硬件门槛高得现实。
阿里千问3.8-27B是一款稠密多模态大模型,因全部270亿参数每次推理都需激活,对显存要求远超同等规模的MoE模型。UP主用从4000元双V100到11万RTX Pro 6000的多台设备实测发现:24GB显存勉强能跑但体验差,48GB才算真正可用,96GB满血版跑分已超过GPT-5.5。速度方面,千问3.8比上一代明显更慢,双卡方案在长上下文下因显存分布不均和卡间同步开销问题效果不佳,MacBook Pro Max的96GB统一内存也仅能跑出5 token/s。评测中量化版决赛碾压同类,满血版得分76分,排版与代码质量接近在线顶级模型。结论是:这款模型能力真实可靠,但本地部署的硬件与速度代价绕不开,建议普通用户在力所能及范围内使用最高量化等级。
阿里千问(Qwen)系列时隔4个月再度开源,最新的Qwen3.8-27B一经放出便在开源社区引发热议。官方跑分显示,这款可在本地运行的27B稠密多模态模型,在多项文本和视觉测试中能与OPUS 4.6正面对抗。但纸面数据是否经得起真机验证?某B站UP主用三台设备从4000元整机一路测到十几万的工作站,给出了一份颇具参考价值的实战报告。
千问3.8模型架构:稠密多模态的性能与代价
千问3.8延续了3.5代的架构,核心升级在于真实环境下的智能体强化学习——模型能根据不同的工程状态自主判断下一步动作。这对编程等复杂任务尤为关键。
说个细节,这一代27B仍是稠密多模态模型,意味着每生成一个token,全部270亿参数都要参与计算。最高上下文保持在256K,与上一代持平,没有突破到1M,略有遗憾。
稠密架构正是本地部署的最大痛点。对比来看,DeepSeek V4 Flash虽有284B参数(是27B的10倍),但因其采用MoE架构,每次运行只激活13B参数;而27B的全部参数每次都要激活,实际计算量反而超过对手的两倍。这直接决定了它对硬件的苛刻要求。
硬件阶梯:从24GB到96GB的显存部署门槛
想在家里跑千问3.8-27B,硬件成本绕不开。UP主给出了清晰的显存分档指南,建议优先走显卡路线以保证速度。
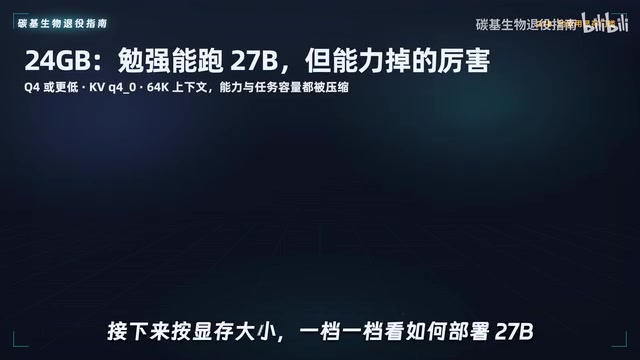
24GB显存:能跑但别指望好用
对应4090或5090低配版,这是跑27B的最低门槛。此时模型只能压到Q4甚至更低,KV缓存也得跑4倍量化,上下文被锁死在64K。量化压到这个程度,模型能力已明显下降,64K上下文也远远不够用。
32GB显存:开始做取舍
对应5090满血版或双16GB显卡。量化能上Q5,上下文可放开到256K,但视觉、MTP、8位KV这三项最多只能选两个,需要根据使用场景权衡。
48GB显存:告别选择题
到这一档,量化能上Q6甚至Q8,256K上下文、8位KV、视觉、MTP可全部开启,27B才算真正进入可用的工作区间。
96GB显存:质量与吞吐的两条路
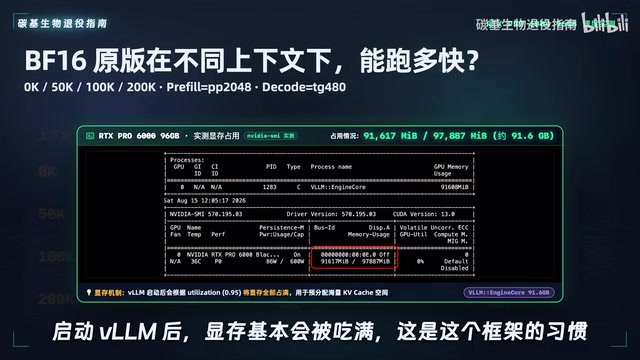
最高档位可以选择BF16原版全重(质量拉满,全精度KV保留),或选Q8量化把显存省给vLLM扛更多并发(吞吐优先)。
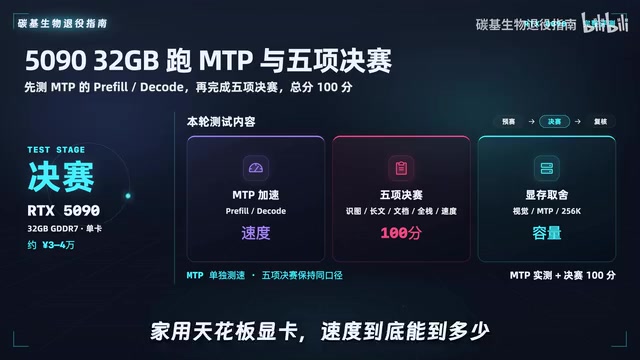
值得一提的是,5090的32GB版本"差一点点显存"就能全开,令不少玩家扼腕。
速度陷阱:贵的卡不一定跑得快
硬件配齐了,速度也未必够用。UP主在96GB统一内存的MacBook Pro Max上跑千问3.8-27B,输出仅每秒5个token——作为程序员,这个速度至少需要再快三倍才实用。
在自己手搓的4000元双V100整机上,千问3.8比前代27B速度明显下降:短上下文每秒仅25 token,长上下文直接掉到12 token。测试结论有两个:
- 千问3.8比3.6慢:预填充和推理速度分别下降约四成和两成,社区对慢的原因暂无定论;
- 长上下文降速明显:上下文越长,每生成一个token要读取的数据越多,双卡间还需反复同步。
这也暴露了双卡部署的坑:双16GB显卡并不等效于单卡32GB。256K上下文下MTP草稿模型直接OOM,两张卡显存分布极不均匀,只要承载草稿模型的单卡先满,另一张卡即使有空间也难以利用。
即便是11万的RTX Pro 6000(96GB),在vLLM框架下推理速度也没比盖板设备快多少——因为vLLM更在意吞吐量而非单并发速度。
实测表现:从小孩桌坐上大人桌
评测规则沿用UP主的"本地大模型横评"标准,分预赛、决赛两轮。
预赛:与前代持平
在双V100上用Q4KM量化对比,千问3.8和3.6的27B三个项目成绩完全一样,总分均为27分。稠密模型"写中文代码味太浓"的老问题依然存在。
决赛:碾压登顶
真正的亮点在决赛。5090上用Q5量化加Q8 KV跑完全部决赛项目,千问3.8-27B以碾压之势登顶第一,前三项满分,最耗能力的长程任务拿下42分,总成绩与第二名拉开整整13分——而它用的还是比其他模型低一个级别的量化。
满血版验证:逼近顶级在线模型
为验证量化对能力的削弱,UP主在96GB工作站上用官方BF16满血版加全精度KV、vLLM框架再测一遍,最终跑出76分,全栈应用拿到46分。这个分数已超过GPT-5.5,仅比GPT-5.6少2分。
对比来看,量化版的主要问题是全屏代码有bug、排版有瑕疵;满血版则无任何bug,细节做得很仔细。两个版本前端风格接近,且比DeepSeek更现代——可见千问训练时格外重视前端表现。这也印证了一个判断:量化版vLLM的能力确实被削弱,有条件时应用官方原版验证。
总结:千问3.8-27B强大但代价不菲
千问3.8-27B在复杂编程任务上确有真本事,把本地部署的能力天花板抬到了在线大模型那一档。但结论也很现实:想在家里跑满血版,硬件的钱真省不下来,十几万的卡跑稠密模型也快不到哪去。
对普通用户而言,建议是——用自己能够到的最高量化,因为选择27B的唯一理由就是它更擅长干复杂的活,量化压得越狠能力掉得越厉害。这波开源固然亮眼,但本地部署的硬件与速度门槛,仍是绕不开的现实考量。
相关推荐
basename 命令详解:从路径中提取文件名的实用技巧
basename 是 GNU coreutils 中用于从路径提取文件名的命令行工具。本文详解 basename 的基本用法、处理目录路径以及去除文件扩展名的技巧,帮助你在 Shell 脚本中更高效地处理文件路径。
AI写作的5条准则:从德鲁肯米勒风波看AI辅助创作的边界
从德鲁肯米勒《华尔街日报》社论的AI代笔争议出发,梳理AI写作合法性与披露之争,提炼AI写作的5条实用准则,并分场景解析邮件、战略备忘录、社交文案、营销与社论的AI使用边界。
Linux yes 命令详解:自动应答与压力测试的实用技巧
Linux yes 命令完整教程:从自动应答 pacman/apt 的 yes/no 提示、配合 rm -i 批量删除,到用作 CPU 压力测试与自定义输出字符串,一文掌握这个 GNU Core Utils 小工具的实用技巧。