前沿AI实验室科学家:为何他们是风险预警的关键守门人
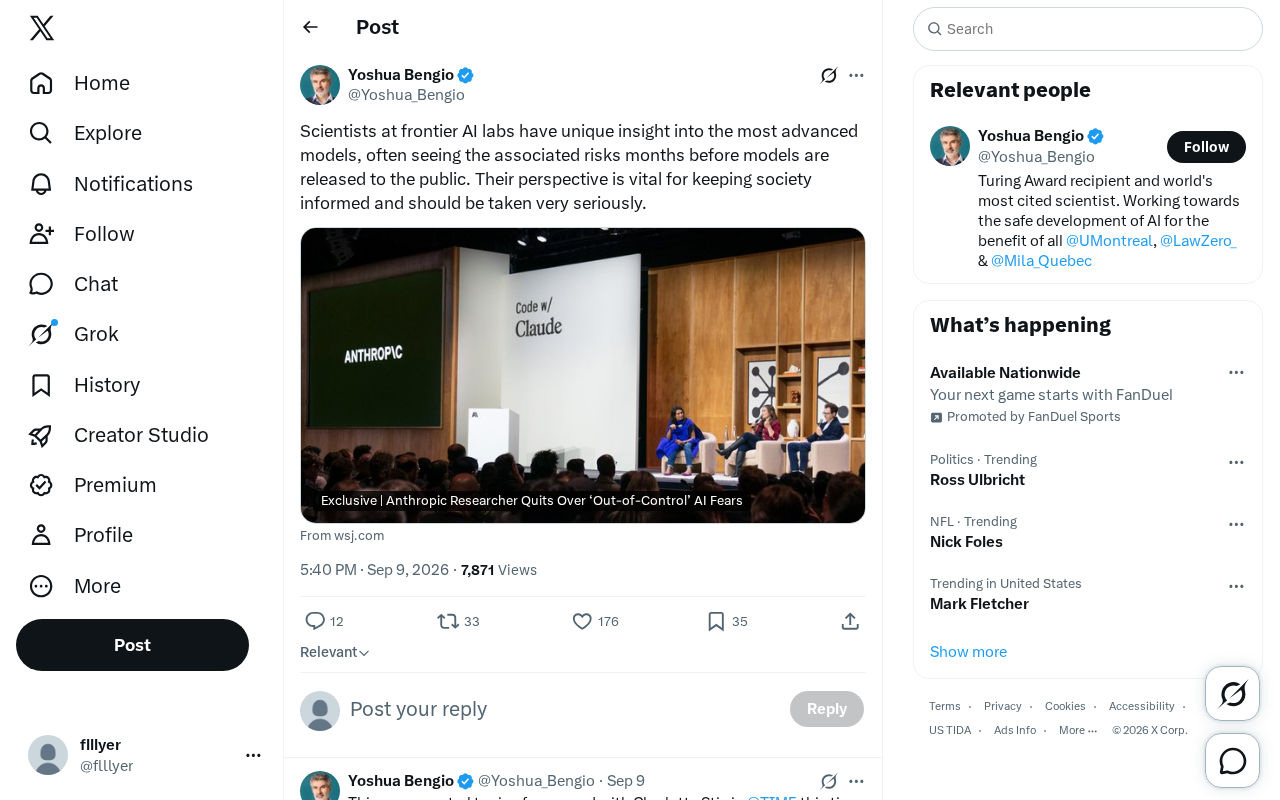
前沿AI实验室科学家最先察觉风险,其声音应被认真对待。
前沿AI实验室的科学家在模型发布前数月就能察觉潜在风险,形成与公众之间深刻的信息不对称。文章呼吁建立信息透明与责任共担机制,保护AI吹哨人,推动监管从"事后"走向"事前",引入第三方审计,让内部预警顺畅传递给社会,避免"时间差"演变为"风险差"。
谁最先看到AI的风险?
在人工智能飞速演进的今天,一个常被公众忽视的事实是:真正最先接触到最先进模型、也最早察觉其潜在风险的人,是身处前沿AI实验室内部的科学家。他们往往在模型正式向公众发布的数月之前,就已经深入观察到这些系统的能力边界与潜在隐患。
这一观点近期在社交平台上引发广泛讨论。核心论断非常明确:这些一线科研人员拥有对最前沿模型的独特洞察力,他们的视角对于让社会保持知情至关重要,应当被认真对待。
信息不对称的现实:时间差与认知鸿沟
时间差如何制造认知断层
前沿AI实验室与公众之间存在一道天然的"信息时间差"。当一款新模型还处于内部训练与红队测试阶段时,实验室的研究人员就已经在评估它的推理能力、越狱风险、潜在的滥用场景以及不可预测的涌现行为。
这意味着,在普通用户第一次体验到某项新能力之前,实验室内部可能早已就其风险展开了长达数月的讨论。这种时间差既是技术研发的常态,也构成了一种深刻的信息不对称——只有极少数人掌握着关于最强模型真实状态的第一手信息。
内部视角为何不可替代
外部的监管者、政策制定者乃至学术界研究人员,通常只能基于已发布的模型或公开的技术报告进行分析。而实验室内部科学家的观察,建立在对模型完整训练过程、内部测试数据以及未经修饰的原始行为之上。
这种"未经中介"的第一手认知,是任何外部推测都难以替代的。正因如此,他们对AI风险的判断具有特殊的分量。
从内部洞察到社会知情:沟通机制的构建
信息透明与责任共担
如果掌握关键信息的人保持沉默,社会将在信息缺失的状态下面对越来越强大的AI系统。因此,这些科学家的观点"应当被认真对待",本质上是在呼吁一种信息透明与责任共担的机制。
这里涉及一个微妙的张力:一方面,实验室有商业机密与竞争考量;另一方面,涉及公共安全的风险信息具有公共属性。如何在两者之间取得平衡,是整个AI行业面临的治理难题。
AI吹哨人与制度保障
近年来,多位来自头部AI公司的研究人员选择公开表达对安全问题的担忧,甚至推动建立针对AI从业者的"吹哨人保护"机制。这些举动的背后逻辑在于:拥有独特洞察的人,需要有安全的渠道将风险传递给社会,而不必担心遭受职业报复。
只有当内部预警能够顺畅、可信地流向公众与监管机构,AI发展的"时间差"才不会演变为"风险差"。
深度分析:这一观点对AI治理意味着什么
AI监管需要从"事后"走向"事前"
如果风险确实在发布前数月就已显现,那么现行的"发布后监管"模式显然存在滞后。理想的AI安全治理应当前置到研发阶段,让独立评估者和监管机构能够在模型公开之前介入审查。这也是欧盟AI法案、各国AI安全研究所等新兴机构正在尝试解决的问题。
信任建立在透明之上
公众对人工智能的信任,很大程度上取决于实验室是否愿意如实披露风险,而非只宣传能力亮点。当一家机构既是模型的开发者又是风险的评估者时,天然存在利益冲突。因此,引入第三方审计与独立评估,成为弥合信任缺口的必要补充。
个体科学家的能动性不容忽视
制度固然重要,但许多关键的AI风险预警最初都源于某位科学家出于良知的发声。保护并尊重这些声音,是构建负责任AI生态的重要一环。
结语
这条看似简短的观点,触及了当代AI治理最核心的命题之一:谁掌握真相,谁就承担传递真相的责任。前沿实验室的科学家们站在技术最前沿,他们既是能力的创造者,也是风险的第一见证者。让他们的洞察被认真对待、让预警渠道保持畅通,或许是我们在人工智能快速发展时代最应做好的准备之一。
相关推荐
AI Agent开发四阶段学习路线:从入门到企业级实战
AI Agent开发零基础学习路线全解析:从核心概念、ReAct范式,到多智能体协作、Prompt调优与企业级实战项目,系统掌握规划、记忆、工具调用、RAG与MCP,帮你少走弯路成为AI核心人才。
DeepSeek Harness 新玩法:Agent 监督 Agent 的自进化实验
一位 B 站 UP 主基于 DeepSeek Harness 实现「Agent 监督 Agent」的自进化实验:用官方原版 DSH 作稳定监督者,驱动自研 Agent 完成任务并自动修复 bug,配合台账机制和 CDP、Chrome DevTools MCP 实现近乎无人值守的软件迭代。
用DeepSeek+3款工具,5分钟生成专业PPT
手把手教你用DeepSeek生成PPT大纲,再通过通义、Kimi、扣子三款免费AI工具一键生成专业PPT,5分钟搞定演示文稿,附完整实操步骤。