前沿模型能被视觉诱饵骗过吗?Elorian用图像思考破局
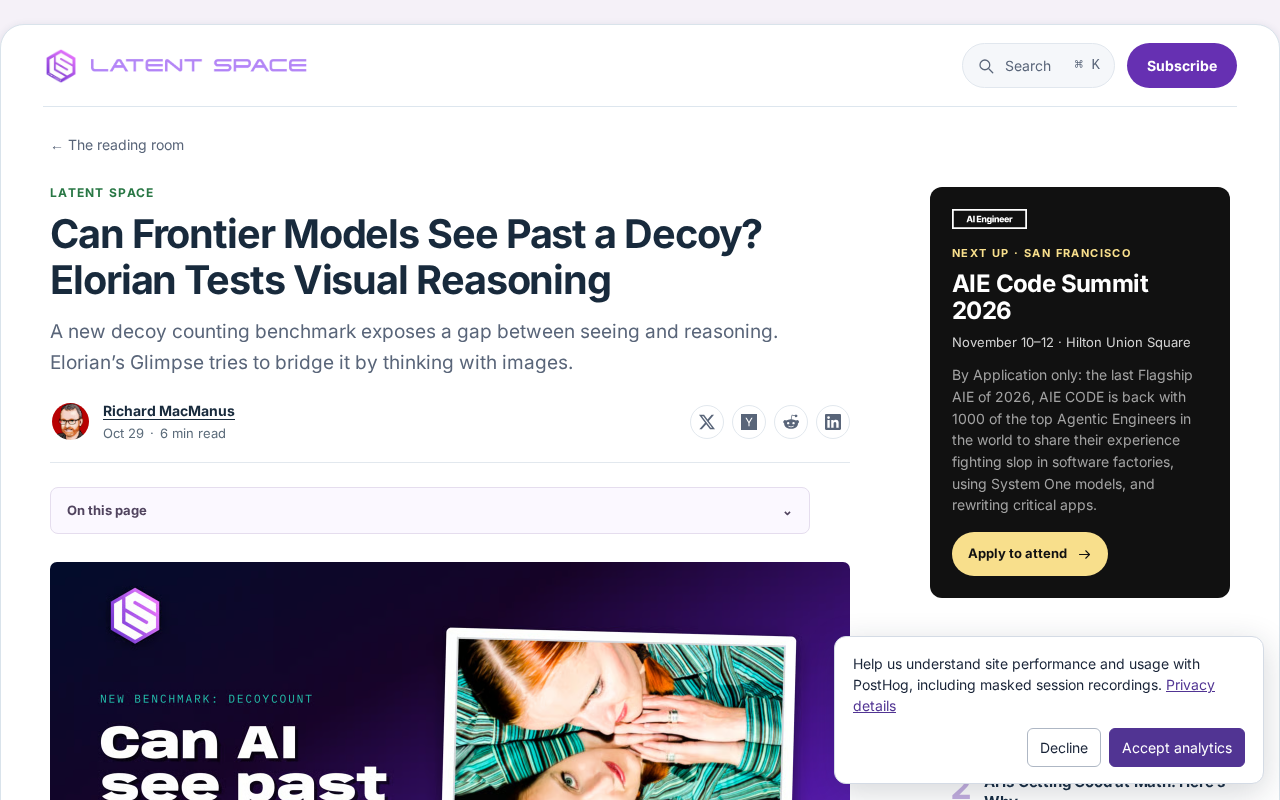
Elorian发布诱饵计数基准揭示多模态模型感知与推理的裂缝,并提出用图像思考的Glimpse方案。
Elorian团队发布名为“诱饵计数”的基准测试,通过在计数场景中植入干扰性视觉元素,揭示前沿多模态模型“看得见却想不明白”的短板:模型能准确描述画面,却在需要抑制干扰、依据规则判断的环节失分。针对这一缺口,Elorian提出Glimpse方案,主张让模型在推理过程中保留并操作视觉表征,而非先将图像压缩为文本描述再推理,以减少信息损耗。文章指出,多模态评测长期偏重描述类任务,诱饵计数补上了推理深度的拼图,更贴近真实应用中的干扰常态。该工作也指向更深层问题:以文本为中心的推理架构是否可持续。目前Glimpse的具体提升幅度、泛化能力和效率开销尚待披露。
视觉推理一直是多模态大模型能力版图中最微妙的一块。模型能“看到”图像,不等于它能“理解”图像。Elorian 团队发布的一项名为“诱饵计数”的基准测试,直接把这个问题摆到了台面上:当画面中混入干扰性视觉元素时,前沿模型还能数对吗?
诱饵计数:看见与推理之间的裂缝
这项基准的设计思路相当巧妙。它不是让模型数清楚一张图里有多少个物体那么简单,而是在计数场景中植入“诱饵”——那些看起来像目标却不该被计入的元素。模型如果只是依赖视觉特征的浅层匹配,就很容易把诱饵算进去,给出错误答案。
结果暴露出一个清晰的差距:真正的视觉感知和视觉推理并不是一回事。模型可以准确描述画面内容,却在需要抑制干扰、依据规则做判断的环节上失分。这种“看见却想不明白”的现象,正是当前多模态模型在复杂真实场景中落地的关键瓶颈。
视觉推理(visual reasoning)与视觉感知(visual perception)在认知科学和人工智能领域有明确区分:感知指从像素中提取物体类别、位置、属性等特征,推理则要求在感知结果之上执行规则约束下的判断、比较与推演。多模态大模型通常由视觉编码器(如ViT)将图像映射为特征序列,再经投影层接入语言模型,推理过程几乎完全在文本token空间中进行。这一架构天然造成“感知—推理”信息通道的断裂:视觉特征在进入语言模型前已被压缩为有限数量的token,细粒度空间关系与相似物区分信息容易丢失。诱饵计数基准正是利用这一弱点,通过在计数场景中植入与目标高度相似的干扰物,检验模型是否具备抑制无关特征、依据规则筛选目标的能力,而非仅依赖浅层视觉匹配。
Elorian Glimpse:用图像来思考
针对这个缺口,Elorian 给出的方案是 Glimpse。它的核心主张是让模型“用图像思考”——不是把视觉输入压缩成文本描述再做语言推理,而是在推理过程中保留并操作视觉表征本身。
这个思路的动机很直接:文字描述天然会丢失信息。当你把一张图转成一句话,诱饵和目标的细微差别、空间关系、视觉上的相似性都可能被抹平。保留图像通道参与推理,理论上能让模型在计数、比对、空间判断这类任务上少丢信息。
据 Elorian 的介绍,Glimpse 的目标就是在感知与推理之间搭一座桥,把“看得见”转化为“想得清”。
“用图像思考”(thinking with images)是近年多模态推理研究中的一类新范式,其代表性思路包括在推理链中插入图像裁剪、区域重采样或视觉token回填等操作,使模型能够像人类一样通过“再看一眼”来修正判断。与传统的“图像→文本描述→语言推理”两阶段流程不同,这类方法在推理的中间步骤保留原始视觉表征,允许模型直接对图像区域进行比对、计数或空间定位。其技术前提是视觉编码器输出的特征具备足够的空间分辨率和语义保真度,且语言模型能够以交错方式处理文本与视觉token。Elorian Glimpse的核心主张即属于这一谱系,试图在推理过程中维持图像通道的活跃参与,从而减少文本化过程中的信息损耗。
为什么这件事重要
多模态模型的评测长期偏重描述类任务,比如看图说话、视觉问答。这类任务考验的是模型能否提取并转述信息,但对推理深度的要求有限。诱饵计数这类基准补上了另一块拼图:它逼模型在存在干扰的条件下做判断,更接近真实应用中的情况。
无论是文档理解、界面操作还是机器人感知,现实世界从不提供干净的输入。干扰项、相似物、视觉歧义是常态。模型在这些条件下能否保持判断稳定,直接决定了它能不能从演示走向可用。
Elorian 的尝试也指向一个更根本的问题:多模态模型的推理架构是否应该继续以文本为中心。如果视觉信息在进入推理前就被降维成文字,那么再强的语言推理能力也无法弥补感知阶段的损失。Glimpse 代表的是一种架构层面的反思。
多模态评测长期以描述类任务为主,如COCO Caption、VQA等,这类基准主要衡量模型对图像内容的提取与转述能力,对多步推理和干扰抑制的考察不足。近年来出现的视觉推理基准开始引入组合性、反事实和干扰项设计,例如在计数任务中混入相似物、在空间关系判断中加入镜像混淆。这类评测更贴近文档理解、GUI操作和机器人感知等真实应用场景,因为这些场景的输入天然包含大量无关元素和视觉歧义。评测范式的演进因此不仅是度量工具的更新,也在反向塑造模型的设计方向:当评测揭示出“感知强、推理弱”的系统性偏差时,架构层面的反思便成为必要。
待观察的问题
目前公开的信息还比较有限。Glimpse 在诱饵计数基准上的具体提升幅度、它与其他视觉推理方法的对比结果、以及这套方法在计数之外的任务上能否泛化,都还没有充分披露。
一个值得关注的维度是效率。保留视觉表征参与推理意味着更高的计算开销,这种代价在实际部署中是否可接受,将影响该方法的适用范围。
另一个问题是评测本身的可推广性。诱饵计数抓住了视觉推理的一个痛点,但视觉推理的挑战远不止计数一项。空间关系推理、因果视觉判断、多步视觉规划,都需要各自的评测工具。Elorian 开了个头,但这条路还很长。
无论如何,这项工作和它背后的基准提醒了一件事:多模态模型的进步不能只靠堆参数和喂数据,评测方式和推理范式的创新同样关键。视觉诱饵能骗过前沿模型,说明我们衡量“看懂”的标准,本身也需要被重新审视。
相关推荐
OpenAI攻破ETH?P=NP或颠覆加密世界
OpenAI据称发论文推翻指数时间假设ETH,亚指数算法引发P=NP猜想。本文解读3SAT问题、ETH含义,分析若P=NP成真对RSA加密、区块链及蛋白质折叠的颠覆性影响。
当反指纹脚本被误判为生物武器:安全工具的检测困境
当反指纹脚本被误判为生物武器:安全工具的检测困境
反指纹脚本被安全检测误判为生物武器,引发Hacker News热议。本文分析关键词匹配规则的误报成因、开发者应对方式,以及安全工具在自动化与精准度之间的长期失衡。
4.1万国土安全部员工数据泄露,含ICE卧底身份
美国国土安全部约4.1万名员工数据遭泄露,其中包含ICE卧底探员身份信息。本文分析泄露数据的敏感性、执法机构面临的安全风险,以及敏感身份数据在权限管理、第三方访问和审计层面的防护要点。