窃取推理链:闭源大模型API的新型知识蒸馏攻击
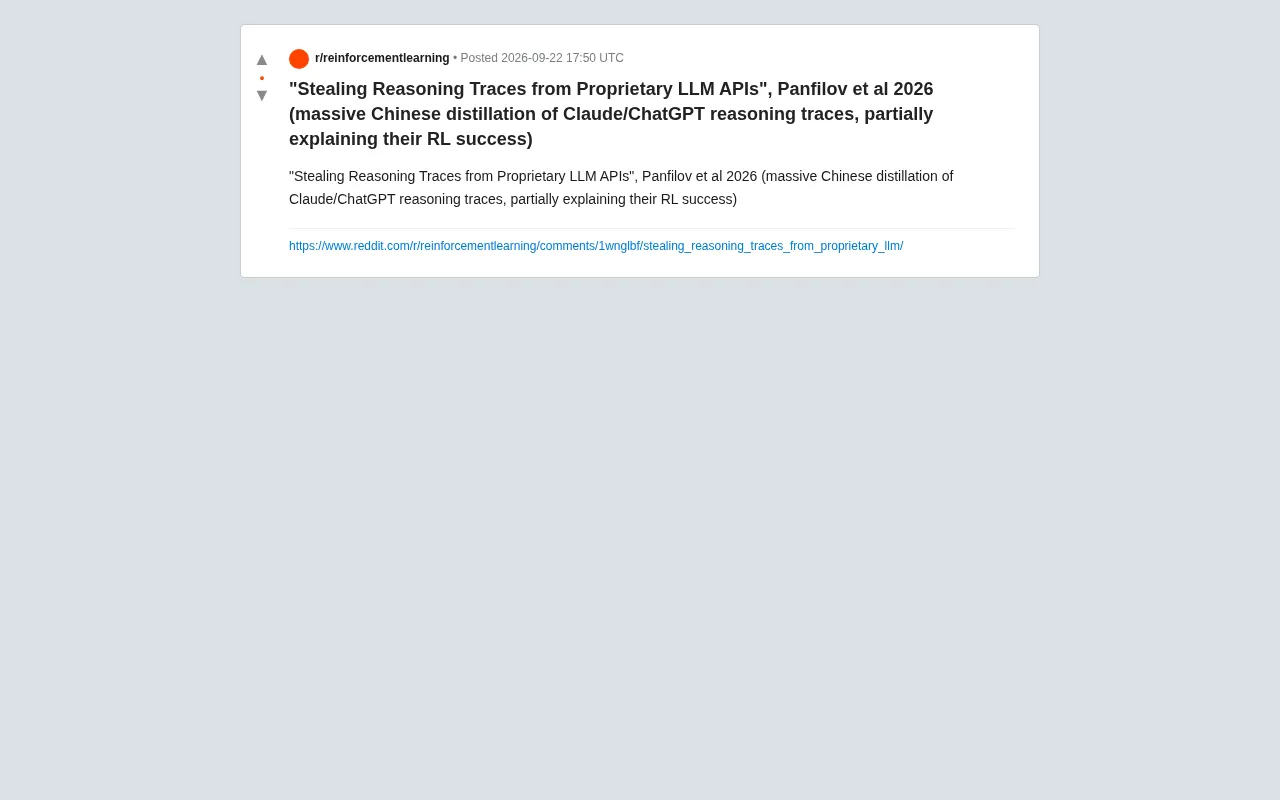
论文揭示闭源大模型API推理链可被大规模提取蒸馏,触及行业数据竞争的灰色地带。
一篇题为《Stealing Reasoning Traces from Proprietary LLM APIs》的论文近期在技术社区引发热议。论文聚焦一种已在业界流行但缺乏系统研究的做法:通过调用闭源模型(如 Claude、ChatGPT)的 API,批量提取其包含中间思考步骤的"推理链",再用于训练自研模型。由于高质量推理轨迹是强化学习训练的稀缺数据,人工构建成本极高,直接从强模型 API 蒸馏具有显著的经济动机。社区讨论中有观点认为这可能部分解释了某些模型推理能力的快速追赶,但论文本身并未给出确凿因果结论。这项研究的核心价值在于将这一"公开的秘密"纳入系统性学术分析,同时揭示了闭源 API 商业模式在知识产权保护上的结构性脆弱。
一篇引发讨论的论文
近日,一篇题为《Stealing Reasoning Traces from Proprietary LLM APIs》(Panfilov 等人)的论文在 Reddit 等技术社区引发热议。论文的核心议题围绕一个在业界并不新鲜、但一直缺乏系统性研究的现象:通过访问闭源大模型(如 Claude、ChatGPT)的 API,大规模地提取和蒸馏其推理链(reasoning traces),从而为自研模型的强化学习(RL)训练提供高质量数据。
讨论中一个颇具争议的观点是,这种大规模的推理链蒸馏,可能部分解释了近期部分模型在推理能力上的快速追赶。这一说法虽然尖锐,但也触及了当下大模型竞争中一个绕不开的灰色地带。
什么是推理链蒸馏
要理解这篇论文的意义,需要先厘清几个概念。传统的模型蒸馏(distillation)是指用一个强大的"教师模型"生成的输出,来训练一个更小或能力较弱的"学生模型"。这种做法在深度学习领域由来已久。
而所谓的"推理链"(reasoning trace),指的是模型在解决复杂问题时输出的中间思考步骤——也就是近年来推动模型能力跃升的"思维链"(Chain-of-Thought)。相比最终答案,这些中间推理过程往往蕴含更丰富的信息,包括如何拆解问题、如何验证中间结果、如何纠错。
论文所描述的攻击方式,本质上是通过合法或半合法地调用闭源模型 API,系统性地收集这些高价值的推理链数据,再用于训练自己的模型。这种做法之所以引发关注,是因为它触及了闭源厂商最核心的资产——不仅是模型权重,还有模型在推理过程中展现出的"思考方式"。
从技术实现角度看,推理链蒸馏与传统蒸馏有所不同。传统蒸馏通常只利用教师模型的最终输出(如 logits 或答案概率分布)来指导学生模型的训练;而推理链蒸馏则更进一步,将教师模型生成的完整思考过程作为监督信号。具体做法通常是:向目标 API 批量发送精心设计的数学、编程或逻辑问题,收集其返回的逐步推理文本,再将这些文本作为"金标准"轨迹对自研模型进行有监督微调(SFT)或强化学习训练。由于 o1、Claude 3.7 等模型的推理链往往包含反复尝试、自我纠错等复杂行为模式,这些轨迹的信息密度远超人工编写的示例,能够显著加速学生模型习得高阶推理策略的速度。
为什么推理链如此值钱
强化学习是当前提升模型推理能力的关键技术路径之一。无论是 OpenAI 的 o 系列还是其他前沿模型,高质量的推理数据都是 RL 训练的稀缺燃料。要从零构造这些数据,需要投入大量人工标注和算力成本。
如果能够直接从已有的强模型 API 中"抽取"出成千上万条经过验证的推理轨迹,相当于绕过了数据构建中最昂贵的环节。这也是为什么论文标题中用了"stealing"(窃取)这样带有明确价值判断的措辞——它暗示这种行为在获取竞争优势的同时,也存在明显的伦理与合规争议。
值得关注的是,许多闭源厂商已经意识到这一风险,并在其服务条款中明确禁止将 API 输出用于训练竞品模型。部分厂商甚至开始隐藏或压缩模型的原始推理过程,只向用户展示摘要后的思考步骤,正是为了防范此类蒸馏攻击。
强化学习在大模型推理训练中的典型范式是 RLHF(基于人类反馈的强化学习)或近年兴起的 GRPO、RLVR 等方法。这些方法需要大量"过程级"标注数据——即不仅标注最终答案是否正确,还要对推理路径的质量进行评估或提供正确的推理示范。以数学推理为例,构建一条高质量的人工标注推理轨迹,需要领域专家逐步写出解题过程,耗时且难以规模化。相比之下,调用一次强模型 API 的成本可能仅需几美分,却能直接获得一条经过模型内部验证的推理链。这种成本鸿沟正是蒸馏攻击具有强烈经济动机的根本原因,也解释了为何论文使用"stealing"而非"learning from"这类中性表述——它明确指向了一种不对等的价值转移。
灰色地带的技术竞争
Reddit 讨论中提到,这种大规模蒸馏"部分解释了"某些模型 RL 训练的成功。这一论断需要谨慎对待——它更多是社区基于观察的推测,而非论文给出的确凿因果结论。
客观地说,模型能力的提升是多因素叠加的结果:算法创新、数据工程、算力规模、训练技巧,都在其中扮演重要角色。将追赶完全归因于蒸馏,既低估了独立研发的价值,也可能过度简化了复杂的技术图景。但确实的是,推理链蒸馏作为一种低成本、高回报的技术手段,确实在行业中被广泛使用,只是很少被公开讨论。
这篇论文的价值,更多在于把这个"公开的秘密"摆到台面上进行系统性研究,让业界得以正视其技术机制、影响范围以及潜在的防御手段。
对行业的启示
从更宏观的视角看,这类研究揭示了闭源模型面临的一个结构性困境:只要模型通过 API 对外提供服务,其输出就无法完全避免被用于逆向蒸馏。厂商能做的,只是提高蒸馏的门槛和成本——比如限制输出细节、检测异常调用模式、在服务条款中设置法律约束。
对于开源社区和后发厂商而言,这项研究则提供了一种对提升模型推理能力路径的参考视角,同时也提醒相关方注意其中的合规风险。
需要强调的是,由于目前可获取的信息主要来自社区标题与简要描述,论文的具体实验方法、蒸馏规模、防御方案等细节仍有待查阅原文核实。本文的分析基于现有讨论,建议关注该领域的读者进一步阅读原始论文以获得完整结论。
防御推理链蒸馏在技术上面临本质性挑战。一方面,若过度压缩或隐藏推理过程,会直接损害模型对用户的可解释性和调试价值,与"透明 AI"的行业趋势相悖;另一方面,基于调用频率或问题模式的异常检测,很容易被攻击方通过分散请求、混入正常业务流量等方式绕过。目前学界探索的防御方向包括:在推理链中嵌入水印(watermarking)以溯源蒸馏来源,以及通过对抗性扰动使输出推理链对人类可读但对模型训练"有毒"。这些方法均处于早期研究阶段,尚未有成熟的工业级方案落地,这也是该论文引发广泛关注的原因之一——它不仅是攻击性研究,也隐含了对防御方向的系统性梳理需求。
结语
推理链蒸馏站在技术效率与知识产权的交叉点上,是大模型竞争进入白热化阶段的一个缩影。它既反映了行业对高质量推理数据的迫切需求,也暴露了闭源 API 商业模式的固有脆弱性。随着更多此类研究的公开,如何在开放服务与知识保护之间找到平衡,将成为整个行业需要持续面对的命题。
相关推荐
B站唯一讲透Harness Engineering?企业级多Agent协同实战解析
解析Harness Engineering企业级多Agent协同的核心组件:编排层、状态管理、安全隔离与可观测性。结合B站教程素材,讨论面试官为何开始追问工程约束,以及如何理性看待“唯一讲明白”类技术内容。
AI Agent全栈实战课:从0到1掌握双框架开发
B站AI Agent全栈实战课程导学解析:四阶段覆盖基础概念、LangChain精讲、单Agent实战与CrewAI多智能体进阶,含零配置环境工具与开源代码,适合有编程基础的开发者系统入门。
手写Agents.md,让AI编程稳定性大幅提升
B站UP主通过视频编辑器和卡牌游戏两个项目对比,揭示手写Agents.md和设计文档能显著提升AI编程稳定性,解释Agents.md与技能注入机制的区别,并给出文档驱动开发的实用方法。