QuanLing框架跨语支验证:量化西罗曼语系的语言距离

QuanLing框架用预训练语言模型量化语言距离,从北日耳曼语系成功扩展至西罗曼语系,验证跨语支普适性。
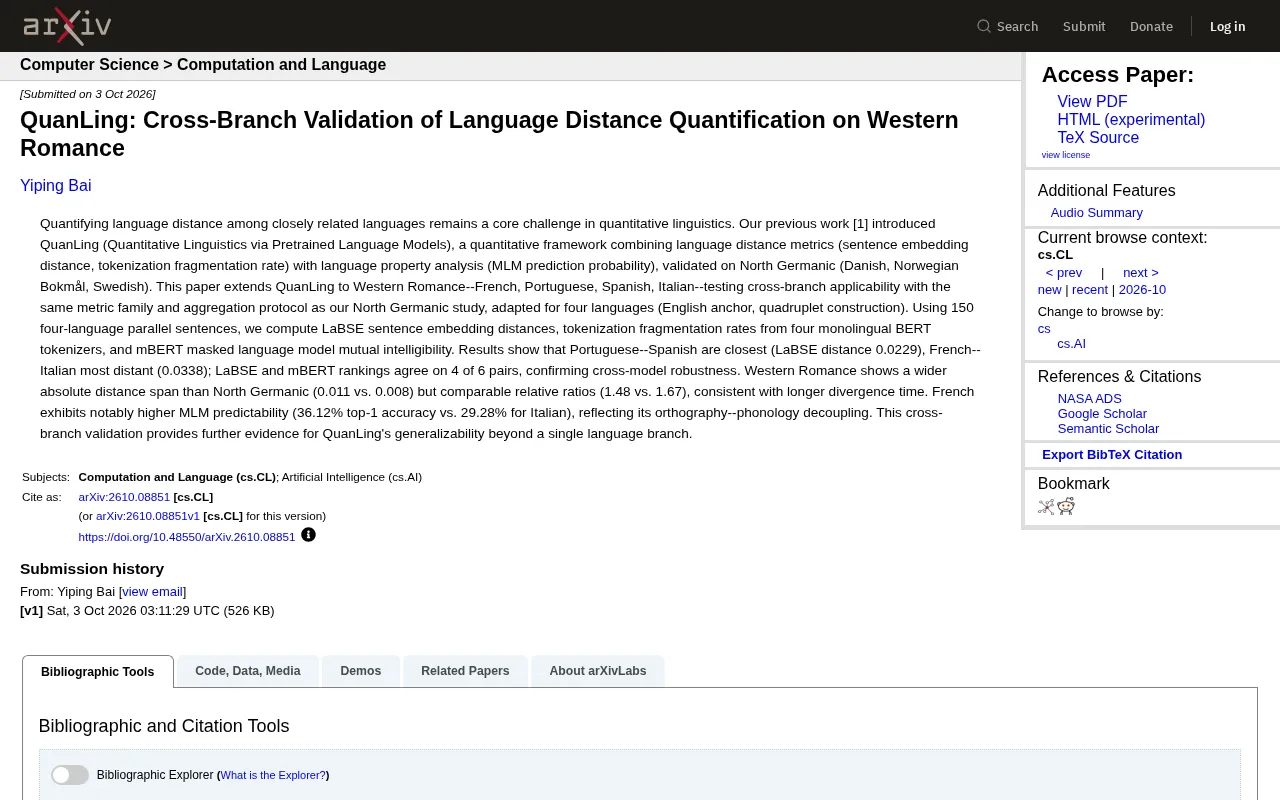
本文介绍了 QuanLing 框架在西罗曼语系(法、葡、西、意四种语言)上的验证研究。该框架通过三类指标——LaBSE 句子嵌入距离、分词碎片化率和 mBERT 掩码语言模型互通性——量化亲缘语言间的距离。核心发现包括:葡萄牙语与西班牙语最接近(LaBSE 距离 0.0229),法语与意大利语最疏远(0.0338);LaBSE 与 mBERT 在六组配对中四组排序一致,证明跨模型稳健性。与北日耳曼语系对比,西罗曼语系绝对距离跨度更大但相对比例相近,契合其更长的分化历史。法语因正字法—语音解耦特性展现出异常高的 MLM 预测准确率。两个语支的一致性结果为框架的可泛化性提供了超越单一语系的初步证据。
量化语言距离:一个长期未解的难题
在量化语言学领域,如何精确衡量亲缘关系密切的语言之间的距离,一直是核心挑战之一。这类语言彼此高度相似,传统的分类方法往往难以捕捉它们之间微妙的差异。近期发表于 arXiv 的研究(arXiv:2610.08851v1)给出了一个新的解法——QuanLing 框架(Quantitative Linguistics via Pretrained Language Models),通过预训练语言模型来实现语言距离的量化。
QuanLing 并非全新概念。研究团队在此前的工作中,已经将该框架应用于北日耳曼语系(丹麦语、挪威语书面语 Bokmål、瑞典语)并完成了初步验证。本篇论文的核心贡献在于把这套方法论推向了另一个语支——西罗曼语系,以此检验其跨语支的普适性。
三大指标:从嵌入距离到互通性
QuanLing 的方法论建立在一组指标家族之上,结合了语言距离度量与语言属性分析两个维度。
句子嵌入距离
研究使用 LaBSE(Language-agnostic BERT Sentence Embedding)模型,计算不同语言平行句子在向量空间中的距离。距离越近,意味着两种语言在语义表达层面越接近。
LaBSE(Language-agnostic BERT Sentence Embeddings)由 Google 于2020年提出,是一种专为跨语言语义对齐设计的句子编码模型,支持109种语言。与普通多语言模型不同,LaBSE 在训练时明确优化了「语言无关性」:对同一语义内容,无论使用哪种语言表达,模型都应将其映射到向量空间中的相近位置。训练数据包含大量双语平行语料,并使用对比学习目标(contrastive learning)拉近翻译对、推远非翻译对。正是这种设计使其特别适合作为语言距离的测量工具——两种语言在 LaBSE 空间中的平均距离,可以被解读为「语义表达层面的结构差异」,而非单纯的词汇或语法差异。
分词碎片化率
团队借助四个单语 BERT 分词器,测量分词碎片化率(tokenization fragmentation rate)。这一指标反映了一种语言在被另一语言训练出的分词器处理时,被切分得有多碎——碎片化程度某种意义上揭示了词汇层面的距离。
BERT 系列模型普遍使用 WordPiece 分词算法:若一个词汇在训练词表中出现,则作为整体 token 保留;若未出现,则被切分为更小的子词单元(subword),这些碎片化的子词通常以「##」前缀标记。当用 A 语言训练的分词器处理 B 语言文本时,B 语言中与 A 语言词汇重叠程度越低,碎片化率就越高。因此,碎片化率本质上衡量的是两种语言在书写词汇层面的重叠程度——对于共享大量词根和拼写的亲缘语言(如葡萄牙语与西班牙语),互相处理时碎片化率应相对较低,反之则较高。这一指标不依赖语义理解,纯粹从字符串模式角度提供了一个互补的距离维度。
掩码语言模型互通性
第三个维度借助 mBERT 的掩码语言模型(MLM)预测能力,衡量语言之间的「互通性」(mutual intelligibility)。模型在一种语言环境下对另一种语言的预测准确率,可以作为互相理解程度的代理指标。
本次西罗曼语系实验针对法语、葡萄牙语、西班牙语、意大利语四种语言展开,以英语作为锚点(anchor),构建四语组(quadruplet)结构,并采用了 150 组四语平行句子作为数据基础。为保证可比性,整套度量指标族与聚合协议均与北日耳曼语系研究保持一致,仅针对四语场景做了适配。
核心发现:谁最接近,谁最疏远
实验结果呈现出清晰的语言距离图谱。
葡萄牙语与西班牙语是四种语言中最接近的一对,LaBSE 距离仅为 0.0229——这与两种语言在历史与地理上的紧密联系相当吻合。而法语与意大利语则是距离最远的一对,LaBSE 距离达到 0.0338。
跨模型一致性是本研究的一个重要验证点。在六组语言配对中,LaBSE 的排序结果与 mBERT 的排序结果在其中 4 组上达成一致,这为 QuanLing 的跨模型稳健性(cross-model robustness)提供了实证支撑。两套独立的模型给出相似结论,说明测得的距离不是单一模型的偶然产物。
跨语支对比:绝对跨度更大,相对比例相近
将西罗曼语系与此前的北日耳曼语系结果对照,研究揭示了一个耐人寻味的规律。
西罗曼语系的绝对距离跨度更大(0.011 对比北日耳曼语系的 0.008),但相对比例却较为接近(1.48 对比 1.67)。研究者认为,这与西罗曼语系更长的分化时间(divergence time)相一致——语言分离得越久,彼此的绝对差异自然越大,但内部结构的相对关系仍保持可比的量级。
这一发现的意义在于:QuanLing 捕捉到的不仅是表面的距离数值,更是语言演化内在节奏的某种映射。
法语的特殊性:正字法与语音的解耦
一个值得深入的细节是法语在 MLM 预测上的表现。法语展现出明显更高的掩码语言模型可预测性,top-1 准确率达到 36.12%,而意大利语仅为 29.28%。
研究将这一差异归因于法语「正字法—语音解耦」(orthography–phonology decoupling)的特性。法语的书写形式与实际发音之间存在大量不对应(例如众多不发音的词尾字母),这种高度规则化却与语音脱节的拼写系统,反而让基于文本的语言模型更容易预测——因为书面模式本身更具可预测的规律性。这一观察为语言属性分析维度提供了一个具体而有力的案例。
法语的正字法—语音解耦现象在罗曼语系中尤为突出。典型例子包括:词尾辅音字母在大多数情况下不发音(「temps」发音为 /tɑ̃/,末尾 -mps 均哑音)、同一发音对应多种拼写(/o/ 可写作 o、au、eau、ô),以及大量连音(liaison)规则使书面词形与实际语流发音进一步分离。这种特性形成于中古法语至近代法语的演变过程中:书写系统倾向于保留词源拼写(etymological spelling),而口语发音却持续简化演变,两者逐渐脱节。对于基于文本预训练的语言模型而言,书面法语的高度规则性与词形稳定性反而创造了更强的 n-gram 预测信号,使得掩码预测任务在法语上更容易完成。
对框架普适性的意义
从北日耳曼语系到西罗曼语系,QuanLing 完成了一次跨语支的验证。相同的指标家族、相同的聚合协议,在两个起源不同、演化路径各异的语支上都给出了自洽且可解释的结果。
这为 QuanLing 的可泛化性(generalizability)提供了超越单一语支的进一步证据。对于量化语言学而言,这意味着预训练语言模型有望成为一种通用的、跨语系的语言距离测量工具,而不必为每个语系单独设计方法。当然,仅凭两个语支的验证尚不足以宣称完全通用,后续在更多语系(如斯拉夫语系、汉藏语系等)上的拓展,将是检验这一框架真正边界的关键。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。