Qwen 3.8 Flash Next深度解析:三大技术创新重塑开源AI格局
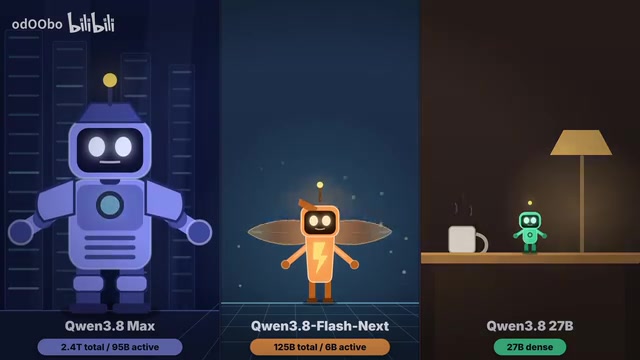
阿里巴巴推出的Qwen 3.8 Flash Next在开源AI领域引发广泛关注。这个采用混合专家架构(MoE)的模型,在首批测试中展现出与DeepSeek R1等大型闭源系统相媲美的性能,且完全免费开源。
Qwen 3.8 Flash Next架构创新:从密集到稀疏的跨越
Qwen系列模型呈现出清晰的产品线分层。顶级的Qwen 3.8 Max规模庞大,27B版本是传统的密集模型,适合高性能台式机或服务器。而3.8 Flash Next则采用了完全不同的技术路线——混合专家模型(Mixture of Experts)。
混合专家模型的概念最早可追溯到1991年Jacobs等人的研究,但近年来才在大规模语言模型中真正大放异彩。其发展经历了三个关键阶段:第一阶段是1991年的原始框架,将多个专家网络与竞争性门控机制结合;第二阶段是2017年Shazeer等人在Google提出的稀疏门控MoE层,首次将其扩展到数千亿参数规模;第三阶段则是2022年后以Switch Transformer和Mixtral为代表的工业化落地浪潮。其核心思想是:模型包含多个"专家"子网络,每次推理时由一个门控网络(Router)根据输入内容决定激活哪几个专家来处理当前token。例如一个总参数量为200B的MoE模型,每次推理可能只激活其中20B的参数,从而在保持大模型知识容量的同时大幅降低实际计算开销。MoE的关键设计决策包括专家数量、Top-K路由策略(每次激活几个专家)、负载均衡损失(防止部分专家过度使用而其他专家闲置)以及专家粒度的选择。Google的Switch Transformer和Mistral的Mixtral 8x7B都是MoE架构的代表性实践,而Qwen 3.8 Flash Next则将这一范式推向了新的高度。
这种架构的核心优势在于,处理每个token时只激活模型的一小部分参数。这使得它特别适合内存带宽受限的硬件环境,如NVIDIA的AGX Orin或Jetson平台。NVIDIA AGX Orin是面向边缘AI计算的系统级模块,搭载Ampere架构GPU,提供最高275 TOPS的AI算力和64GB统一内存,广泛应用于自动驾驶、机器人和工业视觉等场景。在这类边缘设备上运行大语言模型的主要瓶颈是"内存墙"问题——模型推理的每一步都需要从内存中加载权重参数,其速度受限于内存带宽而非计算吞吐量,这被称为memory-bound计算。以AGX Orin为例,其内存带宽约为204GB/s,而数据中心级的H100 GPU可达3.35TB/s,差距超过16倍。MoE架构因为每次只激活少量参数,显著减少了内存读取量,因此尤为适配。量化(将FP16权重压缩为INT4/INT8)和KV Cache优化等技术也进一步缓解了这一瓶颈。在双AGX Orin系统上的实测显示,推理速度可达38 tokens/秒——这意味着用户每秒可获得约30-40个汉字的生成速度,已达到流畅对话的体验阈值,对边缘设备而言相当可观。社区开发者更是迅速将其移植到更低配置的硬件上运行。
三大核心技术突破详解
Qwen稀疏注意力机制(QSA)
传统的全注意力机制(Full Attention)具有二次方复杂度——上下文长度翻倍,计算成本增加四倍。这在长文本对话中会导致性能急剧下降和成本飙升。
具体而言,Transformer的自注意力机制要求序列中每个token都与其他所有token计算相关性分数,其时间和空间复杂度均为O(n²),其中n为序列长度。当上下文从4K扩展到128K甚至更长时,计算量和显存占用呈爆炸式增长。业界已提出多种应对方案,形成了丰富的技术谱系:Longformer提出了局部滑动窗口加全局token的混合方案;BigBird在此基础上加入随机注意力连接;Reformer使用局部敏感哈希(LSH)将相似token分组。Flash Attention由Tri Dao提出,通过IO感知的分块计算优化了实际运行速度——将计算分块以适配GPU的SRAM层级,减少了HBM(高带宽内存)的访问次数,在实践中实现了2-4倍的加速,但未改变理论复杂度。线性注意力通过核函数近似将复杂度降至O(n),但可能牺牲表达能力;滑动窗口注意力则只关注局部上下文。
DeepSeek曾提出DSA(DeepSeek Attention),通过选择性关注重要token来缓解这一问题。Qwen的QSA则更进一步:它将token打包成小块(blocks),只在这些块之间进行注意力计算。这种块级稀疏注意力属于结构化稀疏的范畴,在效率和表达能力之间取得了较好的平衡。相比逐token的非结构化稀疏,块级操作更利于GPU的并行计算特性,能够充分利用硬件的矩阵运算单元(如NVIDIA的Tensor Core),因为GPU在处理规整的矩阵块时效率远高于处理散乱的稀疏索引。QSA的块级稀疏方案与Flash Attention类的硬件级优化形成互补——QSA在算法层面减少了需要计算的注意力对数量,而Flash Attention在硬件层面提升了每个计算操作的效率。两者叠加进一步降低了长上下文处理的开销,使模型能够更高效地处理扩展对话和大型文档。
门控残差连接(Gated Residual)
在传统Transformer中,各层共享同一个残差流,容易出现"相互干扰"——后续层可能覆盖前面层提取的重要信息。
残差连接(Residual Connection)由何恺明在2015年提出的ResNet中首次引入深度学习领域,其核心思想是将输入直接跳过若干层加到输出上,即y = F(x) + x。这一设计从根本上缓解了深层网络的梯度消失问题,使训练数百层乃至上千层的网络成为可能。在此之前,即便使用精心设计的初始化和归一化方法,超过几十层的网络也往往因梯度消失而难以有效训练。ResNet的成功直接启发了Transformer的设计——Vaswani等人在2017年提出的原始Transformer架构中,每个注意力层和前馈网络层都使用残差连接,所有信息通过一个共享的"残差流"(residual stream)逐层累积传递。然而随着模型深度增加到数十层甚至上百层,不同层向残差流写入的信息可能相互冲突,导致早期层提取的关键特征被后续层的更新所稀释甚至覆盖。这一现象在可解释性研究中被称为"特征干扰"或"表示坍塌"。
Qwen引入了四分支的门控残差机制,允许不同类型的信息在独立通道中流动。
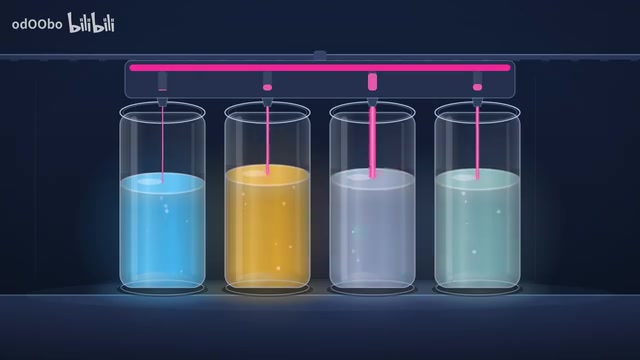
这种设计通过引入可学习的门控参数(通常实现为sigmoid激活函数产生的0-1之间的标量或向量),让模型自主决定每个分支的信息应以多大权重写入残差流,从而实现更精细的信息流控制。这与LSTM(长短期记忆网络)中的门控机制有异曲同工之妙——LSTM正是通过遗忘门、输入门和输出门来精确控制信息的保留与更新,从而解决了传统RNN的长程依赖问题。模型能够选择性地保留某些信息流不变(门控值接近0时信息直通),同时对其他分支进行更新(门控值接近1时允许新信息写入)。类似于ResNet中的跳跃连接,但更加灵活和可控,有效缓解了深层网络中的梯度消失和信息退化问题。这种多分支设计也为模型提供了更丰富的表示空间,使不同类型的语义信息(如语法结构、实体关系、上下文逻辑等)能够在各自的通道中独立演化而不相互干扰,类似于计算机网络中虚拟通道隔离不同类型流量的设计思想。
N-gram嵌入记忆
"hot dog"(热狗)的语义与"hot"(热的)和"dog"(狗)单独理解截然不同。这揭示了语言理解中一个根本性挑战:词语的组合含义往往不等于各部分含义的简单加总,语言学中称之为"组合性原则的例外"或"非组合性表达"。
N-gram是自然语言处理中最经典的概念之一,指文本中连续的N个词或字符的组合(N=1为unigram,N=2为bigram,N=3为trigram)。早在统计语言模型时代,N-gram就是文本建模的核心工具——通过统计N个词共现的概率来预测下一个词。在现代神经网络中,虽然上下文建模能力远超传统统计方法,但模型仍然可能在组合语义上出现理解偏差——因为子词分词器(如BPE,即字节对编码)会将词拆分为更小的单元,这一过程中短语级别的整体语义信息可能被割裂。BPE最初由Sennrich等人在2016年从数据压缩领域引入NLP,通过迭代合并最频繁出现的字符对来构建词表,例如"playing"可能被拆分为"play"和"ing",而"kickback"(回扣)可能被拆分为"kick"和"back",模型需要多层推理才能重建其整体含义。中文场景下这一问题同样突出,如"马上"被理解为"马"+"上"而非"立刻"的含义。Qwen通过N-gram嵌入为短语级token组合建立了专门的查找表,本质上为这些高频组合提供了一条"语义快捷通道",让模型在输入阶段就能直接获取短语级语义向量,而不必完全依赖后续Transformer层的上下文推理来"重建"这些含义。
这是对DeepSeek技术的改进:DeepSeek将这种查找记忆分散在多个层中,虽然灵活但增加了架构复杂度和推理路径长度——每一层都需要执行额外的查找操作,且层间的查找结果需要协调整合。Qwen将其集中在模型前端的一个大型查找层,这种设计简化了架构,减少了推理时的层间依赖,加速了前向传播,并提升了模型对常见短语和习语的理解能力。这种前置化的设计哲学意味着模型在处理的最早阶段就建立了丰富的短语级表示,为后续深层的推理和生成奠定了更坚实的语义基础。从工程实现角度看,前置查找层还有一个隐含优势:它可以被高度优化为一次性的哈希表或嵌入矩阵查找操作,其计算开销远低于Transformer层中的注意力计算,因此不会成为推理的性能瓶颈。
性能基准测试与实际应用场景
据首批测试结果,Qwen 3.8 Flash Next在多项基准测试中已接近甚至超越部分最优秀的开源模型,某些任务上甚至可与体量大得多的DeepSeek R1 Pro相媲美。这些基准测试通常涵盖多个维度:数学推理(如GSM8K、MATH)、代码生成(如HumanEval、MBPP)、知识问答(如MMLU、ARC)以及多轮对话能力等。考虑到这只是"Next"系列的第一个版本,且发布仅数天,这样的表现令人印象深刻。值得注意的是,由于MoE架构的稀疏激活特性,Qwen 3.8 Flash Next虽然总参数量可观,但实际推理时的计算成本和延迟远低于同等总参数规模的密集模型,这使得性能与效率的对比更具实际意义。
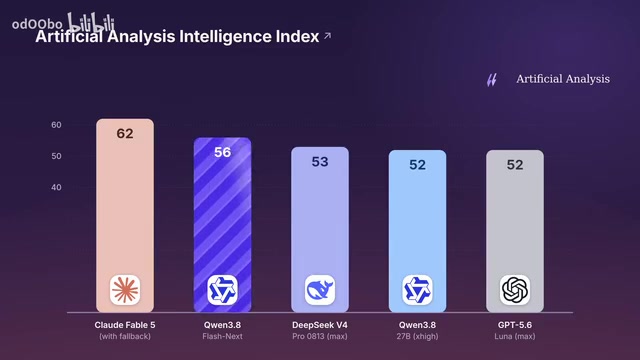
更重要的是,作为开源模型,用户可以永久免费下载、部署和商用,无需支付任何订阅费用。这为AI民主化提供了重要支撑——企业和个人开发者都能以极低成本获得接近商业闭源系统的能力。对于中小企业和独立开发者而言,这意味着他们无需承担每月数千美元的API调用费用(以GPT-4 API为例,处理100万输入token的费用约为30美元,高频应用场景下月度成本可轻松突破万元),即可在本地或私有云上部署高质量的AI推理能力,同时完全掌控数据隐私和模型定制权。在金融、医疗、法律等对数据合规要求极高的行业,本地部署开源模型几乎是唯一可行的方案。
开源AI生态的里程碑意义
这款模型的发布再次印证了一个趋势:开源AI正在快速缩小与闭源商业系统的差距。从GPT-4到Claude,再到现在的DeepSeek和Qwen,付费订阅模式正面临开源替代方案的有力挑战。
AI模型的开源与闭源之争是当前行业最重要的战略分歧之一。OpenAI的GPT系列和Anthropic的Claude代表了闭源路线,通过API付费或订阅模式盈利,其优势在于更完善的安全对齐(通过RLHF即基于人类反馈的强化学习进行精细调优)、更稳定的服务保障和持续的资金投入。而Meta的LLaMA系列在2023年率先打开了大模型开源的大门——LLaMA的发布被广泛视为AI领域的"Linux时刻",它证明了开放权重的大模型可以催生出远超单一公司能力的创新生态。随后Mistral、阿里Qwen、DeepSeek等纷纷跟进,形成了蓬勃的开源AI生态。开源模型的优势包括:透明可审计的架构便于学术研究和安全审查、本地部署保障数据隐私合规(特别是在GDPR和中国《数据安全法》等法规框架下)、社区协作加速技术迭代(Hugging Face平台上已有超过100万个开源模型)、以及零边际成本的部署使用。当前的趋势是开源模型在性能上快速追赶,迫使闭源厂商不断提升差异化能力和服务附加值——这形成了一种推动整个行业前进的健康动态。
对于开发者而言,这意味着更大的选择自由和更低的迁移成本。对于AI研究社区,这种技术细节的公开披露(包括配套论文)促进了整个领域的知识传播和创新加速。开源模型还催生了丰富的二次开发生态:微调(Fine-tuning)、量化部署、RAG(检索增强生成)集成、以及针对特定领域的适配等,都建立在可获取的模型权重和架构细节之上。
稀疏注意力、门控残差、N-gram嵌入这三大技术创新,不仅提升了Qwen自身的性能,也为后续模型设计提供了可借鉴的范式。这些创新并非孤立存在,而是体现了当前大模型研发的一个重要方向:在Transformer的基本框架内进行精细化的架构改进,通过结构化稀疏、信息流控制和前置语义编码等手段,在不大幅增加参数规模的前提下提升模型能力和效率。当如此多优秀的开源AI系统不断涌现,整个行业的创新速度和技术普惠程度都在以前所未有的节奏向前推进。这种良性竞争最终将惠及每一位AI技术的使用者——无论是构建下一代智能应用的工程师,还是享受AI服务的普通用户。
相关推荐
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。