Qwen-Image 2.1 数据集生成器:LoRA训练人脸素材新工作流
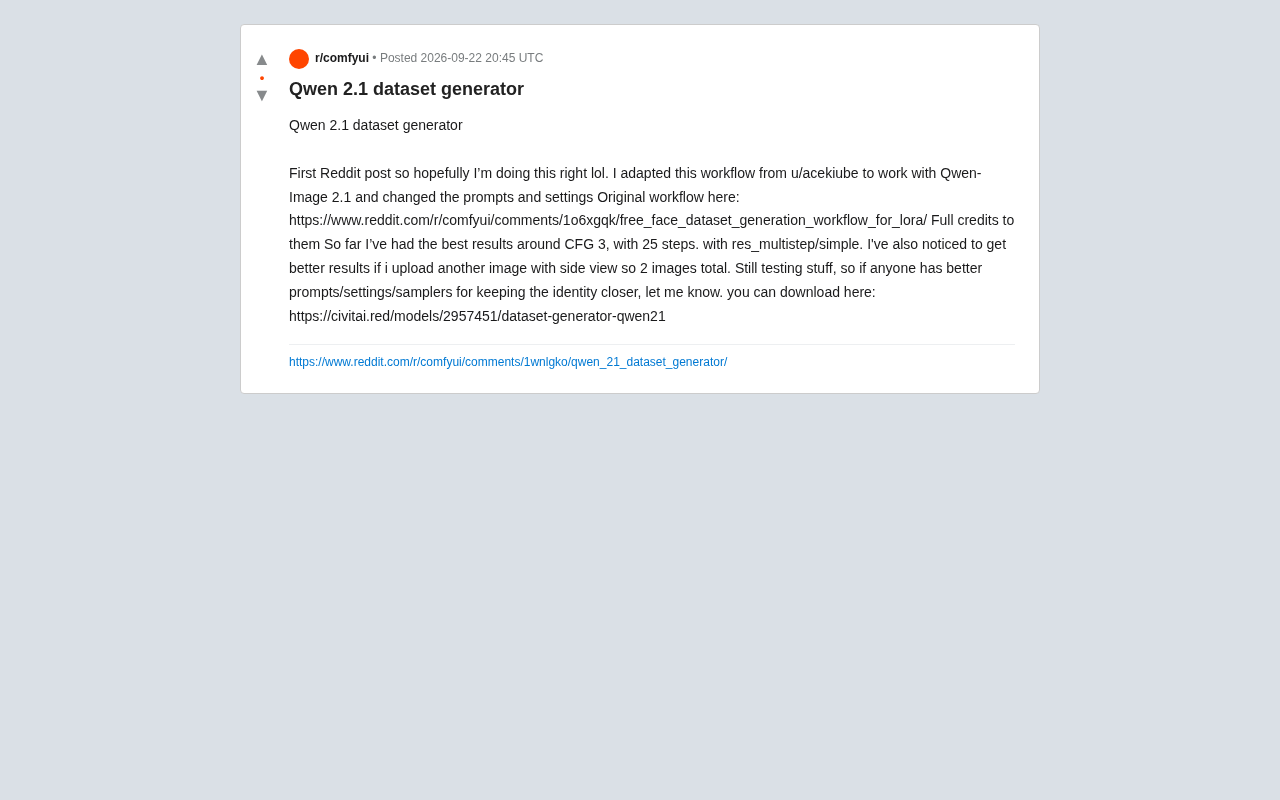
基于Qwen-Image 2.1的ComfyUI工作流,用少量参考图自动生成高一致性人脸LoRA训练数据集。
这篇文章介绍了一套由Reddit社区用户改编、基于Qwen-Image 2.1模型的ComfyUI工作流,专门用于为LoRA训练自动生成人脸素材数据集。工作流的核心推荐配置为CFG 3、25步采样、res_multistep/simple采样器组合,并通过同时上传正面与侧面两张参考图来显著提升生成人脸的身份一致性。作者坦言该工作流仍处于测试阶段,已将其发布于Civitai平台征集社区反馈并持续迭代。从实用角度看,此类工具大幅降低了个人创作者构建定制化训练集的门槛,但使用时需注意参考图来源的合规性与肖像权问题。
一个面向LoRA训练的开源工作流
在AI图像生成领域,训练一个高质量的LoRA模型往往受制于素材数据集的质量与一致性。近日,一位Reddit用户在r/comfyui社区分享了一套基于 Qwen-Image 2.1 的数据集生成工作流,专门用于快速生成人脸训练素材。
这套工作流并非完全原创,而是改编自社区创作者 u/acekiube 的免费人脸数据集生成方案。原作者的工作流面向通用ComfyUI环境,而这次的改动核心在于将其适配到 Qwen-Image 2.1 模型,并针对性地调整了提示词(prompts)与运行参数。作者在帖子中明确给出了完整署名与原始工作流链接,体现了开源社区互相借鉴、迭代改进的协作方式。
LoRA(Low-Rank Adaptation) 是一种参数高效的模型微调技术,最初由微软研究院提出,后被广泛应用于Stable Diffusion等图像生成模型的定制化训练。其核心思想是在不修改原始模型权重的前提下,通过在注意力层插入低秩矩阵来"注入"新的概念或风格。相比全量微调,LoRA训练所需的计算资源和训练数据量要少得多——通常只需十几到几十张高质量图像,即可让模型学会还原特定人物的外观特征。正因如此,训练数据集的质量(尤其是人脸角度的多样性与图像一致性)直接决定了最终LoRA模型的还原精度,这也是自动化数据集生成工作流的核心价值所在。
关键参数配置:CFG 3 与 25 步
对于实际使用者而言,工作流最有价值的部分往往是经过反复验证的参数组合。根据作者的测试经验,目前效果最佳的配置为:
- CFG(提示词引导强度):约 3
- 采样步数(Steps):25 步
- 采样器/调度器:res_multistep / simple
较低的 CFG 值(3)在 Qwen-Image 2.1 上通常能带来更自然、更少"过拟合"感的输出,而 25 步的采样在生成质量与速度之间取得了平衡。res_multistep 采样器配合 simple 调度器的组合,是作者当前实测下身份一致性表现较好的搭配。
双图输入提升身份一致性
一个值得关注的实践细节是:作者发现上传两张参考图能明显改善结果。具体做法是在正面照之外,额外提供一张侧面视角(side view)的图像,总计两张输入图。
这一技巧背后的逻辑在于,单张正面照难以让模型充分理解人脸的三维结构,而侧面信息能补足面部轮廓、鼻梁、下颌线等在正面视角中被压缩的特征,从而在生成多角度素材时更好地保持同一身份(identity)的稳定性。对于LoRA训练而言,身份一致性正是决定最终模型效果的核心指标之一。
CFG(Classifier-Free Guidance) 即无分类器引导强度,控制生成图像对提示词的服从程度。数值越高,图像越贴近文本描述,但也越容易出现过饱和、细节失真等"过拟合"问题;数值越低,图像则更自然流畅,但可能偏离提示词意图。传统Stable Diffusion工作流常用CFG 7-12,而新一代图像模型(如基于Flow Matching架构的模型)由于训练方式不同,往往在CFG 2-5的低区间表现更佳。Qwen-Image 2.1属于此类新架构模型,因此CFG 3的推荐值符合其设计特性,并非异常低值。
仍在迭代中的开源尝试
作者坦言这套工作流仍处于测试阶段,并公开征集社区反馈——尤其是在提示词、参数设置和采样器选择上,希望找到能让生成结果更贴近原始身份的方案。这种"边分享边迭代"的态度,恰恰是ComfyUI生态繁荣的缩影:一个工作流从原作者流向改编者,再通过社区反馈持续优化。
工作流文件已发布在 Civitai 平台,用户可自行下载并在本地ComfyUI环境中运行测试。
对AI创作者的实用意义
从更宏观的角度看,这类数据集生成工作流降低了个人创作者训练定制化模型的门槛。过去,构建一套多角度、光照一致的人脸数据集需要大量手工拍摄或筛选素材;而借助 Qwen-Image 2.1 这样的图像模型,创作者可以从少量参考图快速衍生出成规模、风格统一的训练集。
当然,这类工具也伴随着关于肖像权与身份合成的伦理讨论。使用者在借助此类工作流生成人脸数据时,应确保参考图来源合规,避免用于未经授权的身份仿冒。
对于希望尝试的用户,建议从作者提供的默认参数(CFG 3、25 步、res_multistep/simple、双图输入)起步,再根据自身素材特点微调,逐步找到最适合的配置。
ComfyUI 是一款基于节点图(Node Graph)界面的Stable Diffusion前端工具,用户可以通过连接不同功能模块(节点)来构建自定义的图像生成流程,而无需编写代码。与WebUI等线性界面不同,ComfyUI的工作流可以被保存为JSON文件并在社区中共享,使得复杂的多步骤生成流程得以标准化、可复现地传播。Civitai 则是目前最主要的AI模型与工作流共享平台,聚集了大量LoRA模型、检查点和ComfyUI工作流资源,是个人创作者获取和发布社区成果的核心渠道。
相关推荐
从奥斯卡到SVM算法:John Platt谈AI如何重塑科学研究
谷歌奥斯卡得主 John Platt 谈 AI 如何重塑科学研究:从 sklearn 中的 SVM 算法到自动化科学、气候变化应对,以及超级智能时代下一代人如何为科学做贡献。
Snorkel AI估值翻三倍达35亿美元,AI训练数据成新风口
AI数据服务公司Snorkel AI完成3.5亿美元E轮融资,估值翻三倍至35亿美元。本文解析AI训练数据为何成为资本新风口,以及数据即服务模式背后的行业信号。
LangSmith成本失控?大规模场景下的LLM可观测性替代方案盘点
LangSmith在大规模场景下成本持续攀升,越来越多AI工程团队开始寻找替代方案。本文盘点Langfuse开源自托管与orqai一体化平台两大迁移路线,剖析成本、运维与决策门槛的核心权衡。