Qwen3 27B本地实测:小模型智能体能力反超Opus旗舰
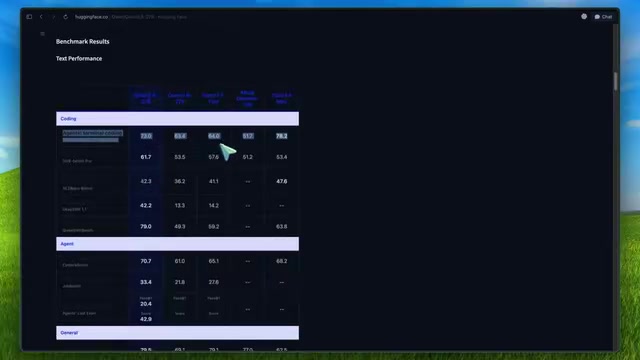
Qwen3 27B开源本地模型在软件工程与电脑操作等智能体任务上反超Opus 4.6 Max,可搭配Ollama/LM Studio零成本部署。
Qwen团队发布了27B参数的开源视觉语言模型Qwen3 27B,采用Apache 2.0许可证。尽管推理天花板(HLE 30.8)明显低于前沿闭源模型,但该模型在真实智能体任务上表现出乎意料地强:SWE-bench Pro得61.7分、OS World得84.3分、CoworkBench得70.7分,均超过Opus 4.6 Max。模型原生支持视觉输入,上下文达262K tokens(可扩展至100万),采用混合DeltaNet架构以控制显存消耗,并提供三档思考强度控制。部署推荐Ollama或LM Studio而非VLLM,并强调必须手动配置上下文长度与采样参数。配合开源框架Hermes Agent,可搭建具备持久记忆、工具调用和子智能体能力的完整本地智能体栈,每个token零成本。其定位是处理「量大但不困难」的长流程智能体工作,而非取代前沿推理模型。
开源模型的进化速度总是超出预期。当Qwen团队推出2.4万亿参数的旗舰闭源模型时,同步承诺会开放一个27B的小尺寸版本——而这恰恰是普通开发者真正关心的那一个。毕竟没人能在家里跑动一个2.4万亿参数的怪兽,但27B的模型,你完全可以塞进自己的显卡里。
现在这个模型来了。权重已经上传到Hugging Face,采用Apache 2.0许可证。海外知名AI测评博主对其进行了深度实测,结论颇为意外:这个能在本地运行的27B模型,在多项真实智能体任务上竟然反超了旗舰闭源模型Opus 4.6 Max。
一个专为本地智能体设计的大脑
博主在视频开头就澄清了一个关键点:他没有把这个模型放进自己的常规评测榜(KingBench)。原因不是遗忘或时间不够,而是「这个模型根本不是为我的榜单准备的」。
他的评测榜专门用来区分前沿模型之间的高下——硬核推理题、刁钻的计数任务、长周期智能体任务等等,目的是找出Opus、GPT-5.6、Qwen3 Max这类顶级模型的能力天花板。如果把一个27B开源模型丢进去,它必然得分难看,然后一堆人会误以为「这模型不行」。但这是完全错误的结论。
因为这个模型的定位根本不是「推理选美冠军」,而是要做一个「优秀的本地智能体大脑」——这是完全不同的工作。
从架构上看,它基于Qwen3.5架构基础,是一个原生的视觉语言模型,能原生理解图像和视频,从STEM图表、文档一直到长视频。架构采用混合设计,64层中大部分是门控DeltaNet模块,周期性混入门控注意力模块。这种设计让它能处理超长上下文而不会让显存爆炸。原生上下文达到262,144 tokens,通过YARN等RoPE扩展技术可延伸到完整的100万tokens——对一个27B模型来说近乎离谱,这已经和前沿托管模型一个量级,但它跑在你自己的机器上。
门控DeltaNet是一种线性注意力机制的变体,与传统Transformer的标准自注意力不同。标准自注意力的计算复杂度随序列长度呈平方级增长(O(n²)),这意味着当上下文达到数十万tokens时,显存消耗会变得难以承受。DeltaNet通过引入Delta规则(一种来自联想记忆研究的更新机制)来近似注意力计算,将复杂度压缩为线性(O(n))。「门控」则是指在此基础上加入可学习的门控机制,让模型动态决定哪些历史信息值得保留、哪些可以遗忘,而不是像早期RNN那样粗暴地混合所有历史。Qwen3 27B的64层架构中以DeltaNet为主、周期性插入标准注意力层,这种混合设计试图兼顾两者的优势:线性层保证长序列下的显存效率,标准注意力层在关键位置提供精确的全局信息检索能力。这正是它能在本地硬件上处理26.2万乃至百万token上下文的架构基础。
智能体任务上的惊人数据
真正让人坐直身子的是它的实测数据。在SWE-bench Pro上,它拿到61.7分,而Qwen3.7+是57.6分,Opus 4.6 Max只有53.4分。一个本地运行的27B模型,在真实世界的软件工程任务上击败了前沿托管模型,这不是笔误。
更多数据同样亮眼:Terminal Bench 2.1上从上一代27B的63.4跳到73.0;自家Qwen SWE-bench从49.3暴涨到79.0;Deep SWE 1.1从13.3飙升到42.2,这个跨代提升幅度堪称荒谬。在CoworkBench上得70.7,超过Opus的68.2;指令跟随的IF-Bench拿到79.5,而Opus只有62.5;LiveCode Bench V6更是以90.3分位居整张榜单榜首。
不过在纯推理层面,它很诚实地承认了差距。GPQA Diamond为89.2尚可但低于Opus,HLE只有30.8,明显落后于Opus的40.0。博主认为这正是他想看到的差距——它是「前沿邻近的智能体」,而非「前沿推理者」。
最令人意外的是视觉与电脑操作能力。在真实电脑操作测试OS World Verified上,它拿到84.3分,Qwen3.7+是73.3,Opus 4.6 Max是72.7——这个27B本地模型是整个对比中最强的电脑操作模型。浏览器操作Web Arena从48.5升到64.8,移动端Android World达到81.9,多模态软件工程SWMM上以38.6超过Opus的27.1。这是一个能看懂屏幕、理解画面、并真正操作它的模型,而且27B本地、Apache 2.0。
SWE-bench是目前最受认可的软件工程能力真实评测基准之一,要求模型直接修复来自真实GitHub仓库的issue——给定代码库和问题描述,模型需要定位问题、编写补丁并通过测试套件。SWE-bench Pro是其更严格的升级版,增加了更复杂的多文件修改任务和更严苛的测试验证,更难被「刷榜」。OS World则专门评测模型在真实操作系统环境中的GUI操作能力,包括在截图中识别UI元素、执行点击/输入/拖拽等操作、并完成跨应用的多步任务——这与「描述如何操作」有本质区别,是模型真正「接管鼠标键盘」的能力测试。这两项基准之所以有参考价值,在于它们衡量的是模型在现实工作场景中的实际完成率,而非选择题或代码补全这类相对局部的能力。
思考控制与运行部署
对智能体工作流至关重要的是思考控制能力。模型提供三档推理强度:X-high(默认,用于需要深度分析的复杂任务)、medium(平衡准确度与速度)、low(优化速度与成本的高效推理)。思考模式默认开启,可通过enable_thinking参数按请求关闭。
还有一个preserve_thinking参数,能在多轮对话中保留推理上下文,而不是每次都丢弃。任何看过本地模型在多步任务中途忘记自己计划的人,都会明白这有多重要。博主建议:机械性的枯燥智能体步骤用low或medium,真正需要动脑的部分才留给X-high,否则你会浪费大量时间看它「思考要不要读一个文件」。
在部署方面,博主这次一反常态,不再推荐VLLM,转而推荐Ollama和LM Studio。「对大多数人来说这才是正确答案,我之前把事情搞复杂了。」VLLM适合多GPU机器为团队服务,但对单人单机跑智能体来说,只是徒增大量Python环境配置的痛苦,却没有任何收益。
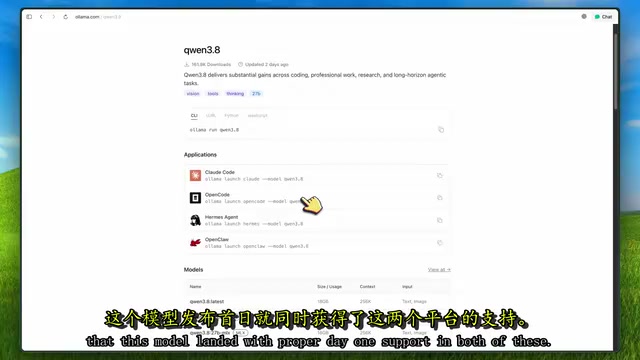
好消息是这个模型两边都获得了首日支持。Hugging Face上已有约278个量化变体,包括来自Unsloth、Bartowski、GGML.org和LM Studio社区的GGUF,以及为Mac用户准备的4-bit和8-bit MLX构建。
YARN(Yet Another RoPE extensioN)是一种用于扩展大语言模型位置编码范围的技术。RoPE(旋转位置编码)是目前主流LLM广泛采用的位置编码方案,但模型在训练时只见过固定长度的序列,直接推理时若超出训练长度会导致性能急剧下降。YARN通过对不同频率的位置编码分量进行差异化缩放,使模型能够泛化到远超训练长度的上下文,同时尽可能保留在训练长度内的性能。相比早期的线性插值或NTK-aware缩放等方法,YARN在长文本的困惑度和任务完成率上表现更稳定。Qwen3 27B原生训练上下文为262,144 tokens,借助YARN可将上下文窗口延伸至100万tokens,但需注意:极长上下文下模型检索能力通常会随距离增加而衰减,并非所有信息都能被同等有效地利用。
Ollama与LM Studio实操要点
Ollama是最简单的选择,模型已进入官方库,直接ollama pull qwen3:27b即可。默认标签约18GB,支持256k上下文,且文本与图像能力都保留(很多时候视觉模型被量化成纯文本版就失去了一半意义)。Apple Silicon用户应使用qwen3:27b-mlx标签,性能远好于通用GGUF。
博主特别强调一个「最重要的事」:设置Ollama的上下文长度。Ollama不会自动使用模型的完整上下文,而是用配置的num_ctx,默认值很小。你可能pull了一个支持25.6万tokens的模型,却用几千token的窗口运行它,然后纳闷智能体为什么三步之后就忘了自己在干什么。「这就像买了辆跑车却一直挂在一档。」
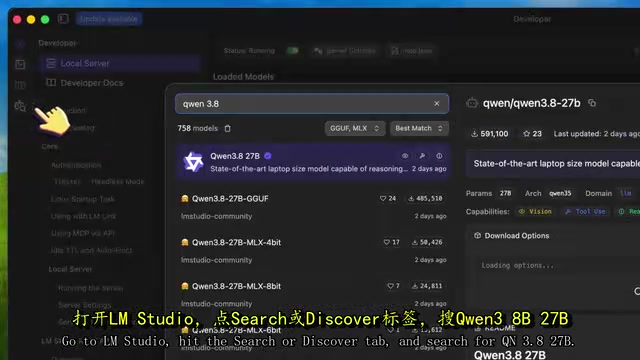
LM Studio则适合想要图形界面和更多控制的用户。它会在下载前告诉你某个量化版本能否装进你的硬件,这对新手极为友好。加载时可以设置上下文长度、GPU层卸载、开启Flash Attention。显存吃紧时,可用KV Cache量化选项把缓存降到8-bit,用极小的质量代价换取大得多的上下文——对智能体工作来说这个交易几乎总是划算的。注意LM Studio的端口是1234,与Ollama的11434不同,混淆两者是经典的五分钟debug陷阱。
采样参数也需注意:思考模式建议temperature 1.0、top-p 0.95、top-k 20;非思考的instruct模式为temperature 0.7、top-p 0.8、top-k 20、presence penalty 1.5。默认采样设置会让模型表现明显变差,然后你会错怪模型。
KV Cache(键值缓存)是Transformer推理时的核心加速机制:模型在生成每个新token时,需要访问所有历史token对应的Key和Value向量,KV Cache将这些向量存储在显存中避免重复计算。问题在于,随着上下文长度增加,KV Cache的显存占用线性增长——对于262K上下文的模型,这部分开销可能远超模型权重本身。KV Cache量化(如降至8-bit甚至4-bit)通过降低这些向量的数值精度来压缩显存占用,代价是引入微小的计算误差。对智能体工作负载而言,这个取舍通常是合算的:智能体任务更依赖模型能「记住」长流程中的上下文(需要大窗口),而对每一步的精确数值计算要求相对较低,因此用轻微的精度损失换取更大的可用上下文窗口,往往能带来更好的端到端任务完成率。
Hermes Agent:完整的本地智能体栈
视频的核心落在Hermes Agent上。这是一个开源智能体框架,具备持久记忆、供应商路由、子智能体、消息集成等能力,且不锁定单一厂商。
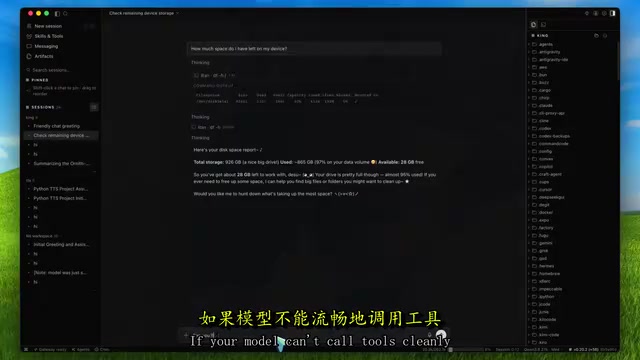
Hermes的生死系于工具调用——它的全部意义在于让智能体真正去做事。如果模型不能干净地调用工具,Hermes就退化成一个花哨的聊天机器人。而Qwen3 27B的核心卖点正是「更强的自主规划和更好的环境反馈处理,带来更可靠的端到端任务完成」,这恰恰是Hermes需要的。
值得一提的是,Ollama和LM Studio都内置处理了工具调用解析,无需手动传parser标志或折腾Jinja模板。此外Hermes的子智能体会继承父模型配置,避免长任务中途出现供应商不匹配的怪问题。
把这些拼起来:27B模型跑在你自己的硬件上,26.2万tokens上下文,内置视觉能看截图和图表,工具调用真正可用(OS World 84.3、Web Arena 64.8),再加上Hermes做编排、记忆和子智能体——这是一套完整的本地智能体栈,而且每个token零成本。
它的边界在哪里
博主坦承它并不完美。推理天花板是真实存在的,HLE 30.8意味着如果你扔给它一个真正困难的新颖问题,它会在前沿模型游刃有余的地方卡壳。所以他不会用它做架构决策或棘手的调试。
但那本就不是它的用途。它的战场是「大量不难、只是长」的智能体工作:读文件、运行命令、检查输出、操作UI、填表单、在50个步骤里不丢线索地跟着计划走。这才是真正的活儿,而这个模型非常擅长。
博主的最终建议很简单:想要最省事就用Ollama,想要图形界面和量化控制就用LM Studio,两种方式都把Hermes指向本地端点、配好上下文长度即可。「Qwen一直在做一件事——发布普通人真能跑起来的尺寸,而且总是好得超出它应有的水平。用27B参数和Apache 2.0许可证,在SWE-bench Pro、OS World、CoworkBench和IF-Bench上击败Opus 4.6 Max,这可不是小事。」
相关推荐
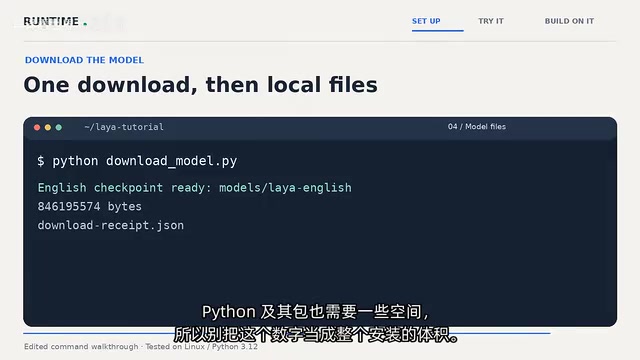
本地部署开源Laya实战:搭建环境并运行三个AI客服分类演示
开源项目 Laya 本地部署完整实战:从虚拟环境搭建、模型下载到三个客服文本分类演示,涵盖置信度阈值判断与接入本地大模型生成草稿回复,全程 CPU 运行无需 API 密钥。
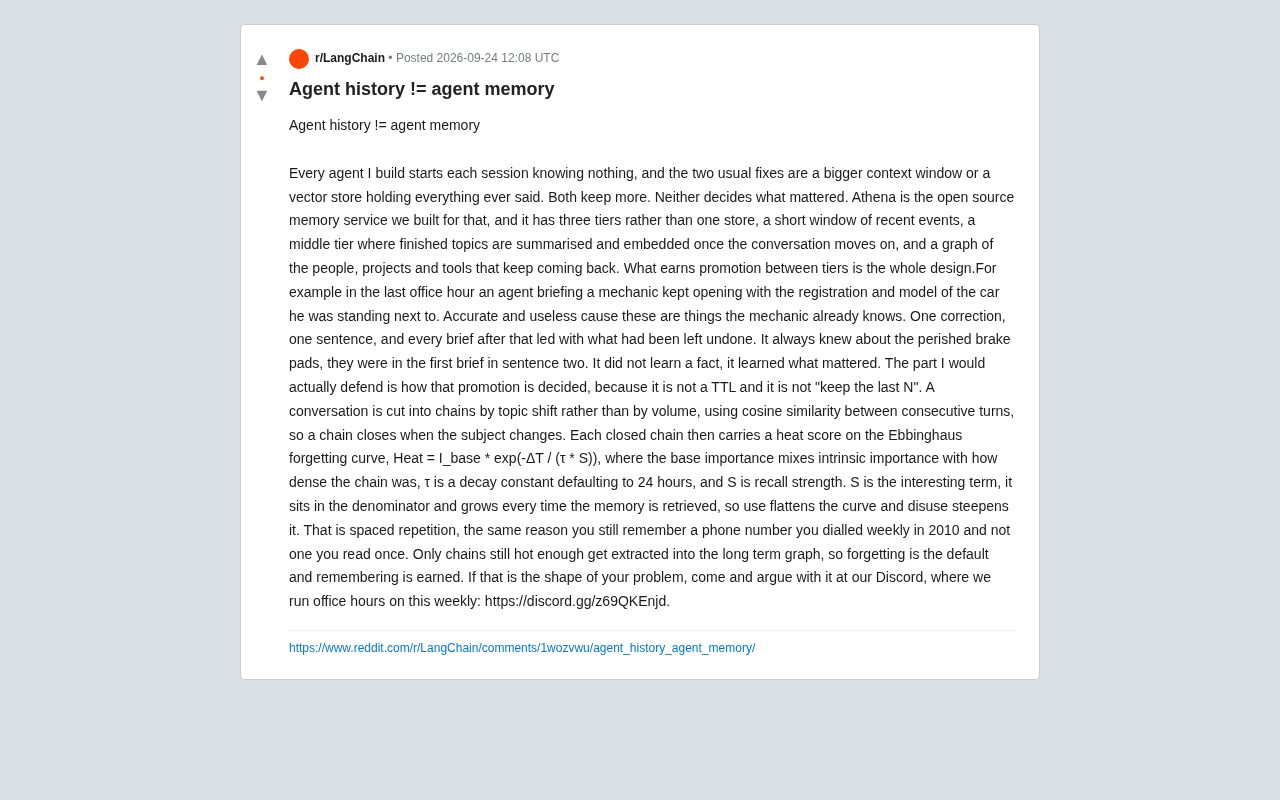
Athena:让AI智能体学会遗忘的三层记忆系统
Athena是一个开源AI智能体记忆服务,采用三层结构与艾宾浩斯遗忘曲线机制,让智能体主动决定记住什么、遗忘什么。本文解析其话题切链、热度评分与间隔重复原理。
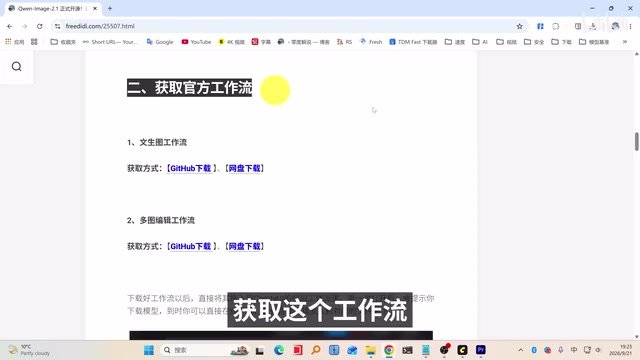
Qwen-Image-2.1 开源实测:7B参数媲美闭源图片模型
Qwen-Image-2.1 正式开源,视觉生成仅 7B 参数却媲美顶级闭源图片模型,支持多图参考编辑、透明图像生成与消费级显卡本地部署。本文实测其效果与 ComfyUI 部署全流程。