Qwen3.8B本地部署教程:零拒绝量化版+ComfyUI驱动MiniMax H3视频生成

用Qwen3.8B本地大模型扩写提示词,驱动MiniMax H3生成视频的零成本本地工作流方案。
本文介绍了一套完全本地运行的AI视频生成工作流:以Qwen3.8B作为提示词扩写引擎,结合MiniMax H3视频生成模型,在无需任何API费用的前提下实现从自然语言描述到视频输出的完整链路。Qwen3.8B凭借在600余个模型中综合排名第26的成绩,已进入27B参数以内模型的第一梯队,支持GGUF格式多档位量化,覆盖8G至16G显存的主流消费级显卡。部署路径通过LM Studio管理模型、ComfyUI节点包接入工作流,技术门槛较低。文章同时说明了社区"零拒绝"去审查量化版本的特性与适用场景,并给出了显存适配、参数调节等实用配置建议。
Qwen3.8B:27B参数体量中的第一梯队
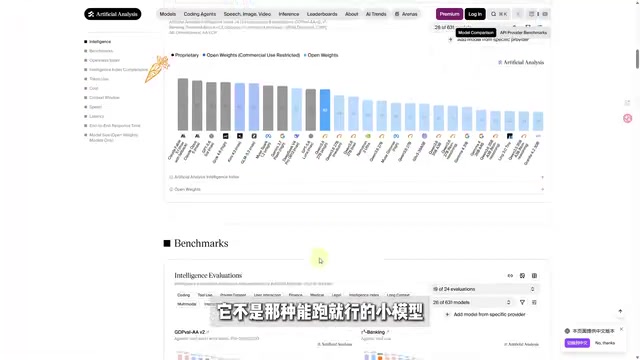
阿里发布的Qwen3.8B(通义千问广告3.8),单月下载量接近500万次,迅速成为开源社区的焦点。这不是一个"能跑就行"的轻量模型——根据第三方评测平台Artificial Analysis的数据,Qwen3.8B在复杂能力榜单中,于600多个参与排名的模型里位列第26名,排在它前面的几乎全是各家厂商的旗舰付费闭源模型。
这个成绩意味着什么?在27B参数这个体量里,Qwen3.8B已经属于真正意义上的第一梯队,而不仅仅是"开源里的佼佼者"。模型本身支持多模态输入(图像、视频理解)、长文本处理和复杂指令跟随,同时提供针对不同显存层级的量化版本,8G到16G显存的用户均可找到对应方案。
本地部署Qwen3.8B:通过LM Studio一步到位
选择合适的GGUF量化版本
部署的第一步是根据自己设备的显存容量选择量化精度。社区中有专门面向16G显存用户优化的量化版本,在能力保留相对完整的前提下,显存占用和推理速度都有明显改善。8G、12G显存用户也有对应的更低比特量化可选。模型以GGUF格式分发,兼容主流的本地推理工具链。
导入LM Studio的关键步骤
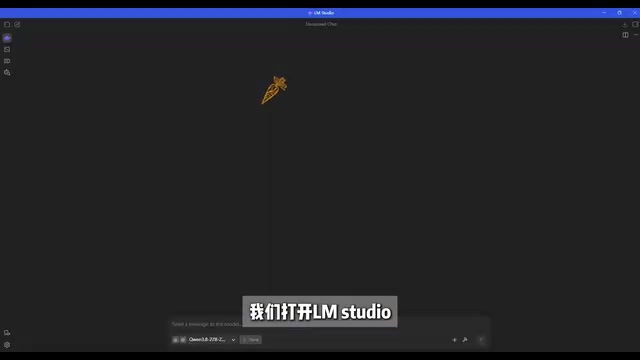
下载好GGUF模型文件后,打开LM Studio,点击左下角的"设置"进入通用设置页面,找到"模型目录"选项,将路径指向模型所在文件夹。这里有一个关键细节:模型文件必须放在一个子文件夹内(例如新建一个名为"Qwen"的文件夹),LM Studio才能正确识别并加载它。设置完成后重启LM Studio,Qwen3.8B就可以直接在本地运行。
一个实用的技巧是:将模型直接放入ComfyUI的模型文件夹路径中,这样LM Studio和ComfyUI可以共用同一份模型文件,节省硬盘空间。
接入ComfyUI:为MiniMax H3视频工作流提供提示词
ComfyUI节点包安装
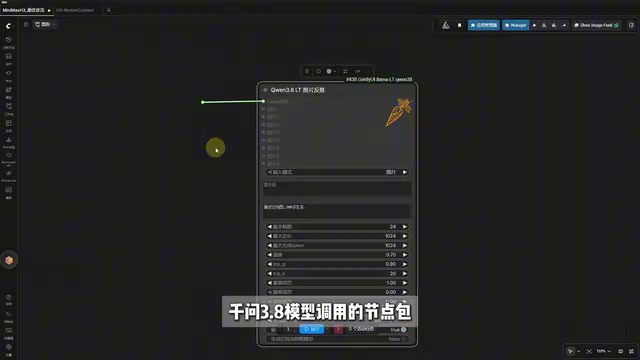
将Qwen3.8B接入ComfyUI工作流需要安装专用节点包,同时还需要安装llama-cpp-python(即LM-CPP)及对应的Python wheel包。这些依赖的安装步骤通常配有图文教程,按流程操作并不复杂。
节点包安装完成后,ComfyUI中会出现Qwen3.8B推理模块,可以直接在工作流中调用本地模型进行文本推理,无需任何API密钥或网络请求。
零拒绝量化版本的实际表现
这里需要单独说明"零拒绝(Zero Refusal)"量化版本的特性。官方版本的Qwen3.8B内置了内容过滤机制,对部分敏感问题会直接拒绝回答;而社区制作的去审查量化版本移除了这一限制,做到了字面意义上的"有问必答"。
从对比测试来看,相同的问题输入,官方版本直接拒绝,去审查版本则完整响应。这一差异对于需要生成创意内容、探索边缘场景的视频生成工作流来说具有实际意义——提示词扩写不再受到内容过滤的干扰。
风险提示:使用去审查模型需要用户自行评估风险与合规性,在受监管的场景或企业环境中应优先使用官方版本。
MiniMax H3视频生成工作流配置与运行
工作流核心参数设置
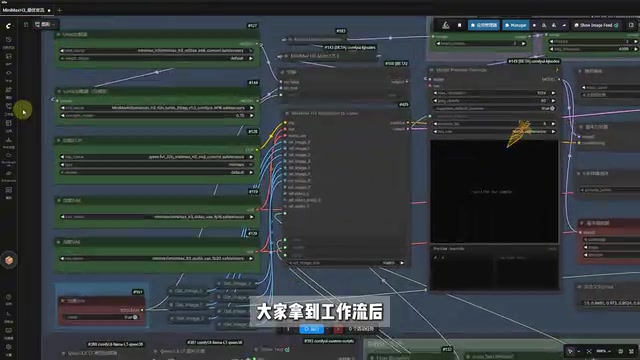
拿到工作流文件后,配置流程较为直观:
- 模型选择:在模型加载器节点中选择已导入的Qwen3.8B量化版本
- 显存适配:工作流内置了针对8G和12G显存的专属节点配置,按实际显存选择对应分支
- 视频参数:设置输出视频的宽高比和时长(秒数)
- 参考图上传:可选上传参考图片以引导视频风格
- 推理强度:模型加载器中提供推理强度滑块,数值越高生成质量越好,速度相应降低
系统提示词已在工作流中预设好,通常无需修改,用户只需在Qwen3.8B推理模块的输入框中描述视频的大致内容即可。
从文字描述到视频输出的运行逻辑
整个链路的逻辑是:用户输入的简短文字描述 → Qwen3.8B本地扩写为详细的MiniMax H3视频提示词 → H3模型根据提示词生成视频。Qwen3.8B在这里扮演的是"提示词工程师"的角色,将模糊的创意意图转化为视频模型能高效利用的结构化描述。
这种架构的核心优势在于完全本地运行、无API成本、无内容过滤干扰,且提示词质量相比人工手写有明显提升。
方案整体评估与选型建议
Qwen3.8B的本地部署方案在技术门槛和实际可用性之间取得了较好的平衡。LM Studio降低了模型管理的操作复杂度,ComfyUI节点化的工作流让视频生成流程可视化且易于调试。
在量化版本的选择上,显存有限的用户不必强求高精度量化,社区针对16G及以下显存优化的版本在日常使用中表现已经足够稳定。与其追求最高量化精度,不如根据实际硬件条件选择推理速度与质量之间更合适的平衡点。
对于想在本地构建完整AI视频生成工作流的用户,"Qwen3.8B提示词扩写 + MiniMax H3生成"这套组合是一个成本低、可控性强的可行方案。
相关推荐

神经网络本质是线性回归?华为300集AI课讲师用TensorFlow Playground讲透深度学习
华为300集AI深度学习教程中,讲师用TensorFlow Playground演示神经网络本质是线性回归,讲透机器学习与深度学习在特征工程上的核心差异,以及2012年大数据时代为何成为深度学习崛起的分水岭。

WorkBuddy做AI漫剧全流程:8步从零到成片
基于B站教程梳理WorkBuddy制作AI漫剧的完整八步流程:从选题策划、剧本分镜到图片资产、视频生成、配音剪辑与导出发布,并解析WorkBuddy的专家技能机制与逐个召唤专家的实操技巧,适合零基础入门。

Codex实战教程:从安装到多智能体协同
基于B站Codex实战教程,系统梳理Codex从安装配置、CLI交互、斜杠指令、AGENTS.md架构到MCP协议、多智能体协同与企业级插件开发的完整路径,帮助开发者理解AI Agent的工程化用法。