Qwen3 Max最新版实测:分数升了,为何有的能力反降?
Qwen3 Max新检查点0902凭借3D手表题首个满分逆势涨分,但前端交互能力局部退步。
阿里巴巴 Qwen3 Max 的最新检查点 0902 在博主 KingBench 3 测试中拿下 86.25%,登上榜单第三名,整体较上一版本提升 5 个百分点。然而这一涨幅几乎完全来自单道题目:极难的 3D 腕表题从 3 分跃升至全模型历史首个满分 10 分,3D 与几何能力显著增强。与此同时,电梯模拟、隐形眼镜盒和弓箭游戏等前端交互题均出现退步,物理手感和动画打磨不及旧版。横向对比中,Gemini 3.8 Flash 以 81.25% 展现出超越定位的实力,而 Muse Spark 1.3 则退步至 71.25%。Qwen3 Max 拥有 2.4 万亿参数、100 万上下文窗口,且官方确认将开放权重,是同级别中极为罕见的开放旗舰,正式版发布值得持续关注。
阿里巴巴旗舰模型 Qwen3 Max 又推出了新的检查点(checkpoint)——代号 0902。一位海外博主对这个版本进行了第三次实测,结果出人意料:整体跑分不降反升,但拆开来看,多项前端交互能力其实是退步的。这场看似矛盾的测试,恰好揭示了「滚动式预览」模型迭代的真实面貌。
背景:一个即将开源的2.4万亿参数旗舰
Qwen3 Max 是阿里的旗舰模型,参数规模高达 2.4 万亿,上下文窗口达到 100 万 token,并且官方已确认它将走开放权重(open-weight)路线。这在同级别的闭源旗舰中相当罕见。
博主此前已经测过两个版本。最早的预览版在他的 KingBench 3 测试中拿下 65/80(81.25%),位列榜单第二。随后官方推送了一次预览期更新,前端表现、工具调用和 Cloud Code 环境行为都有明显改善。这次的 0902 是同一条滚动改进路线上的下一步。
Qwen 团队对这种迭代方式相当坦诚——他们表示模型在预览期几乎每天都在演进,并希望用户持续测试反馈。于是博主又跑了一遍完整基准。
开放权重(open-weight)与完全开源(open-source)有重要区别:开放权重意味着模型参数文件可供下载和本地部署,但训练代码、数据集或商业使用条款可能仍有限制。即便如此,在 2.4 万亿参数这一量级上开放权重仍属罕见——目前公开的超大规模 MoE 模型中,Meta 的 Llama 系列最大止步于数千亿参数量级,而 DeepSeek V3/R1 虽已开放权重,也"仅"在 6710 亿参数级别。Qwen3 Max 若如期发布权重,将成为可本地或云端自部署的最大量级开放模型之一,对需要数据不出境或高度定制化的企业用户意义重大。
「滚动式预览(rolling preview)」是指模型在正式版本发布前,以频繁推送检查点(checkpoint)的方式持续迭代,每个检查点代表训练或后处理流程中的一个快照。这种方式允许团队快速收集真实用户反馈,但也意味着相邻版本之间的能力可能出现不一致的波动,而非单调递进。
KingBench 3 逐题拆解:有升有降
KingBench 3 由八道题目组成,覆盖前端与动画生成能力。这次测试的结果呈现出明显的分化。
退步的几道题
第一题是电梯模拟:三部电梯、不同楼层生成乘客、悬停显示目标楼层的提示框。0902 拿到 7/10,模拟能跑、排队逻辑基本正确,但几处交接场景出错,动画也比之前僵硬。旧版本这题是 8 分——退了一分。
第二题是隐形眼镜盒(带 L/R 标记的可点击开合结构),同样 7/10。盒子建模没问题,L/R 盖子能打开,但标记不够醒目,开合动画有跳帧。旧版本这题拿过 8 分,且曾是该题历史第二高分——又退一分。
最扎心的是第五题——弓箭射击小游戏。游戏能跑、四个靶子和排行榜都正常,但瞄准手感比之前「飘」,箭矢弧线也有偏差,只拿到 8/10。而旧版本这题是满分 10 分,2 分的跌幅是整轮测试中最大的一次回退。
进步与持平的题目
第四题的熊猫吃汉堡 SVG 从 8 分提升到 9 分,比例协调、汉堡辨识度高,是博主给该题打过的最高分之一。第三题的 3D 折叠桌维持 8 分,第六题的排列组合数学题(答案 2460)和第七题的完整 Agent 任务(生成熊猫数据集、本地微调 Gemma 2B、部署每次刷新给出熊猫冷知识的 Web UI)都拿满分 10 分。
KingBench 3 是该博主自行设计的评测套件,专注于考察大模型在前端 UI 生成、动画逻辑、交互物理和复杂编程任务上的综合能力,满分 80 分(8 道题各 10 分)。与 MMLU、HumanEval 等学术基准侧重于问答或函数级代码生成不同,KingBench 3 更接近真实的「vibe coding」场景——即通过自然语言一次性生成可运行的完整应用。正因如此,它对模型的空间推理、动画时序控制和多组件协调能力要求极高,也解释了为何 3D 手表这类任务能区分出模型之间的巨大差距。
一块手表贡献了全部涨幅
真正让这轮测试封神的是第八题——3D 手表。
这是整个基准里最难的一题:要求做出真正可用的 3D 腕表,秒针、分针、时针平滑运转并绑定真实当前时间,还要有日期/星期显示和双时区追踪。大多数模型在这题上只能拿 0 分或个位数低分。旧版 Qwen3 Max 只有 3 分,此前的历史最高纪录是 Muse Spark 1.3 拿下的 8 分。
0902 这次拿到了满分 10 分——这是任何模型在该题上的首个满分。手表外观逼真,指针平滑且绑定真实时间,日期和星期齐全,第二时区真正可用而非摆设。从 3 分直接跳到 10 分。
这就构成了整轮测试的奇异之处:0902 在三道题上失分、只在一道题上加分,却因为这块手表整体反涨了 4 分。去掉手表,这个版本其实比上一版更差;算上手表,它又是该模型有史以来最大的一次跃升。
3D 腕表题之所以难,在于它同时考验多个维度:WebGL/Three.js 或纯 CSS 3D 的场景构建、基于 Date API 的实时时间绑定、指针角度的三角函数换算、双时区偏移逻辑,以及流畅动画的帧率控制。任何一个环节出错——比如分针每分钟跳动一次而非平滑旋转,或秒针角度计算偏差——都会直接影响可用性评分。大多数模型会生成「看起来像手表」的静态外壳,却无法做到指针真正跟随系统时钟运转,这也是历史最高分长期停在 8 分、大量模型得 0 分的根本原因。
横向对比:三款近期模型谁更强
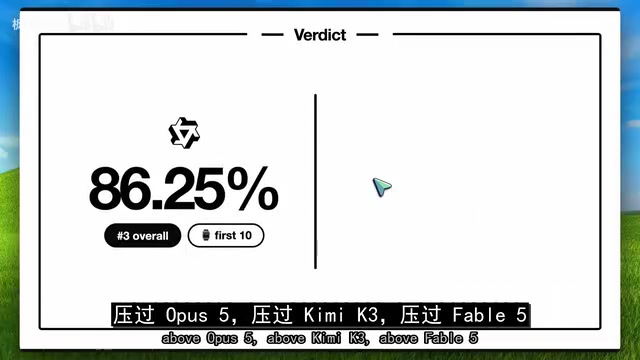
0902 最终拿下 69/80(86.25%),登上博主总榜单第三名,仅次于 Fable 5.1(92.5%)和 GLM 5.3(91.25%),领先自己上一版本整整 5 个百分点。
博主同期还测了另外两款模型,形成有趣对照:
- Gemini 3.8 Flash:65/80(81.25%)。作为 Flash 级别模型表现惊艳(要知道 Gemini 3.5 Flash 只有 30%),但正面对决只在隐形眼镜盒和弓箭游戏两题上胜出。差距最明显的是折叠桌(Flash 5 分 vs Qwen 8 分)和手表(Flash 6 分 vs Qwen 10 分)。
- Muse Spark 1.3:57/80(71.25%),反而比 1.2 版本的 76.25% 退步了。它唯一能撑住的就是手表题的 8 分——而这个纪录只保持了大约四天,就被 Qwen 打破。
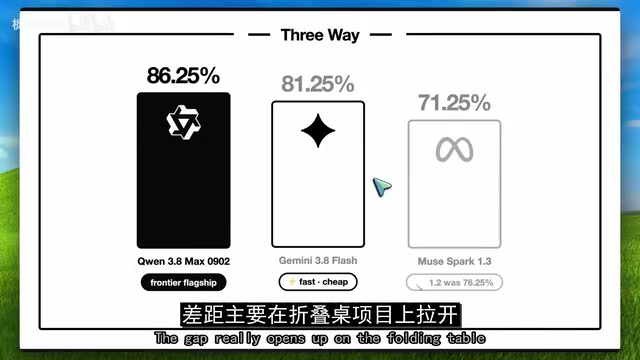
三者定位其实完全不同:一个是前沿旗舰,一个是快速廉价的 Flash 模型,一个是走了下坡路的小版本更新。
Gemini 3.8 Flash 属于 Google 「Flash」系列——该系列定位为低延迟、低成本的推理模型,参数量和计算开销显著小于旗舰「Pro/Ultra」版本,通常以极高的性价比换取部分能力上限的让步。此次 Flash 级别在 KingBench 3 拿下 81.25%,接近甚至超越许多旗舰模型的历史成绩,说明 Google 在新一代小模型的前端代码生成能力上投入了明显的优化资源。Muse Spark 1.3 的退步则代表了另一种常见现象:小版本更新(minor update)有时为了改善某类任务而无意中损害其他能力,即所谓的「能力跷跷板」效应,在缺乏系统性回归测试的情况下尤为突出。
实际使用体验:跑分之外的真实感受
跑分从来讲不完整个故事。博主谈了几点实际使用感受:
Harness 行为依然稳定。第一版视频中吐槽的长会话「卡壳」、在 Cloud Code 中漏建文件的问题,从上一版修复后一直保持修复状态。这点很关键——滚动式检查点往往会悄悄弄坏原本能用的功能。
3D 与几何能力明显增强。不只是手表。现在交给它 Three.js 任务,首次就能正确搭好场景的概率大幅提高,博主花在「纠正物体悬空、穿模」上的时间明显减少。
前端交互手感略有软化。电梯和弓箭两题的失分正说明了这点——物理手感和交互打磨略有回退。日常工作中大概察觉不到,但在基准上确实两次显现。
博主的判断是:这就是滚动预览的常态。团队显然在调整某些参数,不同检查点擅长不同方向。做 3D 和重度几何工作,0902 是大升级;如果工作流全是游戏手感和交互物理,上一版反而略好。
获取方式与总体评价
0902 目前在 token 套餐和 Coder 相关服务中可用,token 套餐用户已可免费使用,也能在 Studio 上免费试用。不过 Code 端的免费层今年早些时候已被完全取消。
博主的最终结论:Qwen3 Max 0902 是该模型目前最好的版本——86.25% 总榜第三,且拿下了那道折磨了众多模型数月的手表题的首个满分。它不是完胜(几道交互题确实退步,希望后续找回手感),但净结果明显向上,已是除 Fable 5.1 和 GLM 5.3 外基准上最强的模型。
三款模型的使用建议:重活交给 Qwen3 Max 0902;想要快就用 Gemini 3.8 Flash;Muse Spark 1.3 暂时跳过、留在 1.2。
一个 2.4 万亿参数、榜单第三、超过 Opus 5、Kimi K3 和 Fable 5 的模型,最终还要走开源——这确实不是一件小事。等官方正式版和权重放出后,它是否有机会冲击榜首的 GLM 5.3 和 Fable 5.1,值得持续关注。
相关推荐
Jev前沿模型问世:成本降40-400倍,速度提升20-200倍
新前沿模型Jev宣称成本降低40-400倍、速度提升20-200倍,引发Hacker News热议。本文解析其性价比卖点、效率突破的可能路径,以及如何理性看待这组惊人数字。

同款模型三大AI Agent横评:DeepSeek Harness、ZCode与Hermes谁更强
同一个GLM Flash模型、相同提示词,分别放进DeepSeek Harness、ZCode和Hermes三大AI Agent中横评对比。实测显示Agent框架差异显著,速度、代码量与最终效果各有高低,DeepSeek Harness综合表现最佳。

DeepSeek扒谱时喊"困了"?聊聊LLM思维链里的拟人化现象
B站UP主发现DeepSeek在扒谱、BPM识别任务的思维链中出现"困了""想睡觉"等拟人化表达。本文解析LLM为何会模仿疲劳、思维链如何放大拟人化现象,以及如何应对模型输出跑偏。