Qwen3去审查模型批量发布:MTP保留与GGUF全格式支持

一次性发布多款去审查模型
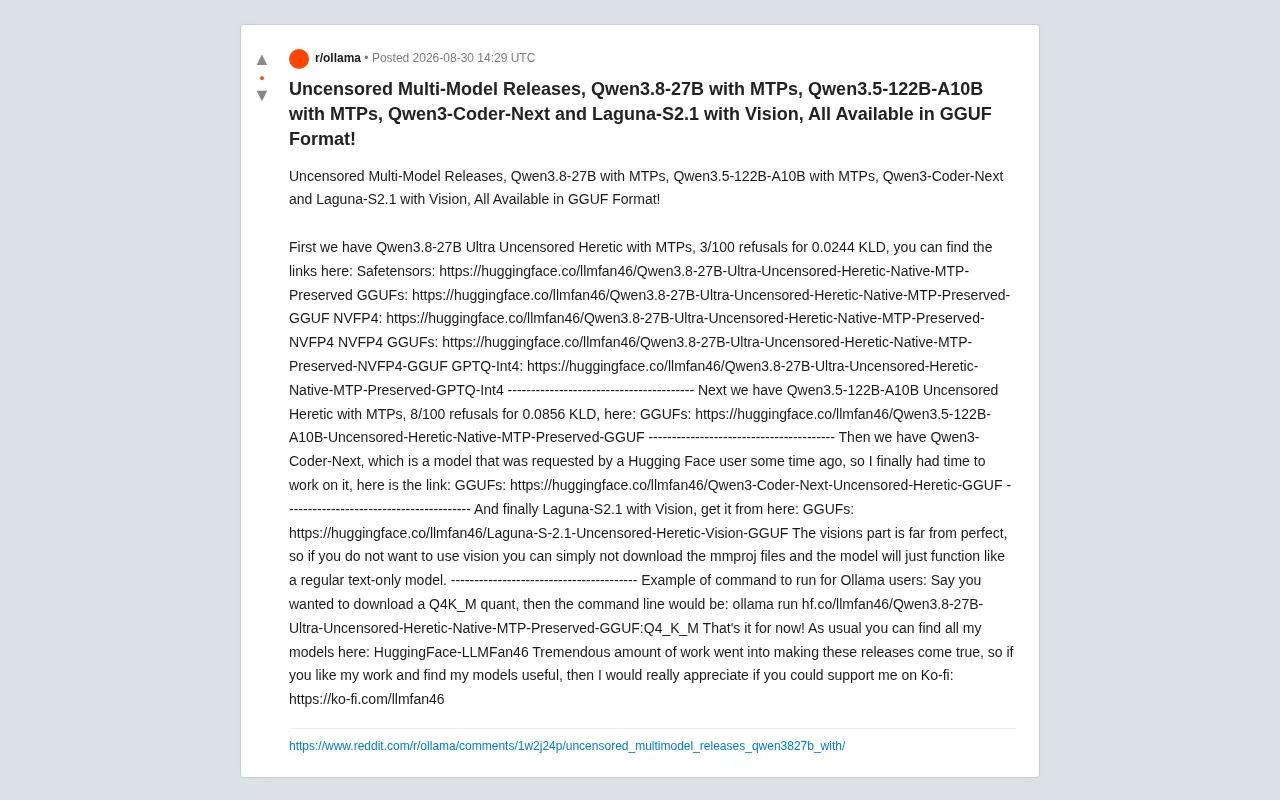
近日,Hugging Face 社区开发者 llmfan46 一口气发布了多款基于 Qwen3 系列的去审查(Uncensored)微调模型,涵盖从中等规模到超大参数量的多个版本,并且全部提供 GGUF 格式支持,方便本地部署使用。这一批发布包括 Qwen3.8-27B、Qwen3.5-122B-A10B、Qwen3-Coder-Next 以及带视觉能力的 Laguna-S2.1,覆盖了文本推理、代码生成和多模态等多个应用场景。
所谓"去审查"模型,是指通过微调手段移除或弱化大语言模型在训练阶段被注入的安全对齐(Safety Alignment)限制的模型版本。主流大模型在发布前通常会经过 RLHF(基于人类反馈的强化学习)或 DPO(直接偏好优化)等对齐训练,使模型拒绝回答涉及暴力、非法活动、敏感话题等内容的请求。具体而言,RLHF 通过训练一个奖励模型来评估模型输出的"有益性"和"无害性",再使用 PPO(Proximal Policy Optimization)等策略梯度算法优化语言模型的策略,使其倾向于生成高奖励的回复。DPO 则简化了这一流程,直接使用人类偏好数据对(preferred vs. rejected)来优化模型策略,无需显式训练奖励模型,在实践中因训练稳定性更好而被广泛采用。这两种方法都会在模型权重中深度嵌入拒答行为模式,使得安全限制不仅仅是表面的指令遵循,而是渗透到模型的概率分布之中。去审查微调的核心挑战在于如何精准地移除这些拒答行为,同时不损害模型的通用推理能力和知识储备。从技术路线上看,去审查方法大致可分为三类:基于指令数据的重训(使用无拒答行为的对话数据覆盖原有对齐)、基于参数高效微调的调整(如 LoRA 仅修改少量参数)、以及更前沿的权重空间直接编辑(靶向修改与拒答行为相关的特定参数)。不同路线在效果精度与能力保持之间存在显著的权衡差异。
对于本地大模型爱好者和开发者而言,这类去审查模型的价值在于提供了更少限制的实验环境。开发者在发布说明中特别强调,这批模型保留了原生 MTP(Multi-Token Prediction,多 Token 预测)能力,这在去审查微调过程中是一个技术难点——许多微调过程会破坏原有的架构特性。MTP 是一种推理加速技术,传统自回归语言模型每次前向传播只预测下一个 token,而 MTP 架构允许模型在单次前向传播中同时预测多个后续 token。这种设计通过额外的预测头实现并行输出,在推理阶段可以配合投机解码(Speculative Decoding)策略显著提升生成速度。投机解码的核心思想是一种"草稿-验证"(draft-verify)范式:先由一个轻量级模型(或在 MTP 场景下由额外的预测头)快速生成多个候选 token 作为"草稿",然后由主模型在单次前向传播中并行验证这些候选 token 的正确性。由于验证多个 token 的计算成本与生成单个 token 相近(主要受限于显存带宽而非计算量),因此当草稿的接受率足够高时,整体生成速度可以获得数倍提升。MTP 预测头的存在使得模型本身就具备了高质量的草稿生成能力,无需额外部署独立的草稿模型,在工程上更加优雅。在微调过程中,如果训练流程未正确处理这些额外的预测头参数——例如训练框架未将 MTP 头纳入计算图、或优化器状态未正确初始化——MTP 模块的权重就会被破坏或重置,导致加速能力丧失,因此保留 MTP 需要对训练配置进行精细调整,包括确保损失函数覆盖所有预测头、学习率策略适配不同模块等细节。
核心模型解析:Qwen3.8-27B 与 Qwen3.5-122B
Qwen3.8-27B Ultra Uncensored Heretic
作为本次发布的旗舰之一,Qwen3.8-27B Ultra Uncensored Heretic 版本采用了 "Heretic" 去审查方法,并保留了原生 MTP 能力。Heretic 是开源社区中一种相对新颖的去审查方法论,其核心思路区别于传统的大规模指令数据集重训。传统去审查方法通常需要使用大量无拒答行为的对话数据进行全量或 LoRA 微调,这一过程往往伴随着模型通用能力的退化(即所谓的灾难性遗忘)。Heretic 方法据称采用了更精细的干预策略,可能涉及对模型中与拒答行为相关的特定神经元或注意力模式进行靶向修改,从而在最小化对模型整体权重空间扰动的前提下解除安全限制。
这种靶向修改的思路与近年来学术界兴起的模型编辑(Model Editing)技术一脉相承。代表性工作包括 ROME(Rank-One Model Editing)和 MEMIT(Mass-Editing Memory In a Transformer),它们通过定位 Transformer 中存储特定知识的关键层(通常是中间层的 FFN 模块),然后以秩一更新或批量更新的方式精确修改目标知识,同时尽量不影响其他知识。另一个相关方向是激活引导(Activation Steering / Representation Engineering),通过在模型的激活空间中识别与特定行为(如拒答)相关的方向向量,然后在推理时减去该方向的分量来抑制目标行为。Heretic 方法虽然具体实现细节尚未完全公开,但从其极低的 KLD 表现来看,很可能融合了这些精准干预技术的核心理念,代表了去审查技术从"大范围重训"向"手术刀式编辑"演进的最新实践。
根据开发者提供的数据,该模型在 100 次测试中仅出现 3 次拒答(3/100 refusals),同时 KLD(KL 散度)仅为 0.0244。
KL 散度(Kullback-Leibler Divergence)是信息论中衡量两个概率分布差异程度的经典指标,其数学定义为 D_KL(P||Q) = Σ P(x) log(P(x)/Q(x)),其中 P 通常代表参考分布(原始模型),Q 代表近似分布(微调模型)。在大模型微调评估语境下,KLD 用于比较微调后模型与原始模型在相同输入下的输出概率分布差异。KLD 为零意味着两个分布完全相同,数值越大表示偏离越严重。对于去审查微调而言,理想状态是仅改变模型对敏感请求的拒答行为,而不影响其在通用任务上的表现——这正是低 KLD 所反映的。0.0244 的 KLD 意味着微调几乎没有改变模型的整体行为分布,仅在目标行为(去除拒答)上做了精准调整,这在微调技术中被称为"外科手术式"修改,是高质量微调的重要标志。作为对比参考,使用传统全量微调进行去审查的模型 KLD 通常在 0.1 到 0.5 甚至更高的范围,而基于 LoRA 的方法一般在 0.05-0.15 之间。从本次发布的极低 KLD 数据来看,Heretic 方法在保持模型原有分布方面确实表现出色,体现了去审查技术从粗放式重训向精准式调整演进的趋势。
该模型提供了极为丰富的格式选择,包括 Safetensors 原始权重、GGUF、NVFP4、NVFP4 的 GGUF 变体,以及 GPTQ-Int4 量化版本,几乎覆盖了从高精度推理到低显存部署的全部需求。
Qwen3.5-122B-A10B:大参数 MoE 架构去审查版
Qwen3.5-122B-A10B 是本批发布中参数量最大的模型。从命名可以看出,这是一个总参数量约 122B、激活参数约 10B 的 MoE(混合专家)架构模型。
MoE(Mixture of Experts)是一种通过条件计算实现高效扩展的神经网络架构。在 MoE Transformer 中,传统的前馈网络(FFN)层被替换为多个并行的"专家"网络,每个专家是一个独立的 FFN 模块。一个可训练的路由器(Router/Gate)网络负责为每个输入 token 动态选择最相关的少数几个专家进行计算(通常为 Top-K 选择),其余专家不参与当前 token 的处理。路由器训练中的一个关键挑战是负载均衡(Load Balancing)问题:如果没有适当的约束,路由器可能会陷入退化模式,将绝大多数 token 都路由到少数几个"热门"专家上,导致其他专家得不到充分训练而成为"死"专家。为解决这一问题,MoE 模型通常会在训练损失中加入辅助平衡损失(Auxiliary Load Balancing Loss),通过惩罚专家间负载不均来鼓励路由器更均匀地分配 token。这一机制对 MoE 模型的最终性能有着至关重要的影响。
以 Qwen3.5-122B-A10B 为例,其总参数量达 1220 亿,但每次推理仅激活约 100 亿参数,这使得它在拥有远超同等激活参数密集模型的知识容量的同时,推理速度和显存需求与一个 10B 级别的模型相当(不过需注意,虽然计算量与 10B 模型相近,但完整模型权重仍需加载到显存中,因此实际显存占用远大于 10B 密集模型)。Google 的 Switch Transformer 和 Mixtral 是 MoE 架构在大语言模型领域的早期代表作,如今 DeepSeek-V3、Qwen3 系列等最新模型都大规模采用了这一架构,使其成为训练超大规模模型的主流选择。这种设计让模型在拥有庞大知识容量的同时,推理时的实际计算量仍然可控。
该模型同样保留了 MTP 能力,去审查测试数据为 100 次中出现 8 次拒答(8/100),KLD 为 0.0856。相比 27B 版本,其 KLD 略高,拒答率也稍高,这在更大规模模型的去审查处理中属于合理范围——参数量越大,安全对齐行为分布在权重空间中的分散程度越高,精准移除的难度也相应增加。特别是对于 MoE 架构,拒答行为可能分散在不同专家的参数中,且路由器的条件选择机制进一步增加了行为定位的复杂性,因为同一类敏感请求在不同上下文下可能激活不同的专家组合。目前该版本仅提供 GGUF 格式。
代码与多模态去审查模型
Qwen3-Coder-Next 去审查版
Qwen3-Coder-Next 是应 Hugging Face 社区用户请求而制作的代码专用去审查模型。Qwen 系列的 Coder 模型本身在开源代码生成领域一直有不错的口碑,这个去审查版本为需要更自由代码生成环境的开发者提供了新选择。在代码生成场景中,安全对齐限制有时会过度拒绝合法的安全研究、渗透测试脚本或系统级编程请求,去审查版本在这些场景下可以减少不必要的阻断。例如,安全研究人员在进行漏洞分析时可能需要模型生成 exploit 概念验证代码,系统管理员可能需要生成网络扫描或权限提升脚本,这些在安全对齐模型中往往触发拒答,但在合法的红队测试和安全审计场景中却是必要的工具。代码模型的去审查还有一个特殊考量:代码领域的安全边界比通用对话更加模糊,一段代码是"安全工具"还是"攻击工具"往往取决于使用者的意图和使用场景,而非代码本身。该模型目前提供 GGUF 格式。
Laguna-S2.1 视觉模型
最后是带视觉能力的 Laguna-S2.1 模型。开发者坦诚地指出,其视觉部分"远非完美"(far from perfect),并给出了实用建议:如果不需要视觉功能,用户可以选择不下载 mmproj 文件,模型将作为纯文本模型正常运行。这里的 mmproj 文件是多模态投影器(Multimodal Projector)的权重文件,负责将视觉编码器提取的图像特征映射到语言模型的嵌入空间中,是连接视觉理解与文本生成的桥梁组件。从架构上看,多模态大模型(VLM)通常由三部分组成:视觉编码器(如 CLIP-ViT 或 SigLIP)负责将图像转换为视觉特征向量,投影器(通常是一个 MLP 或 Cross-Attention 模块)负责将视觉特征空间对齐到语言模型的文本嵌入空间,以及语言模型本身负责基于融合后的多模态表示进行推理和生成。LLaVA 系列工作证明了这种"视觉编码器 + 投影器 + 语言模型"的简洁架构在多模态理解任务上的有效性。
这种诚实的态度值得肯定,也提醒用户在多模态能力上要有合理预期。视觉理解的微调难度本身较高,需要同时处理视觉编码器、投影层和语言模型之间的复杂交互,特别是在去审查微调过程中,对语言模型部分的权重修改可能会破坏投影器已经学习到的跨模态对齐关系,导致视觉理解能力退化。社区开发者能提供一个可选的视觉模块已属不易。
本地部署方式与量化版本选择建议
所有模型均提供 GGUF 格式,这意味着可以直接在 Ollama、llama.cpp 等主流本地推理框架中运行。GGUF(GPT-Generated Unified Format)是由 llama.cpp 项目创建的模型存储格式,专为本地 CPU/GPU 混合推理设计,将模型权重、分词器配置和元数据统一打包在单个文件中,并原生支持多种量化精度。与之前的 GGML 格式相比,GGUF 采用了键值对元数据系统,使得格式具有更好的向前兼容性和可扩展性,第三方工具可以在不了解完整模型架构的情况下读取关键配置信息。这一格式的普及极大降低了本地部署大模型的技术门槛,已成为开源社区分发量化模型的事实标准。
开发者给出了 Ollama 的示例命令,例如下载 Q4_K_M 量化版本:
ollama run hf.co/llmfan46/Qwen3.8-27B-Ultra-Uncensored-Heretic-Native-MTP-Preserved-GGUF:Q4_K_M
对于普通用户而言,Q4_K_M 是显存占用与质量之间较好的平衡点。Q4_K_M 采用 llama.cpp 的 k-quants 分组量化策略,会根据不同层的重要性自适应使用不同的量化精度——具体而言,注意力层的 Q、K 投影和模型的第一层/最后几层通常使用更高精度(如 6-bit),而中间层的 FFN 权重则使用标准 4-bit 量化。这种分层策略基于一个经验观察:不同层对量化误差的敏感度差异很大,对关键层保留更高精度可以在几乎不增加总体模型大小的情况下显著改善输出质量。命名中的 "K" 代表 k-quants,"M" 代表 Medium(中等质量),同系列还有 K_S(Small,更小但质量稍低)和 K_L(Large,更大但质量更高)的变体。
如果显存有限,可以考虑 NVFP4 或 GPTQ-Int4 等更激进的量化版本——NVFP4 是 NVIDIA 针对其新一代 GPU 架构(如 Blackwell)推出的 4-bit 浮点量化格式,利用硬件级别的 FP4 张量核心支持实现更高推理吞吐量,其浮点表示相比整数量化在处理异常值(outlier)权重时具有天然优势;GPTQ-Int4 则是基于二阶信息(Hessian 矩阵的近似)的训练后量化方法,通过逐层求解最小化量化误差的优化问题来确定最优的量化参数,被 vLLM、TGI 等服务框架广泛支持。值得一提的是,除了 GPTQ 之外,AWQ(Activation-aware Weight Quantization)也是一种流行的替代方案,它基于激活分布来识别权重中的"显著通道"并给予保护性缩放,在某些模型上表现优于 GPTQ。用户在选择量化方案时,除了精度损失外,还应考虑目标推理框架的兼容性:GGUF 量化适合 llama.cpp/Ollama 生态,GPTQ 和 AWQ 更适合 vLLM/TGI 等 Python 推理服务框架。如果追求最高质量且硬件充足,则可以选择 Safetensors 原始权重进行 FP16/BF16 精度推理。
开源社区生态的持续繁荣
这批发布再次体现了开源大模型社区的活跃与创造力。从 Heretic 去审查方法到 MTP 能力保留,再到全格式量化支持,个人开发者已经能够独立完成过去需要团队才能实现的复杂工作。这种能力的提升得益于整个开源工具链的成熟——从 Hugging Face Transformers 库提供的标准化模型接口,到 PEFT/LoRA 等参数高效微调框架降低的训练门槛,再到 llama.cpp 生态提供的完善量化和部署工具链,每一环的进步都在为个体创作者赋能。特别值得注意的是,Unsloth、Axolotl 等新一代微调工具的出现进一步简化了微调流程,它们通过自动化的内存优化(如梯度检查点、Flash Attention 集成)和预配置的训练模板,使得在单张消费级 GPU 上微调数十亿参数的模型成为现实。
开发者表示这批模型的制作"投入了巨大的工作量",并希望用户能通过 Ko-fi 给予支持。这也反映出开源社区面临的现实:优质模型的产出需要大量投入(包括 GPU 算力成本、数据准备和测试验证的时间精力),而可持续的贡献往往依赖社区的正向激励。以本次发布为例,仅 122B 模型的量化转换就需要大量的 RAM(通常需要 256GB 以上的系统内存来加载完整权重进行量化处理),加上多种格式的转换和验证测试,单次发布的基础设施成本可能达到数百美元。
对于想要探索无限制大模型能力的开发者和研究者来说,这批模型提供了从 27B 到 122B、从纯文本到多模态、从代码到通用推理的完整选择。不过需要提醒的是,使用去审查模型时应遵守相关法律法规,并对生成内容负责。
相关推荐

AI数字员工系统实测:所谓免费背后的营销套路解析
针对B站流行的「AI超级员工系统」「AI数字员工」推广视频,本文拆解其视频剪辑智能体、DeepSeek脚本助手两大功能模块,揭示其大模型二次封装的技术本质与免费引流背后的营销套路及账号安全风险。

WorkBuddy入门指南:让AI真正替你上班的桌面智能体
WorkBuddy是一款能直接操作本地电脑的桌面AI智能体。本文详解其定位、与CodeX的差异、常见认知误区及文件管理、协同办公等实战能力,帮你从AI提问者进化为AI管理者。

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。