RADC:面向视觉语言模型测试时自适应的风险感知双缓存方法
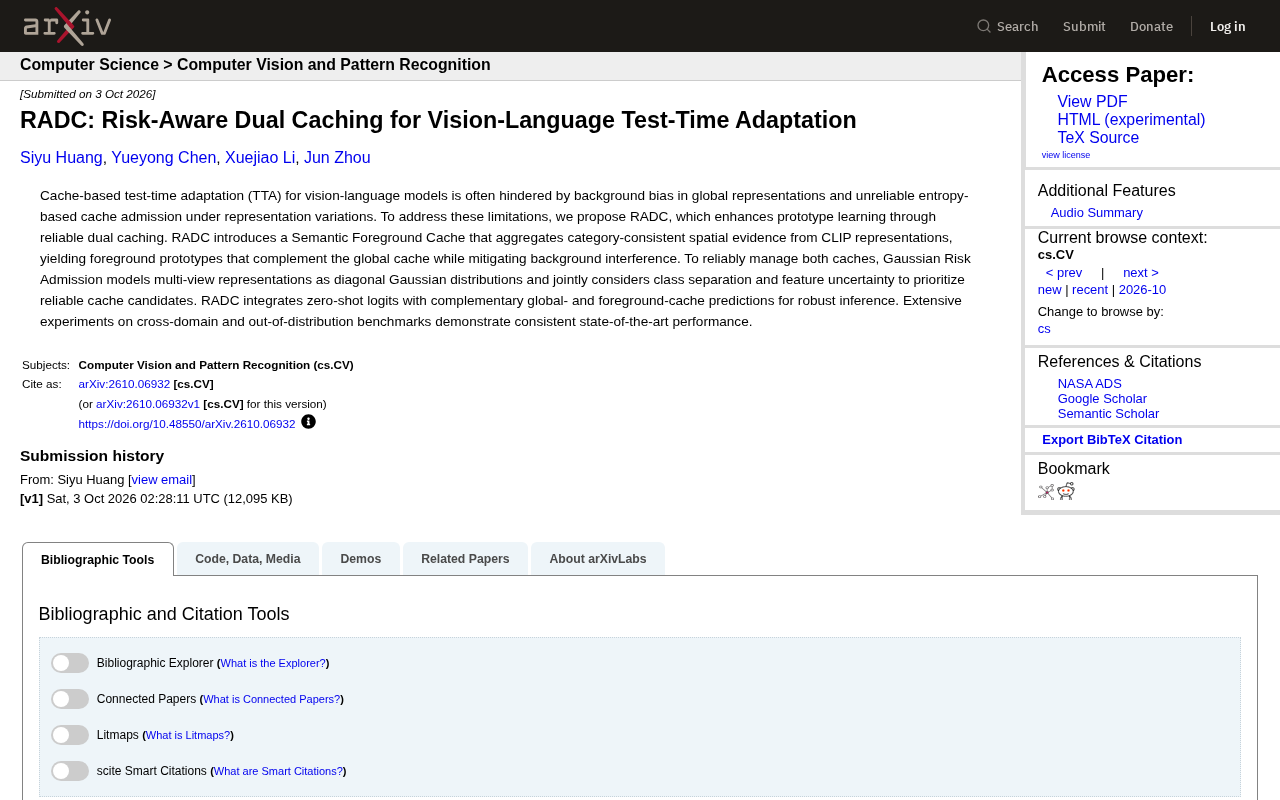
RADC通过语义前景缓存与高斯风险准入双机制,解决视觉语言模型测试时自适应中的背景偏差与熵准入失效问题。
RADC(Risk-Aware Dual Caching)是一个面向视觉语言模型(以CLIP为代表)测试时自适应的新框架,针对现有缓存式方法的两大痛点提出解决方案:背景偏差与基于熵的不可靠准入机制。其核心设计包含两个组件:语义前景缓存从CLIP的空间patch表示中聚合类别一致的区域证据,提炼出不受背景干扰的前景原型;高斯风险准入将多视角特征建模为对角高斯分布,联合考量类别可分性与特征不确定性,以风险驱动取代熵驱动的样本筛选。推理阶段融合零样本logits、全局缓存与前景缓存三路预测,在跨域与分布外基准上取得一致的最优性能,为缓存式TTA提供了清晰且可扩展的新范式。
问题背景:测试时自适应为何会失灵
视觉语言模型(如 CLIP)在实际部署中常常面临一个现实困境——训练数据分布与测试环境存在差异。为了在推理阶段动态适应新环境,研究者提出了测试时自适应(Test-Time Adaptation, TTA)技术,其中基于缓存(cache-based)的方法因无需反向传播、开销低而备受关注。
但这类方法存在两个长期被忽视的痛点。其一是背景偏差:CLIP 的全局表示往往会把图像中的背景信息一并编码进去,当目标物体与背景纠缠时,全局原型(prototype)就会被噪声污染,导致分类判断偏移。其二是不可靠的缓存准入机制:现有方法多依赖熵(entropy)来决定哪些样本进入缓存,但在表示发生漂移或变化时,熵值并不能可靠反映样本的真实质量,容易让低质量样本混入缓存,拖累后续预测。
这篇发表于 arXiv 的论文(arXiv:2610.06932)正是针对上述两个问题,提出了名为 RADC(Risk-Aware Dual Caching) 的新框架。
测试时自适应(TTA)的基于缓存的方法,其核心思路是在推理过程中动态维护一个「样本库」:将测试样本的特征表示及其预测标签存入缓存,再以检索近邻的方式辅助后续预测,整个过程无需更新模型权重。这与需要反向传播的梯度类 TTA 方法(如 TTT、TENT)形成鲜明对比,在计算资源受限的场景下更具实用性。CLIP 之所以成为这类研究的热门载体,是因为其文本-图像对齐的预训练方式赋予了它强大的零样本迁移能力,但也正因为其全局图像编码器不区分前景与背景,在领域偏移时尤为容易受背景噪声干扰——这正是 RADC 所要解决的根本动机。
RADC 的核心设计:双缓存 + 风险感知准入
RADC 的思路可以概括为「用更可靠的双缓存机制来增强原型学习」。它由两个关键组件构成,分别对应前文提到的两个痛点。
语义前景缓存:剥离背景干扰
第一个组件是语义前景缓存(Semantic Foreground Cache)。不同于直接使用 CLIP 的全局表示,RADC 从 CLIP 的空间表示中聚合「类别一致」的空间证据,提炼出前景原型(foreground prototype)。
这样做的好处在于,前景原型聚焦于真正与类别相关的区域,有效缓解了背景信息的干扰。它并非要取代原有的全局缓存,而是作为互补——全局缓存保留整体上下文,前景缓存则提供更纯净的目标语义。两者协同,形成对图像内容更完整也更稳健的刻画。
CLIP 的视觉编码器(通常基于 Vision Transformer)在输出全局 [CLS] token 之外,还保留了各空间位置的 patch token,这些 patch token 携带局部区域的语义信息。RADC 所说的「从空间表示中聚合类别一致的空间证据」,正是对这些 patch token 进行选择性加权:只保留与当前预测类别语义一致的 patch,忽略背景区域对应的 patch,再聚合成前景原型。这一思路与近年来在少样本学习和开放词汇检测中兴起的「局部特征对齐」方向一脉相承,本质上是把 CLIP 从「图像级匹配」推向更细粒度的「区域级匹配」,在无需额外标注或检测器的前提下实现了对目标区域的隐式聚焦。
高斯风险准入:用不确定性筛选可靠样本
第二个组件是高斯风险准入(Gaussian Risk Admission),用来管理两个缓存的样本准入。
传统熵阈值的局限在于它只看单点预测的分布锐度,而忽略了表示本身的波动。RADC 的做法是把多视角(multi-view)表示建模为对角高斯分布,从而同时考量两个维度:一是类别可分性(class separation),即样本能否清晰地归属于某一类;二是特征不确定性(feature uncertainty),即表示本身的稳定程度。通过联合评估这两点,系统能够优先选取真正可靠的缓存候选,而非被表面高置信度误导。
这种从「熵驱动」到「风险驱动」的转变,是 RADC 区别于以往缓存式 TTA 方法的关键所在。
将特征表示建模为高斯分布是贝叶斯深度学习中的经典做法。所谓「对角高斯分布」,是指用一个均值向量和一个对角协方差矩阵(即各维度独立的方差)来刻画特征的随机性,相比完整协方差矩阵大幅降低了参数量。RADC 的多视角设置通常指对同一图像施加不同的数据增强,得到多个特征向量,再拟合为高斯分布——均值反映特征的期望语义,方差则捕捉增强视角之间的不一致程度,即特征不确定性。类别可分性则可通过比较样本与各类别原型之间的马氏距离(Mahalanobis distance)或类间间隔来衡量。两者结合构成「风险」度量,比单一熵值更全面地反映了一个样本进入缓存的潜在收益与风险。
推理阶段:三路预测融合
在实际推理时,RADC 并不单靠某一路信号,而是把三种预测结果融合起来:
- Zero-shot logits:CLIP 原生的零样本预测,提供通用先验;
- 全局缓存预测:基于全局原型的判断,保留整体上下文;
- 前景缓存预测:基于前景原型的判断,突出目标语义。
三者互补融合,使得最终推理既有预训练知识的兜底,又能借助测试时积累的缓存信息进行动态修正。这种多路集成的设计在表示发生变化的场景下显得尤为稳健。
实验表现与意义
论文在**跨域(cross-domain)与分布外(out-of-distribution, OOD)**两类基准上进行了广泛实验,结果显示 RADC 取得了一致的 state-of-the-art 性能。这说明其双缓存与风险感知准入的组合设计,在应对真实世界中的分布偏移问题时具有普适的有效性。
从更宏观的角度看,RADC 代表了测试时自适应研究的一个值得关注的方向:与其在全局表示上「将就」,不如从空间证据中提炼更干净的语义原型;与其用启发式的熵阈值做准入,不如引入概率化的不确定性建模。这两点思路对于后续改进视觉语言模型的部署鲁棒性,都具有一定的借鉴价值。
需要说明的是,作为一篇预印本论文,RADC 的额外计算开销、对不同骨干网络的适配性,以及在更大规模或更极端分布偏移场景下的表现,仍有待社区进一步验证。但其提出的「风险感知双缓存」范式,无疑为缓存式 TTA 提供了一个清晰且可扩展的新框架。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。