RAG评估难题:多文档查询只召回一个,算命中吗?

多文档查询中any-hit与all-evidence判定相反,部署应以all-evidence为主并显式声明评估规则。
文章指出RAG评估中一个被忽视的盲区:当查询需要多份文档时,any-hit(命中任意一份即算命中)与all-evidence(需包含全部所需证据)会给出完全相反的判定,且不可互换。any-hit会导致指标虚高和方案对比失真。作者建议在对比检索方案前对齐四项规则:成功判定标准、备选文档处理、文档与chunk粒度及ID映射、缺失标注的处理。比平均分更有用的是输出受影响的查询清单,使分歧可复现。部署时应以all-evidence为主要指标,any-hit作为诊断工具,两者差距可指示覆盖度问题还是基础检索能力问题。
一个被忽视的评估盲区
假设用户的提问同时需要两份文档:一份是当前政策文件,另一份是独立的例外条款说明。检索器只返回了政策文件,漏掉了例外条款。
这时候,你的评估指标该怎么记?
按照「any expected document in top-k」(Top-K 中命中任意一份预期文档)的规则,这是一次命中。按照「all required evidence in top-k」(Top-K 中包含全部所需证据)的规则,这是一次不完整的结果。两个指标给出完全相反的结论,而且它们不可互换。
这是 Reddit 社区近期讨论的一个案例,虽然只是示意性场景而非生产数据,但它精准戳中了 RAG 评估中一个长期被模糊处理的问题:多文档查询场景下,「命中」的定义是什么?
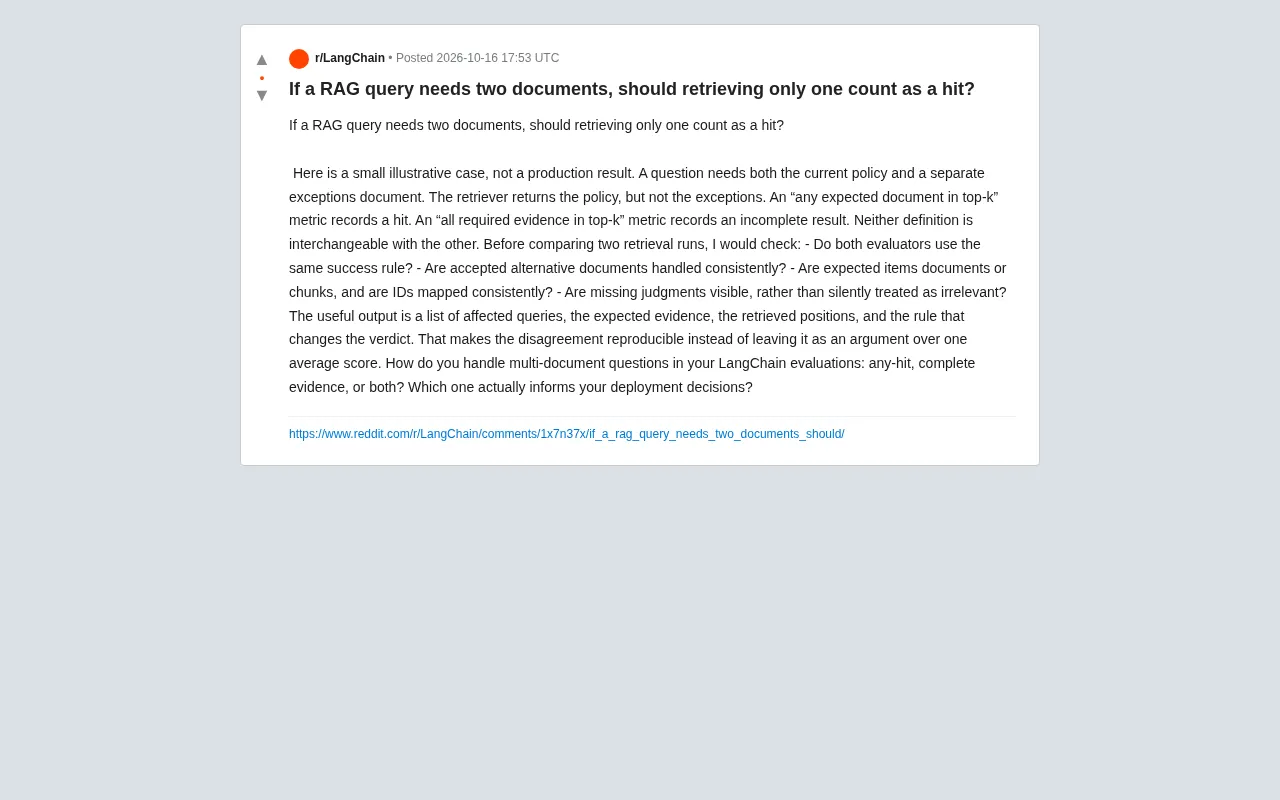
如果你正在用 LangChain 或类似框架搭建 RAG 系统,并且用 hit rate、recall@k 这类指标来对比不同检索方案的效果,这个问题不搞清楚,选型决策可能从一开始就是错的。
为什么「命中」的定义会分裂
大多数 RAG 评估工具的默认逻辑是「any-hit」:只要 Top-K 结果里出现了任意一个标注为相关的文档,就算命中。
这个设计在单文档问答场景下没问题——一个问题对应一份证据,命中就是命中。但现实中大量查询是复合型的:对比分析需要两份文档,因果推理需要前后关联的两个来源,法规合规问题需要主条款加例外说明。
当问题天然需要多份证据时,any-hit 会把「只拿到一半」和「完整拿到」记为同一个结果。这直接导致两个严重后果:
指标虚高。 一个检索方案可能看起来 recall 很高,但实际上大量查询只召回了一部分所需证据。用户拿到不完整的信息,模型可能基于片面材料生成错误回答。
方案对比失真。 两个检索策略在 any-hit 指标下可能得分接近,但在 complete evidence 指标下差距巨大。你以为在选更优方案,其实只是在选同一个方案的两个变体。
hit rate(命中率)与 recall@k(前 k 召回率)的区别:hit rate 通常指「至少命中一份相关文档的查询占比」,是一个二值判定,不关心命中的是第几名;recall@k 则衡量 Top-K 结果中召回了多少比例的全部相关文档,是一个连续值。在单文档场景下两者趋势一致,但在多文档查询下,hit rate 天然偏向 any-hit 逻辑,而 recall@k 若按「召回的相关文档数 / 全部相关文档数」计算,则更接近 all-evidence 视角。这也是为什么同一个检索器在不同指标下可能表现迥异——指标背后的判定规则不同,反映的能力维度也不同。选型时应明确自己要优化的是「找得到」还是「找得全」。
对比检索方案之前,先对齐这四件事
发帖者提出了一个非常实用的检查清单。在拿两个检索跑分做对比之前,逐条确认:
- 两个评估器是否使用相同的成功判定规则? 一个用 any-hit,一个用 all-evidence,跑出来的分数没有可比性。
- 备选可接受文档是否被一致处理? 有些查询存在多个等效的正确答案,如果评估器对「备选文档」的认定不一致,结果同样不可比。
- 预期对象是文档还是 chunk?ID 映射是否一致? 同一个知识库内容,有人按整篇文档标注,有人按 chunk 标注,粒度不同导致命中判定完全不同。
- 缺失的标注是否被显式记录,而不是静默当作不相关? 这是最隐蔽的坑。如果评估数据集中某些查询根本没有完整的相关性标注,any-hit 会把「没标注」当成「不相关」,从而低估实际召回能力。
这四条检查看起来基础,但它们解释了为什么很多团队在 RAG 评估上反复扯皮——大家表面在争论一个平均分,实际上连评分规则都没统一。
文档粒度 vs chunk 粒度:文档级评估把整篇文档作为命中单位,只要检索结果落在该文档内即算命中;chunk 级评估则要求检索到的具体片段与标注的相关片段匹配。粒度选择直接影响指标数值:文档级更宽松,容易得到高分但可能掩盖检索精度问题;chunk 级更严格,更贴近生成阶段实际使用的上下文,但对标注质量要求更高。实践中常见的问题是评估器用 chunk 级检索、却用文档级标注,导致 ID 映射错位,命中判定出现系统性偏差。统一粒度并建立稳定的 doc-to-chunk ID 映射,是可复现评估的前提。
真正有用的输出:不是分数,而是差异清单
发帖者给出了一个很有价值的建议:与其争论哪个指标的平均分更高,不如输出一份受影响的查询清单。
具体包括:
- 哪些查询在两种规则下产生了不同判定
- 每个查询的预期证据是什么
- 实际检索到的位置(排名)
- 导致结论翻转的具体规则
这份清单的价值在于:它把「指标分歧」从主观争论变成了可复现的事实。团队成员可以逐条查看:原来是这个查询的第二份文档没被召回,any-hit 记了命中,all-evidence 记了未命中。讨论的焦点从「哪个指标更好」变成「这个查询到底需不需要两份文档」,后者才是有答案的问题。
any-hit、all-evidence,还是两个都要?
回到发帖者最后的问题:在实际部署决策中,你会选哪个?
从工程实践角度,两个指标回答的是不同问题:
any-hit 衡量的是「检索器有没有找到相关信息的能力」。它适合排查检索器是否存在完全失效的情况——如果连任意一份相关文档都找不到,说明检索环节有严重问题。
all-evidence 衡量的是「检索器能否支撑完整回答」。它直接关联到最终生成质量——证据不全会导致模型幻觉或回答不完整。
在部署决策中,all-evidence 应该作为主要参考指标,因为它更贴近用户实际体验。但 any-hit 可以作为诊断工具保留:当 all-evidence 得分低时,看 any-hit 是否正常,能快速区分是「完全没找到」还是「找到了但不全」。
这两个指标的差距本身就是一个有价值的信号。如果 any-hit 高而 all-evidence 低,说明问题出在覆盖度——可能需要增加 Top-K、改进 chunk 策略、或者引入多跳检索。如果两个都低,说明检索器的基础能力就有问题。
多跳检索(multi-hop retrieval):当一个问题需要串联多份文档才能回答时,单次检索往往难以同时召回全部证据,此时需要多跳检索——先检索第一批文档,基于其结果构造新的查询,再检索下一批,逐步拼齐完整证据链。它与 all-evidence 指标天然契合:all-evidence 得分低而 any-hit 正常,恰恰是多跳检索的典型适用信号。实现上可结合查询改写、迭代检索或图结构遍历。需要注意的是,多跳会引入额外的延迟与误差累积,是否值得取决于业务对证据完整性的要求。
多文档查询的评估,没有万能答案
需要承认的是,多文档查询的评估本身就比单文档复杂得多。什么样的文档组合算「完整证据」,往往取决于具体任务和业务场景。一个法律问答系统的「完整」标准,和一个技术文档助手的「完整」标准,可能完全不同。
但至少有一件事可以做到:在评估流程中显式声明使用哪种规则,并确保对比的双方规则一致。 把隐式的假设变成显式的约定,是让 RAG 评估从「吵架」走向「工程」的第一步。
相关推荐
Obsidian接入AI:开源四层骨架与四大技能
B站UP主鲸鱼大小姐开源一套Obsidian接入AI的四层骨架与四个技能,包含日常整理、截止时间、刷题、课件转换,全部开源,纪律严格,边界清晰。
本地AI为何难普及?算笔账就明白了
本地AI为何难普及?科技博主用详实数据算了一笔账:高端GPU硬件成本远超ChatGPT订阅费,速度与并行能力受限,本地AI目前只适合技术爱好者。文章同时探讨了操作系统混合AI与本地路由的未来路径。
AI模拟数千个台风季,重塑热带气旋风险评估
AXA与NVIDIA Earth-2利用AI生成超过一千个模拟气旋赛季,突破46年历史数据的稀疏局限,为热带气旋风险评估和保险定价提供更丰富的概率视角。