RAG评估噪声从哪来?法官与生成器谁在捣乱

拆解实验显示RAG评估噪声来源因指标而异:faithfulness和relevancy主要来自生成答案,recall和precision完全来自法官,法官温度0仍不稳定,比较配置需超过噪声门槛。
本文通过拆解实验分析RAG系统评估分数的run-to-run噪声来源。基于15篇论文、18个问题和k=8的检索设置,使用gpt-oss-20b生成答案、Gemini 3.5 Flash Lite作为法官,计算RAGAS四个指标。发现faithfulness约85%的方差来自生成答案,answer relevancy几乎全部来自答案,而context recall和precision的方差100%来自法官,因为后两者不读取生成答案。法官temperature=0仍无法保证重复性,源于claim切分数量和yes/no判断的随机翻转。作者给出了比较两次单次运行的门槛:faithfulness约0.15、relevancy约0.08、recall约0.09、precision约0.10。据此推翻前文"最优k=8"的结论,并建议复现策略因指标而异:recall和precision只需重判保存结果,faithfulness和relevancy必须重新生成答案。
RAG系统的评估分数常常在配置不变的情况下波动,这种噪声到底来自LLM法官的评分不一致,还是生成器每次写出不同的答案?一位开发者在自己的系统上做了拆解实验,结论可能和直觉相反。
核心发现:不同指标的噪声来源截然不同
实验基于15篇研究论文、18个评估问题、k=8的检索设置。生成器使用Groq上的gpt-oss-20b,法官是Gemini 3.5 Flash Lite,通过RAGAS 0.2.15计算faithfulness、answer relevancy、context precision和context recall四个指标。
关键结论是:faithfulness约85%的run-to-run方差来自生成的答案,answer relevancy几乎全部来自答案;而context recall和context precision的方差100%来自法官——因为RAGAS计算这两个指标时根本不读取生成的答案,它们只比较检索到的chunks与问题、参考答案。在确定性检索的前提下,重新生成答案不可能改变这两个分数。
据作者在实验中记录的数据,当只重复评判同一批保存的答案时,18题均值的标准差为0.021(faithfulness)到0.035(precision);而重新生成答案后,faithfulness的标准差升至0.054,relevancy从0.002升至0.028。
RAGAS(Retrieval-Augmented Generation Assessment)是一个用于评估RAG管道的开源框架,它定义了四个核心的无需人工标注的指标。Faithfulness衡量生成答案中的每个claim是否都能从检索到的上下文中推断出来,计算方式是提取答案中的原子声明并逐一用LLM验证。Answer relevancy则评估答案与问题的相关程度,传统做法是让LLM根据答案反推可能的问题,再计算生成问题与原问题的embedding相似度。Context precision检查检索到的chunks中有多少是真正相关的,以及相关chunk是否排在前面;context recall则衡量参考答案中的信息有多少被检索到的上下文覆盖。这四个指标中,前两个需要读取生成的答案,后两个仅依赖检索结果和参考答案,因此它们的噪声来源天然不同。
法官温度设为0,仍然不会重复自己
作者原本以为把法官的temperature设为0就能获得一致输出,但实验显示并非如此。三次评判相同的答案和chunks,precision的18题均值波动了0.085,faithfulness波动0.042,recall波动0.046,只有relevancy相对稳定在0.003。
原因藏在各指标的构造方式里。Faithfulness先把答案拆成claims再逐条核对,而法官对同一段答案拆出的claim数量会变——有一条答案三次分别被拆成5、10、11条,分母一动分数就动。Precision和recall由yes/no判断构成,148条chunk判断中有5条在三次之间翻转,22条reference-statement判断中有3条翻转;由于18条参考答案中14条只有一句话,recall在那些题上非0即1,一次翻转就让整题从1变0。Relevancy之所以稳定,是因为它让法官写出答案似乎在回应的问题,再用embedding模型与真实问题比对,embedding步骤平滑了法官的措辞差异。
LLM的temperature参数控制采样随机性,理论上设为0时应进行贪婪解码,即每次选择概率最高的token,从而产生确定性输出。然而实际中,即使temperature=0,输出仍可能不一致,原因包括:GPU浮点运算的非确定性(并行归约顺序不同导致微小数值差异)、模型服务端的批处理与缓存策略、以及某些API对temperature=0的实现并非严格的贪婪解码。此外,RAGAS的某些指标(如faithfulness)涉及多步LLM调用(先提取claims再逐条验证),每一步的微小波动都会累积。对于yes/no判断,模型对提示词格式、上下文长度甚至换行符的敏感也会导致边界样本翻转。因此,temperature=0只能减少但不能消除run-to-run方差,尤其在多步推理和分类任务中。
一个0.15的门槛,让之前的"最优k"失效
基于测得的噪声,作者给出了比较两次单次运行的参考门槛:faithfulness约0.15、relevancy约0.08、recall约0.09、precision约0.10(18题规模,9题子集上约宽40%)。这个数字的含义是,两个配置各跑一次得到的均值差,要超过这个门槛才值得认真对待。
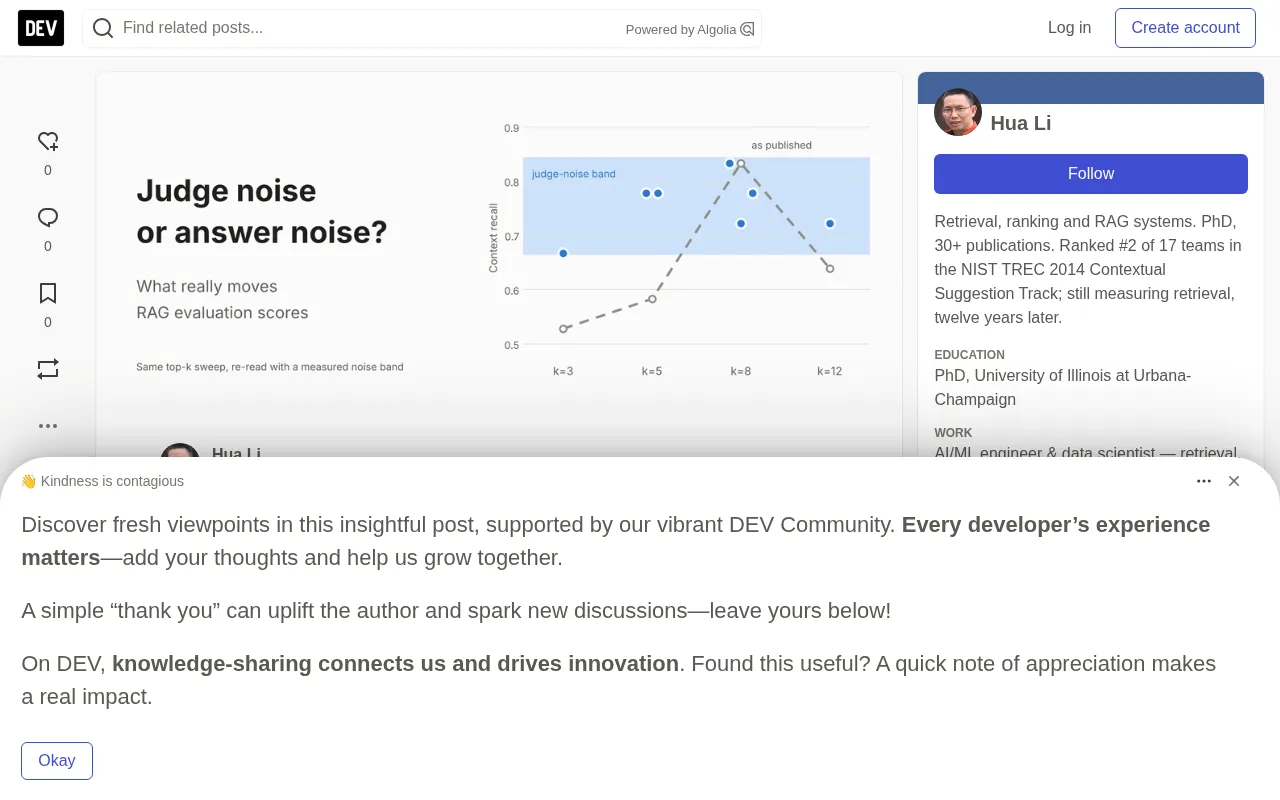
把这些门槛套回作者上一篇的top-k扫描,结论就站不住了。原来的"最优k=8"有两个问题:一是不同k的运行覆盖了不同的问题集,k=8那次0.83的recall只覆盖了9/18题,而法官失败的恰好是更难的题;二是每个配置只跑了一次。把所有运行统一到相同的9题上,曲线摊平在0.67到0.83之间,七次运行全部落在法官噪声带内,扫描根本无法区分各个k值。
在统计假设检验中,p值表示在原假设成立时观察到当前或更极端结果的概率,通常p<0.05被认为显著。但显著性不等于实际重要性,尤其在大样本下微小差异也可能显著。效应量(effect size)则量化差异的实际大小,例如Cohen's d或均值差。本文提出的"门槛"本质上是基于噪声标准差设定的最小可检测效应(minimum detectable effect),类似于实验设计中的功效分析。当两次运行的均值差小于噪声带时,无法区分是配置真实差异还是随机波动。作者用18题均值的标准差乘以一个系数(约2-3倍)得到门槛,这对应于约95%置信区间的重叠判断。对于小样本(如9题子集),标准差估计不稳定,门槛需放宽约40%,这与统计理论一致。
被推翻与被加强的旧结论
作者逐条复盘了前文的判断。"k=3检索不足"从结论降级为线索——k=3在匹配题集上recall最低(0.67,其余运行均值约0.77),但差距低于9题规模0.13的门槛,且全部来自一道题。"法官模型的影响大于k参数"反而被加强了:换法官模型让recall移动0.31、faithfulness移动0.26,分别是各自门槛的三倍和接近两倍。
"显著性检验找不到差异"的原因也清楚了:14条单句参考答案让recall只能取0或1,任何两个检索到同一相关chunk的配置都会精确打平,Wilcoxon检验没有可用的信息。
该复现什么,取决于指标读不读答案
这是全文最实用的操作建议:对recall和precision,重跑法官评判保存的结果即可,还省掉生成调用;对faithfulness和relevancy,必须重新生成答案,因为只重判只能捕捉faithfulness约15%的方差,会让它看起来比实际稳定一倍以上。
作者还建议:评分前冻结题目列表并报告每一行结果及缺失原因(0.833和0.833 (9/18)是两个不同的声明);在能给每道题标注应检索文档的情况下,用简单计数计算recall@k,确定性检索下这类指标完全没有run-to-run噪声;把参考答案写成多条可核对的claims,避免单句参考把recall变成抛硬币。
run-to-run方差分解(variance decomposition)是实验科学中的常用方法,通过重复测量不同来源(如生成器、法官)来估计各自对总方差的贡献。本文中,作者固定法官重复生成答案,或固定答案重复法官评判,从而分离出答案噪声和法官噪声。类似地,在机器学习中,交叉验证的方差也常被分解为模型方差和数据方差。对于RAG评估,理解方差来源有助于设计高效的复现策略:如果法官噪声占主导,则只需重复评判;如果答案噪声占主导,则必须重新生成。此外,报告置信区间或标准误比单点估计更可靠,尤其在样本量小(如18题)时,均值的标准误可能很大,单次运行的分数可能偏离真实均值数个标准差。
失败案例揭示的指标盲区
逐题视角还暴露了几种评分失效。一道问哪篇论文获最佳论文奖的题,正确答案是"没有",三次生成都答对了,但faithfulness分别给了1.00、0.33和0.00——否定句本身无法对照chunks核验。另一道问论文涉及哪些认知偏差的题,一次生成诚实地说论文没有点名具体偏差,relevancy给了0;另一次生成自信地列出一个语料库中不存在的偏差,relevancy反而拿了0.58,只有faithfulness抓住了编造(0.17)。这正是不该单独看relevancy的理由。
缺失分数也有可修复的成因:约1200次法官调用中有两次因JSON转义格式错误失败;某天法官响应变慢十倍,context precision在16/18题上超时,因为RAGAS的超时限制覆盖单题单指标的全部调用,而precision在k=8时每题要发起8次法官调用。没有按原因记录日志,这些都会变成静默缩小平均值的NaN。
作者已开源完整实验代码与原始法官输出,并计划将13条单句参考答案改写为多条claims后重判,验证能否降低recall上的法官噪声。这套方法的价值不在于具体阈值——它们只适用于这个15篇论文、18题的小系统——而在于"先测噪声、再比配置"的评估习惯。
相关推荐
Obsidian接入AI:开源四层骨架与四大技能
B站UP主鲸鱼大小姐开源一套Obsidian接入AI的四层骨架与四个技能,包含日常整理、截止时间、刷题、课件转换,全部开源,纪律严格,边界清晰。
本地AI为何难普及?算笔账就明白了
本地AI为何难普及?科技博主用详实数据算了一笔账:高端GPU硬件成本远超ChatGPT订阅费,速度与并行能力受限,本地AI目前只适合技术爱好者。文章同时探讨了操作系统混合AI与本地路由的未来路径。
AI模拟数千个台风季,重塑热带气旋风险评估
AXA与NVIDIA Earth-2利用AI生成超过一千个模拟气旋赛季,突破46年历史数据的稀疏局限,为热带气旋风险评估和保险定价提供更丰富的概率视角。