RAG系统与Demo的分界线:评估门禁与黄金集

RAG演示与系统的分界线是一套黄金集加一道CI门禁,用可回归的检索指标防止无声退化。
文章指出大多数RAG项目止步于演示,核心问题是检索质量在无人监控下悄悄退化。CodebaseRAG作者提出用至少40对公开黄金集和CI门禁来区分演示与系统:门禁测量平均recall@5、MRR和nDCG@5,以recall@5不低于0.409为硬性基线,只守护承诺的指标,避免过度约束。六边形架构确保更换向量库或嵌入模型不重写核心,使评估保持确定性和可比性。基线0.409被明确为地板而非SOTA,提高基线需要显式ADR决策。最终结论是:系统让你可以不同意检索结果,而演示只给你一个答案。
大多数RAG项目止步于演示:提问、检索片段、模型生成一段看似合理的回答,观众点头,但没人能说清检索结果里是否包含正确答案。问题不在于模型幻觉,而在于检索质量在无人监控的情况下悄悄退化。开源项目CodebaseRAG的作者Jordi Marsal提出一个简洁的判定标准:一个RAG演示与一个RAG系统的距离,是一套黄金集加上一道CI门禁。
问题:没人测量的召回率
RAG演示的典型生命周期是这样的:初始版本效果不错,随后有人调整了分块策略、更换了嵌入模型,或者迁移到新的向量数据库。这些变更可能提升也可能损害检索质量,但团队唯一的信号是"感觉回答变差了"。这种模糊感知无法定位问题,更无法阻止回归。
作者将这种失败模式称为"无人观察的检索退化"。演示针对观众面前的成功路径优化,而系统针对一个可以回归比较的数字优化。没有评估,就没有可回归的基线;没有基线,每一次变更都是赌博。
recall@5(召回率@5)是检索评估中的常用指标,定义为:对于每个查询,检查前5个检索结果中是否包含至少一个相关文档(或所有相关文档被召回的比例),再对所有查询取平均。在黄金集场景下,每个问题通常对应一个或多个标准答案位置,recall@5衡量的是“正确答案是否出现在前5条结果中”。它不关心排序的精确程度,只关心有没有找到,因此对检索系统的“底线能力”非常敏感。相比精确率或MRR,recall@5更容忍排序噪声,适合作为门禁的硬性阈值:一旦召回率下降,意味着系统开始漏掉正确答案,这是用户可感知的退化信号。
黄金集:把"正确"变成四十个可检查的问答对
评估的诚实程度取决于问题的质量。CodebaseRAG的黄金集是一个公开的问答对列表,每个问题都是开发者会真实提出的,每个答案都附带它在代码库中的位置。集合包含至少40对——足够捕捉真实回归,又小到每一对都能被人工审查。
不需要标注平台,只需要一个记录问题的地方和持续维护的纪律。这些问答对放在代码旁边,检索逻辑的变更和对应的期望更新在同一个评审中流转。
例如,黄金集中有这样的条目:查询用例依赖哪个抽象,为什么它不是向量存储类型?答案是检索器端口,适配器实现该端口,核心代码从不导入pgvector或Qdrant的类。再如:当平均recall@5低于提交的基线时,CI应该做什么?答案是让构建失败,基线是一个提交的数字,移动它需要显式的ADR决策,而不是为了让CI变绿而随手修改。
这些例子并不难,它们的目的是让答案可辩护,从而让错误答案成为失败的测试,而不是争论。
CI门禁:什么会失败,什么不会
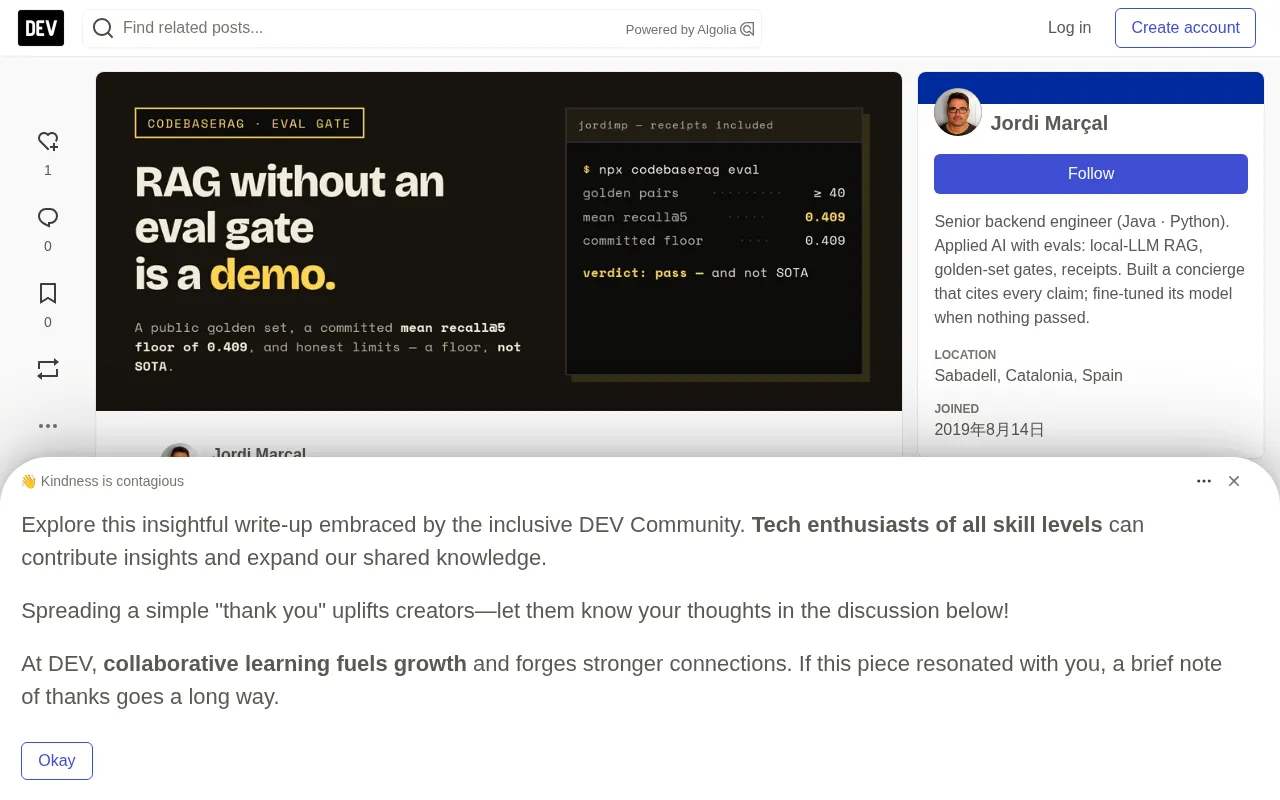
门禁只有在失败得响亮且可预测时才有用。CodebaseRAG的门禁在黄金集上测量平均recall@5、平均倒数排名(MRR)和nDCG@5,当平均recall@5低于提交的基线0.409时,构建失败。规则就这么简单。CI运行与笔记本上相同的确定性评估,因此红色构建指向检索变更,而不是环境抖动。
什么不会失败同样重要。模型变更即使MRR和nDCG@5有所波动,只要recall@5保持在基线之上就通过——门禁守护的是承诺过的指标,而不是仪表盘上的每一个数字。不改变检索逻辑的重构通过。门禁不评判回答的流畅度:这是检索评估,假装它衡量生成质量,与没有评估一样不诚实。
MRR(Mean Reciprocal Rank,平均倒数排名)和nDCG@5(归一化折损累计增益@5)是两种排序敏感指标。MRR关注第一个相关结果出现的位置:若第一个相关结果排在第1位,倒数为1;第2位为1/2,以此类推,对所有查询取平均。它惩罚“正确答案出现得晚”。nDCG@5则考虑前5个结果的相关性等级和位置折损,越相关且越靠前得分越高,再除以理想排序下的得分进行归一化。两者结合recall@5能更全面地刻画检索质量:recall@5看“有没有”,MRR看“多快找到”,nDCG@5看“整体排序好不好”。门禁只以recall@5为硬阈值,是为了避免排序波动导致构建不稳定,同时保留MRR和nDCG@5作为观察指标。
六边形架构:换向量库不能重写核心
既然测量的是检索,被测量的对象就不能和部署方式焊死。CodebaseRAG采用六边形架构:查询用例依赖端口,pgvector、Qdrant、Ollama和Anthropic作为适配器位于端口之后。检验标准很具体:把Qdrant换成pgvector,或者完全本地运行Ollama,不能重写核心。如果更换向量存储迫使用例代码改动,那么评估测量的是存储层的偶然属性,未来每次替换都会重新打开"指标是否还有意义"的问题。
保持核心不依赖框架和传输层带来的不只是整洁:它让评估保持确定性,针对内存或容器支持的适配器运行,无需网络。提交的基线只有在底层代码不随基础设施变化而变形时才可信。
六边形架构(Hexagonal Architecture),又称端口-适配器模式,由Alistair Cockburn提出。其核心思想是将应用的核心业务逻辑与外部技术设施隔离:核心通过定义“端口”(接口)来表达它需要什么能力,而“适配器”则实现这些端口,对接具体的技术如数据库、消息队列或Web框架。这样,更换外部技术只需替换适配器,核心代码无需改动。在RAG系统中,查询用例依赖“检索器端口”,pgvector、Qdrant等向量库作为适配器实现该端口。这种设计使评估可以针对内存中的假适配器运行,保证确定性和速度,同时让基线数字不会因为基础设施变更而失去可比性。
当前基线及其不声称的东西
提交的基线是平均recall@5为0.409(MRR 0.231,nDCG@5 0.277),基于至少40对黄金集。把它读作地板,而不是结果。0.409不是SOTA,也不声称检索问题已解决。它是项目承诺捍卫的数字,选择得足够低以保持稳定,足够高以捕捉真实下降。
这个数字不声称:黄金集是穷尽的、绿色构建意味着好答案、嵌入模型是最优的。提高基线是一个有记录的决策,附带理由,而不是粘贴到README里的虚荣指标。
它声称的东西更小但更有用:在每次变更时,仓库能告诉你检索是否变差了,并从公开黄金集证明这一点。这就是RAG演示与RAG系统的分界线——演示给你一个答案,系统让你可以不同意它。
相关推荐
Obsidian接入AI:开源四层骨架与四大技能
B站UP主鲸鱼大小姐开源一套Obsidian接入AI的四层骨架与四个技能,包含日常整理、截止时间、刷题、课件转换,全部开源,纪律严格,边界清晰。
本地AI为何难普及?算笔账就明白了
本地AI为何难普及?科技博主用详实数据算了一笔账:高端GPU硬件成本远超ChatGPT订阅费,速度与并行能力受限,本地AI目前只适合技术爱好者。文章同时探讨了操作系统混合AI与本地路由的未来路径。
AI模拟数千个台风季,重塑热带气旋风险评估
AXA与NVIDIA Earth-2利用AI生成超过一千个模拟气旋赛季,突破46年历史数据的稀疏局限,为热带气旋风险评估和保险定价提供更丰富的概率视角。