RAG召回率优化:从数据接入到重排的全链路漏斗工程拆解

面试中被问到「RAG系统召回率太低怎么办」,很多人的第一反应是换一个更强的向量模型。但如果你只给出这一个答案,面试官大概率会在心里默默给你打上「只会调包」的标签。
真正的召回率优化,是一个覆盖数据接入、查询处理、检索策略、重排过滤的全链路漏斗工程。B站UP主彭宇在其大模型面试系列视频中,对着一张完整的RAG架构图,将这个问题拆解为四个层次,逻辑清晰且实战性极强。本文基于该视频内容,做一次系统性的梳理和深度解读。
数据接入层:地基不牢,召回无从谈起
做RAG开发最头疼的问题,往往不是大模型不会说话,而是它「闭着眼瞎说」。根源在于喂给模型的参考文档本身就不对——就像参加开卷考试,翻遍整本书都找不到答案所在的那一页,写出来的东西自然不可能对。
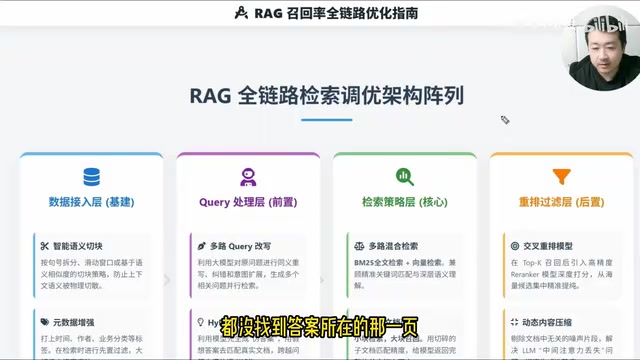
数据接入层有三个关键优化点:
智能语义切块替代固定字符切块
很多开发者还在用固定字符数进行文档切块,这会导致一段话还没说完就被截断,语义完整性被破坏。正确的做法是采用智能语义切块,或者使用滑动窗口策略让上下文有重叠区域,保证每个文档块都具备完整的语义信息。
元数据增强提升过滤效率
不要只存向量。给文档打上丰富的标签——发布时间、作者、所属业务模块等。检索时先做一轮元数据过滤,一下子就能排除掉大量干扰信息。据视频中的说法,这一步就能帮模型排除约90%的无关文档,召回率自然提升。
向量模型领域微调
如果业务中充斥着专业术语,通用的Embedding模型必然「抓瞎」。这时需要用自己领域的语料做对比学习微调(Contrastive Learning Fine-tuning),让模型真正理解你所在行业的专业话语体系。
Query处理层:用户的问题真的好搜吗?
用户往往很「懒」,提问可能只有几个词,还经常词不达意。如果直接拿原始query去检索,效果可想而知。
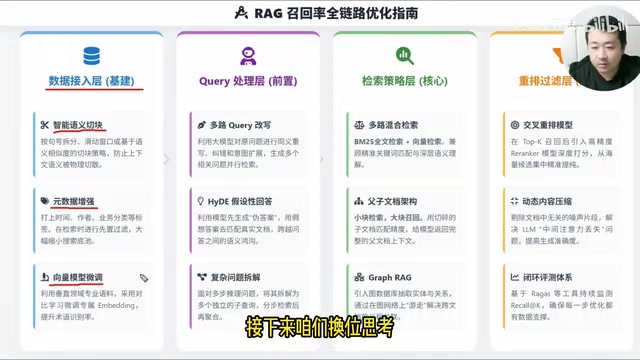
多路Query改写扩大召回面
让大模型将用户的原始问题重写为3-5个同义但不同表述的版本,然后多路并发检索。只要有一路命中了目标文档,整体召回就成功了。这是一种用「广撒网」策略对抗语义模糊性的经典方法。
HyDE假设性回答跨越语义鸿沟
这是一个非常巧妙的技巧:先让大模型针对用户问题「盲猜」一个答案。虽然这个答案可能不准确,但它的向量特征与真正的目标文档高度相似。用这个假答案的向量去检索真文档,能够有效跨越语义鸿沟——用户的提问方式和文档的表述方式之间的gap,被这个中间桥梁巧妙地弥合了。
查询拆解处理复杂问题
遇到复杂问题,比如「某人的公司法人是谁」,这其实包含两步:先找到这个人的公司,再找公司的法人。必须做查询拆解(Query Decomposition),把一个复杂问题拆成多个子问题,逐步检索、逐步推理。
检索策略层:向量检索不是万能的
很多人迷信向量检索,觉得「语义万岁」。但现实是,如果用户搜索的是一个特定的设备型号(如「XJ-2024-A3」),向量检索很可能搜出一堆「长得像」但完全错误的结果。
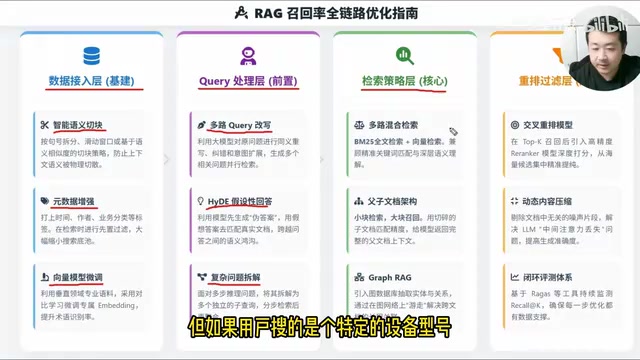
混合检索:语义匹配与关键词精确匹配并行
必须上混合检索(Hybrid Search):向量检索负责语义理解,BM25负责关键词精确匹配。两者结合,既能「懂你的意思」,又能「对得上你的暗号」。这在工程实践中已经被反复验证为比单一检索方式效果更好的方案。
父子文档架构:小块检索,大块召回
这是视频中重点推荐的策略:检索时用切得极碎的子文档去匹配,保证检索精度;但喂给大模型时,把完整的父文档送过去,保证上下文完整性。这就是所谓的「小块检索,大块召回」——既准又全。
Graph RAG应对多跳推理
当文档之间的关系特别复杂时,需要引入知识图谱。通过实体和关系的图遍历,把那些藏在角落里的关联信息一把抓回来。这对于多跳推理类的问题尤其有效。
重排与过滤层:漏斗的最后一关
前面几层为了不漏掉答案,可能召回了50个文档。但这50个不可能全是「好苗子」,必须经过最后的精筛。
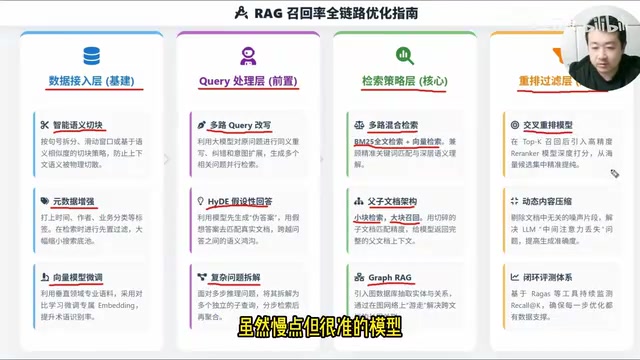
Cross-Encoder交叉编码器重排
用精度极高的交叉编码器模型对召回的文档重新打分,选出最顶尖的Top 5。交叉编码器虽然推理速度慢,但它能对query和document进行深度交互计算,排序精度远超双塔模型。这就是「宽进严出」的漏斗哲学。
上下文动态压缩解决注意力丢失
即使拿到了Top 5的文档,也不能直接全部塞给大模型。大模型存在**中间注意力丢失(Lost in the Middle)**的问题——当输入文本过长时,模型对中间部分的关注度会显著下降。因此需要做上下文压缩,剔除文档中的噪声信息,只保留与问题最相关的精华内容。
闭环评估机制驱动持续优化
最关键的一点:不要凭感觉判断「召回率好像高了」。必须建立量化评估体系,盯着Recall@K、MRR、NDCG等指标看。没有指标的优化,都是蒙眼狂奔。
面试回答框架总结
当面试官问「RAG召回率低怎么办」时,千万不要只说一个点。你应该告诉他,这是一个全链路的漏斗工程:
- 前期靠数据基建(智能切块、元数据增强、模型微调)和查询改写(多路改写、HyDE、查询拆解)保底
- 中期靠混合检索和父子文档架构提效
- 后期靠重排模型和上下文压缩精筛
卓越的工程师从不迷信某个单一模型或单一技术,而是用一套组合策略去对抗系统的不确定性。这种系统性思维,才是面试官真正想考察的能力。
相关推荐

Claude Code实战指南:从零搭建专属AI编程助理
基于实战教程梳理Claude Code从环境搭建、国产模型切换到Git工作流与命令体系的完整路径,帮助开发者快速搭建专属AI编程助理,少走弯路。

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。