RAG知识库搭建全流程:从架构到检索评估实战指南
RAG以低耦合特性成为零基础切入大模型的入口,检索评估是质量关键。
文章基于一场RAG专题直播课程,介绍RAG为何值得单独学习:它针对大模型不了解私有数据和易编造事实两大痛点,且与其他模块耦合度低,零基础开发者也能切入。架构上,RAG是文档切分、向量化入库、检索片段、交给大模型生成的两段式流水线,业界已有成熟工作流可参考。文章强调检索评估是决定RAG好不好用的关键,回答质量不稳定往往源于召回错误而非生成能力。适合人群包括转型工程师、零基础学习者和产品经理,推荐按架构认知、检索评估、代码实战的顺序学习,并提醒结合具体业务场景边搭边验证。
为什么RAG值得单独拿出来讲
大模型落地时最常遇到的两个问题:模型不知道企业私有数据,以及回答容易编造事实。RAG(检索增强生成)正是针对这两个痛点的工程方案——把外部知识库接进生成流程,让模型基于检索到的真实文档来回答。据B站一场RAG专题直播课程的讲师介绍,RAG与大模型其他模块的耦合性相对较低,因此零基础开发者也能从RAG切入大模型开发,这也是它成为热门学习方向的原因之一。
RAG整体架构拆解
检索与生成的两段式结构
RAG的架构可以理解为一条流水线:文档经过切分、向量化后存入知识库;用户提问时,系统先检索出相关片段,再把这些片段作为上下文交给大模型生成答案。讲师的课程正是从这张架构图讲起,强调先建立全局视角,再深入细节。
向量化(Embedding) 是把文本映射为高维数值向量的过程,语义相近的文本在向量空间中距离更近。RAG 中的"向量化后存入知识库"指的是用嵌入模型(如 BGE、text-embedding-3 等)把每个文档片段编码成向量,写入向量数据库;用户提问时,问题也被编码成同维度向量,系统通过余弦相似度或内积做近似最近邻搜索,找出最相关的若干片段。嵌入模型的选择直接影响检索质量——它决定了"语义相近"的判定标准,因此换用不同模型往往需要重新建库。
向量数据库(如 Milvus、Qdrant、FAISS、pgvector)专门为高维向量的相似度检索做了索引优化(如 HNSW、IVF),能在海量片段中快速返回 Top-K 结果。它和传统关键词检索的区别在于:前者匹配语义,后者匹配字面词,这也是 RAG 能回答"换个说法也能找到"这类问题的原因。
成熟方案已经存在
直播间有学员提问“RAG检索的工作流有没有比较成熟的方案”,讲师的回答是:有,而且会在后续内容中展开。这意味着搭建私有知识库不必从零造轮子,业界已有可参考的工程范式。对初学者来说,先理解成熟方案的流程设计,比急着写代码更有价值。
检索评估:决定RAG好不好用的关键环节
课程第一天的主题聚焦在检索评估。很多人搭完RAG后发现回答质量不稳定,问题往往不在生成端,而在检索端——召回的内容不对,模型再强也答不好。讲师把评估流程拆成若干细节逐一讲解,虽然当晚不涉及代码,但这种从思维高度俯瞰流程的方式,能帮学习者建立判断标准:什么样的检索结果算合格,哪些环节需要重点调优。
评价检索端常用三个指标:召回率(Recall@K) 衡量相关文档有多少被检索到,精确率(Precision@K) 衡量返回结果中有多少是真正相关的,MRR(平均倒数排名) 则关注第一个相关结果出现得有多靠前。实践中还常看 命中率(Hit Rate),即 Top-K 中至少包含一个相关片段的提问占比。评估通常需要人工标注一批"问题—正确片段"的对照集,再离线跑指标。
另一个关键概念是 分块(Chunking):文档切得太碎会丢失上下文,切得太大又会稀释语义、挤占上下文窗口。分块大小、重叠长度、是否按标题或段落边界切分,都会显著影响召回效果,也是检索评估时最值得优先调优的超参数之一。
谁适合学RAG
讲师在开篇做了一次受众调研,覆盖了几类人群:正在做Python或Java开发、考虑转向大模型开发的工程师;完全没有基础但想进入大模型领域的学习者;以及公司里已经在做RAG、想对照了解不同流程实现的从业者。产品经理同样被明确列为适合人群——理解RAG的能力边界,有助于更合理地设计AI产品需求。
学习路径建议
从这场课程的设计看,一条可行的路径是:先建立RAG架构的全局认知,再吃透检索评估的流程与指标,最后进入代码实战。讲师提到后续几天会由不同老师带来进阶内容,形成连续的学习节奏。对于自学的人来说,同样可以按“架构→评估→实现”的顺序推进,避免一上来就陷进工具细节。
需要提醒的是,RAG的效果高度依赖数据质量和检索策略,照搬教程里的流程未必能直接解决自己业务中的问题。带着具体场景去学,边搭建边用评估流程验证,才是少走弯路的做法。
在评估与实现之间,还有两个经常被提到的工程环节值得先建立概念:重排序(Rerank) 是在向量粗召回之后,用交叉编码器对候选片段做更精细的相关性打分并重新排序,能明显提升 Top 结果的准确性,代价是额外延迟;混合检索 则把向量检索与 BM25 等关键词检索的结果融合,兼顾语义匹配和专有名词、编号类查询的字面匹配。理解这两者的定位,有助于在实战阶段判断"回答不好"究竟该从哪一层下手修。
相关推荐
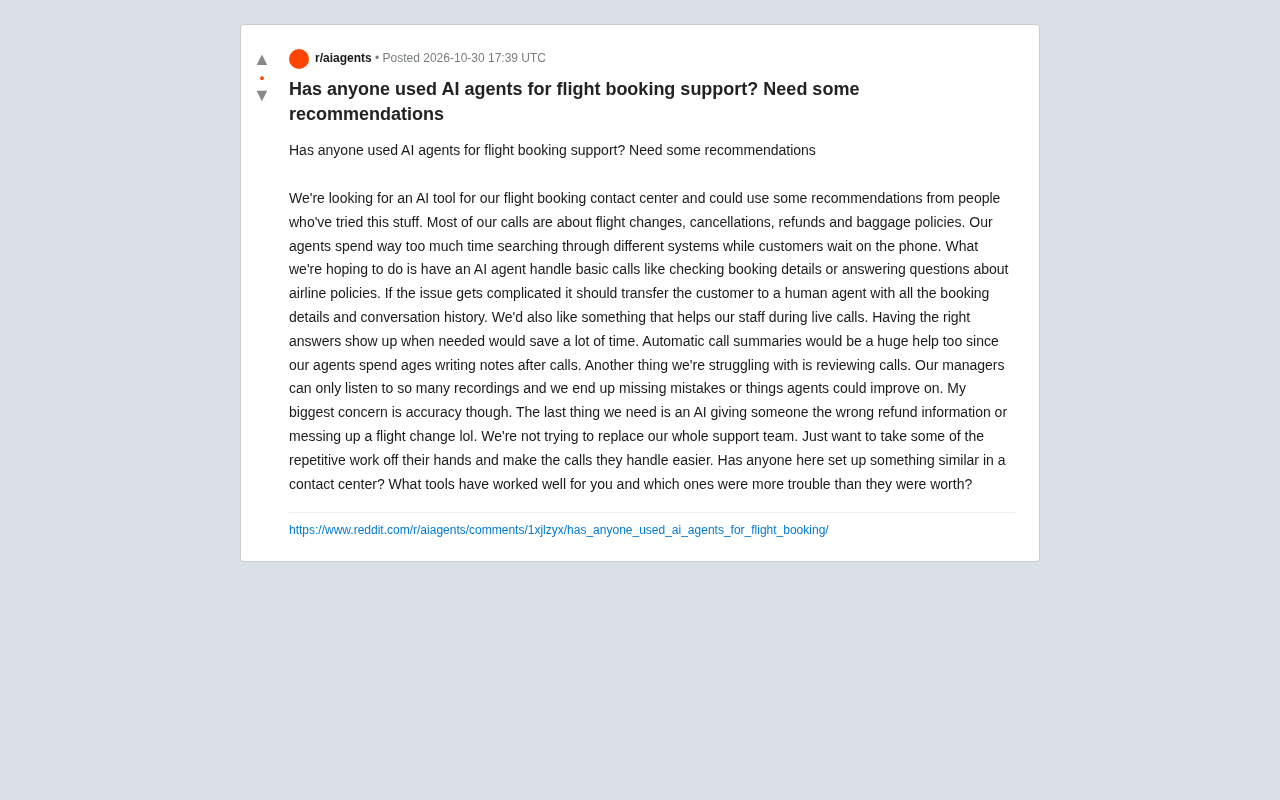
机票预订客服引入AI Agent:真实需求与落地难点
从Reddit真实提问出发,拆解机票预订呼叫中心引入AI Agent的四类需求:基础问答、座席辅助、通话摘要与质检,并分析准确性顾虑与转人工边界的设计要点。

Vercel 统一运行时缓存:Data Cache 并入 Runtime Cache
Vercel 将 Data Cache 并入 Runtime Cache,统一 Next.js fetch 缓存、unstable_cache、getCache 与 use cache: remote 的存储配额与计费,Pro 和 Enterprise 项目获得更大存储空间,缓存读写开始按 Runtime Cache 定价计费。

谷歌卫星AI服务器升空:Gemma模型在轨生成首条回复
谷歌宣布其搭载TPU的卫星成功启动,板载Gemma 4模型从太空生成首条回复,完成在轨AI推理验证。本文分析太空AI服务器的技术路径、现实约束及对边缘计算与卫星遥感的意义。