让AI记住你的项目:Claude Code记忆系统搭建指南
用日志、目录、决定本三个纯文本文件,让AI跨窗口记住项目。
文章针对AI在新对话窗口中“失忆”的痛点,提出一套纯文本的外部记忆方案。核心是三件套:工作日志记录每次改动的原因、踩坑与待办,并附具体标签;目录为每篇日志提供时间、摘要和标签,且规定只搜标签不搜摘要,以降低无关结果;决定本只追加不修改,记录长期有效的规则并指回日志。关键机制是在总规则文件开头写“开工先看目录”,让AI动手前先检索历史。作者以整理下载文件夹为例,三次全新窗口的需求验证了方案可行。文章还给出安装要点、反面检查方法、目录约15万字的读取上限与归档策略,并指出多AI并发写入时30条仅存3条,记忆系统仍需演进。
每次新开一个对话窗口,AI就像失忆了一样,之前聊过的项目细节、定好的规则统统不记得。这不是模型本身的问题,而是你缺少一套给AI用的"外挂记忆"。这期内容拆解的正是这个痛点:用三个纯文本文件,让Claude Code在新窗口里也能"记住"你的项目。
为什么AI总是忘记你
新开一个对话窗口,对AI来说就是一个全新同事——上次聊过什么、定过什么规矩,一概不知道。即便在同一个窗口里,聊得太久前面的内容也会被压缩,细节随之丢失。据B站UP主的实测分析,这种遗忘源于对话历史无法跨窗口翻查,指望聊天记录本身并不靠谱。
解决方案出乎意料地简单:给AI三样东西——一本工作日志、一页目录、一本决定本。三者全部是普通文本文件,不装插件、不用数据库,你自己随时能打开查看。
大语言模型本身是无状态的:每次推理调用只基于当前输入的上下文窗口(context window)生成回复,模型权重中并不保存任何对话记忆。所谓“聊天记录”只是被拼进本次上下文的文本,窗口关闭即丢弃。上下文窗口有硬性长度上限,超出后系统通常采用截断或摘要压缩,越靠前的内容越容易被丢弃,因此长对话中早期细节会逐渐消失。这也是为什么单纯依赖聊天记录不可靠——它既不能跨窗口持久化,也无法保证在窗口内完整保留。把关键信息落到外部文件,再在每次开工时主动读入,等价于为模型构造一个可检索、可持久化的外部记忆层,绕开了模型无状态的限制。
三件套:工作日志、目录、决定本
工作日志:记录每次改动的原因
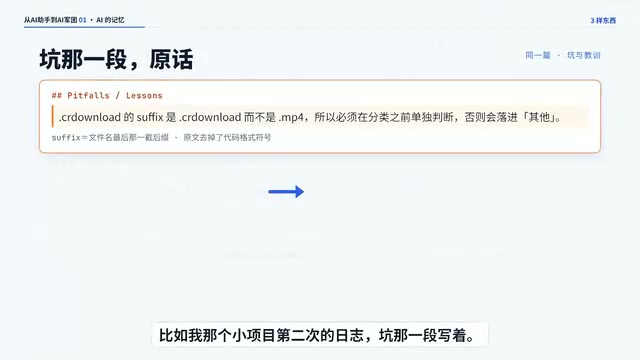
每提一次需求,AI做完后就写一篇日志,分五段:改了什么、为什么定了、踩了什么坑、还有什么没想清楚。改一个错别字写三句就够,改动越大写得越全。据UP主分享,他那个小项目的第二次日志里,"坑"那一段记录的是:没下完的电影文件名后面不是视频格式,而是一个下载中的标记,必须先单独挑出来,否则会被混进其他文件。
每篇日志开头还挂一串标签,标签要写具体——比如"没下完""同名""分类规则",而不是笼统的"修了个问题"。以后AI翻旧账,搜的就是这串标签。
目录:让AI一眼看到历史
每篇日志在目录里占一条,包含时间、名字、一句话摘要和一串标签,最新的排在最上面。据UP主实测,72条目录如果整条都搜,试两个词搜出来的不相干结果分别占六成多和七成多,不相关的太多,AI后来干脆懒得翻。所以规则被简化为:只搜每条最后那串标签,不搜前面那句话。
这里的“搜索”并非数据库全文检索,而是让AI在已读入上下文的目录文本里做模式匹配。整条目录包含时间、名称、摘要和标签,摘要往往使用自然语言,与用户查询词的字面重合度低,容易引入语义相近但主题无关的条目,实测六到七成的不相关率正源于此。标签则是人工提炼的关键词集合,区分度高、噪声低,把检索范围收窄到标签,相当于用人工建立的受控词表替代自由文本匹配,召回更准。这也解释了为何要求标签写得具体:标签越抽象,命中范围越宽,无关结果越多;标签越贴近具体问题域,AI翻到正确日志的概率越高。
决定本:回答"我们到底定了什么"
决定本记录很久以前定下的规则,一条一句话写清定了什么、为什么,再指回那篇日志。比如:"没下完的文件跳过原地不动——为什么?下载到一半被挪走,下载会失败。"决定本只许往后加,哪天推翻了不改旧的,加一条新的写明它取代了谁。日志回答"当时为什么这么改",决定本回答"我们到底定了什么"。
只追加不修改的做法借鉴了事件溯源(event sourcing)思想:状态不由一条可被覆盖的记录表示,而由一系列不可变事件按时间累积而成。这样任何时刻都能回溯“某条规则何时、因何被确立或被取代”,避免旧记录被改写后丢失决策脉络。对AI而言,决定本是一份稳定的规则快照,新窗口读入后即可获得当前有效的约束集合,而不必逐篇翻阅日志重新推断。取代关系显式写明“新条目取代谁”,等价于在追加序列上维护一条有效的版本链,使规则演进既可审计又可回滚。
关键机制:开工先读目录
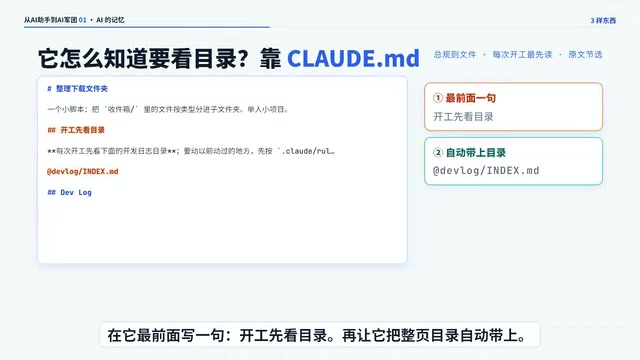
光会写还不够,真正值钱的是AI动手之前先去翻。据UP主分享,他在总规则文件最前面写了一句"开工先看目录",并让AI把整页目录自动带上。这样不管开多少个新窗口,AI第一眼看到的都是这页目录。
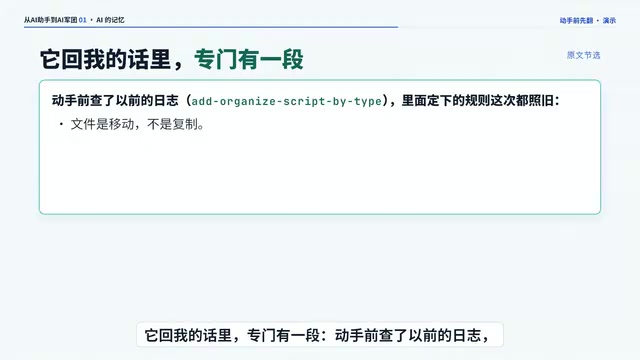
他用一个整理下载文件夹的小脚本从零走了一遍,共提了三次需求,每次都是全新窗口:第一次把说明书丢给AI,让它自己装好三样东西,从开始到装完一分半钟;第二次写整理脚本,AI自己定了四条规矩——文件是挪走不是复制、没下完的文件跳过、同名的不覆盖改个名字、还能先演一遍只列出要挪哪些不震动文件,这些都记进了日志和决定本;第三次又是新窗口,要求加一个按月份分文件夹的功能。AI不记得上次聊过,但一开工就读到了目录,于是动手前先把"分类""移动""月份"这几个词在目录里挨个搜了一遍,一下就翻到了上次那篇日志。它回话里专门有一段"动手前查了以前的日志,里面定下的规则这次都照旧"。
怎么装:交代清楚三件事
安装方式就是第一次做的那样:把说明书丢给AI,交代清楚三件事。
第一,时间用哪个时区定一个,别混着用,不然目录的先后顺序会乱。第二,在项目里哪些地方一改就要先翻旧账,写得越具体AI越不会忘了翻。第三,要不要再开AI自带的记忆功能——小项目可以先不开。
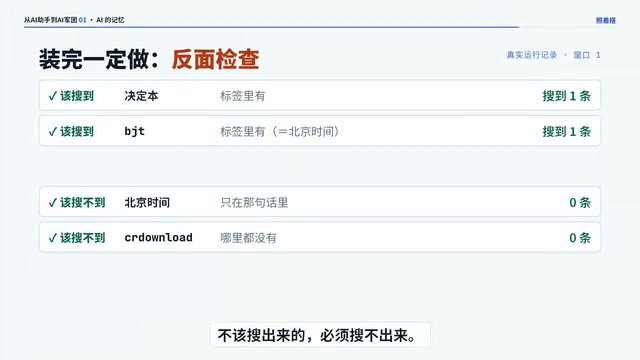
装完一定要做一次反面检查:该搜出来的能搜出来,不该搜出来的必须搜不出来。让他照说明书做了,比如搜"说明书"这个词,只看标签是零条,整个目录搜有两处——说明不是搜坏了,是"只搜标签"这条规矩在起作用。
还有一件事:目录会越来越长,AI每次开工都要读一遍,它能自动读进去的大约15万字为限,快到14万的时候就把最老的那批挪进一个旧档文件,搜的时候两份一起搜。
“自动读入约15万字为限”对应的是模型上下文窗口的token预算:中文字符与token并非一一对应,15万字大约对应数十万token量级,接近或超过常见模型的窗口上限,因此需要预留余量。目录每次开工都被完整读入,属于固定开销,会挤占用于实际任务的上下文空间;当日志条目持续增长,固定开销膨胀,模型可用于推理的余量下降,响应质量与速度都会受影响。把最老的一批条目移入旧档文件,是在保持检索完整性的同时控制常驻上下文体积——日常检索只读主目录,需要追溯历史时再连同旧档一起搜索,相当于做了一次冷热数据分层。
单人够用,一群人呢?
按UP主的说法,一个人配一个人工智能,这样就够用了。可要是一群AI同时往同一页目录里写、又不加任何保护呢?他做过一次实验:30条同时写进去,最后只剩3条。从单助手到多助手协作,记忆系统还需要新的玩法,这也是下期要展开的方向。
你的人工智能最常忘的是什么?欢迎在评论区聊聊。
相关推荐
 科技前沿
Textly:Mac上任意位置抓取文字和表格的效率神器
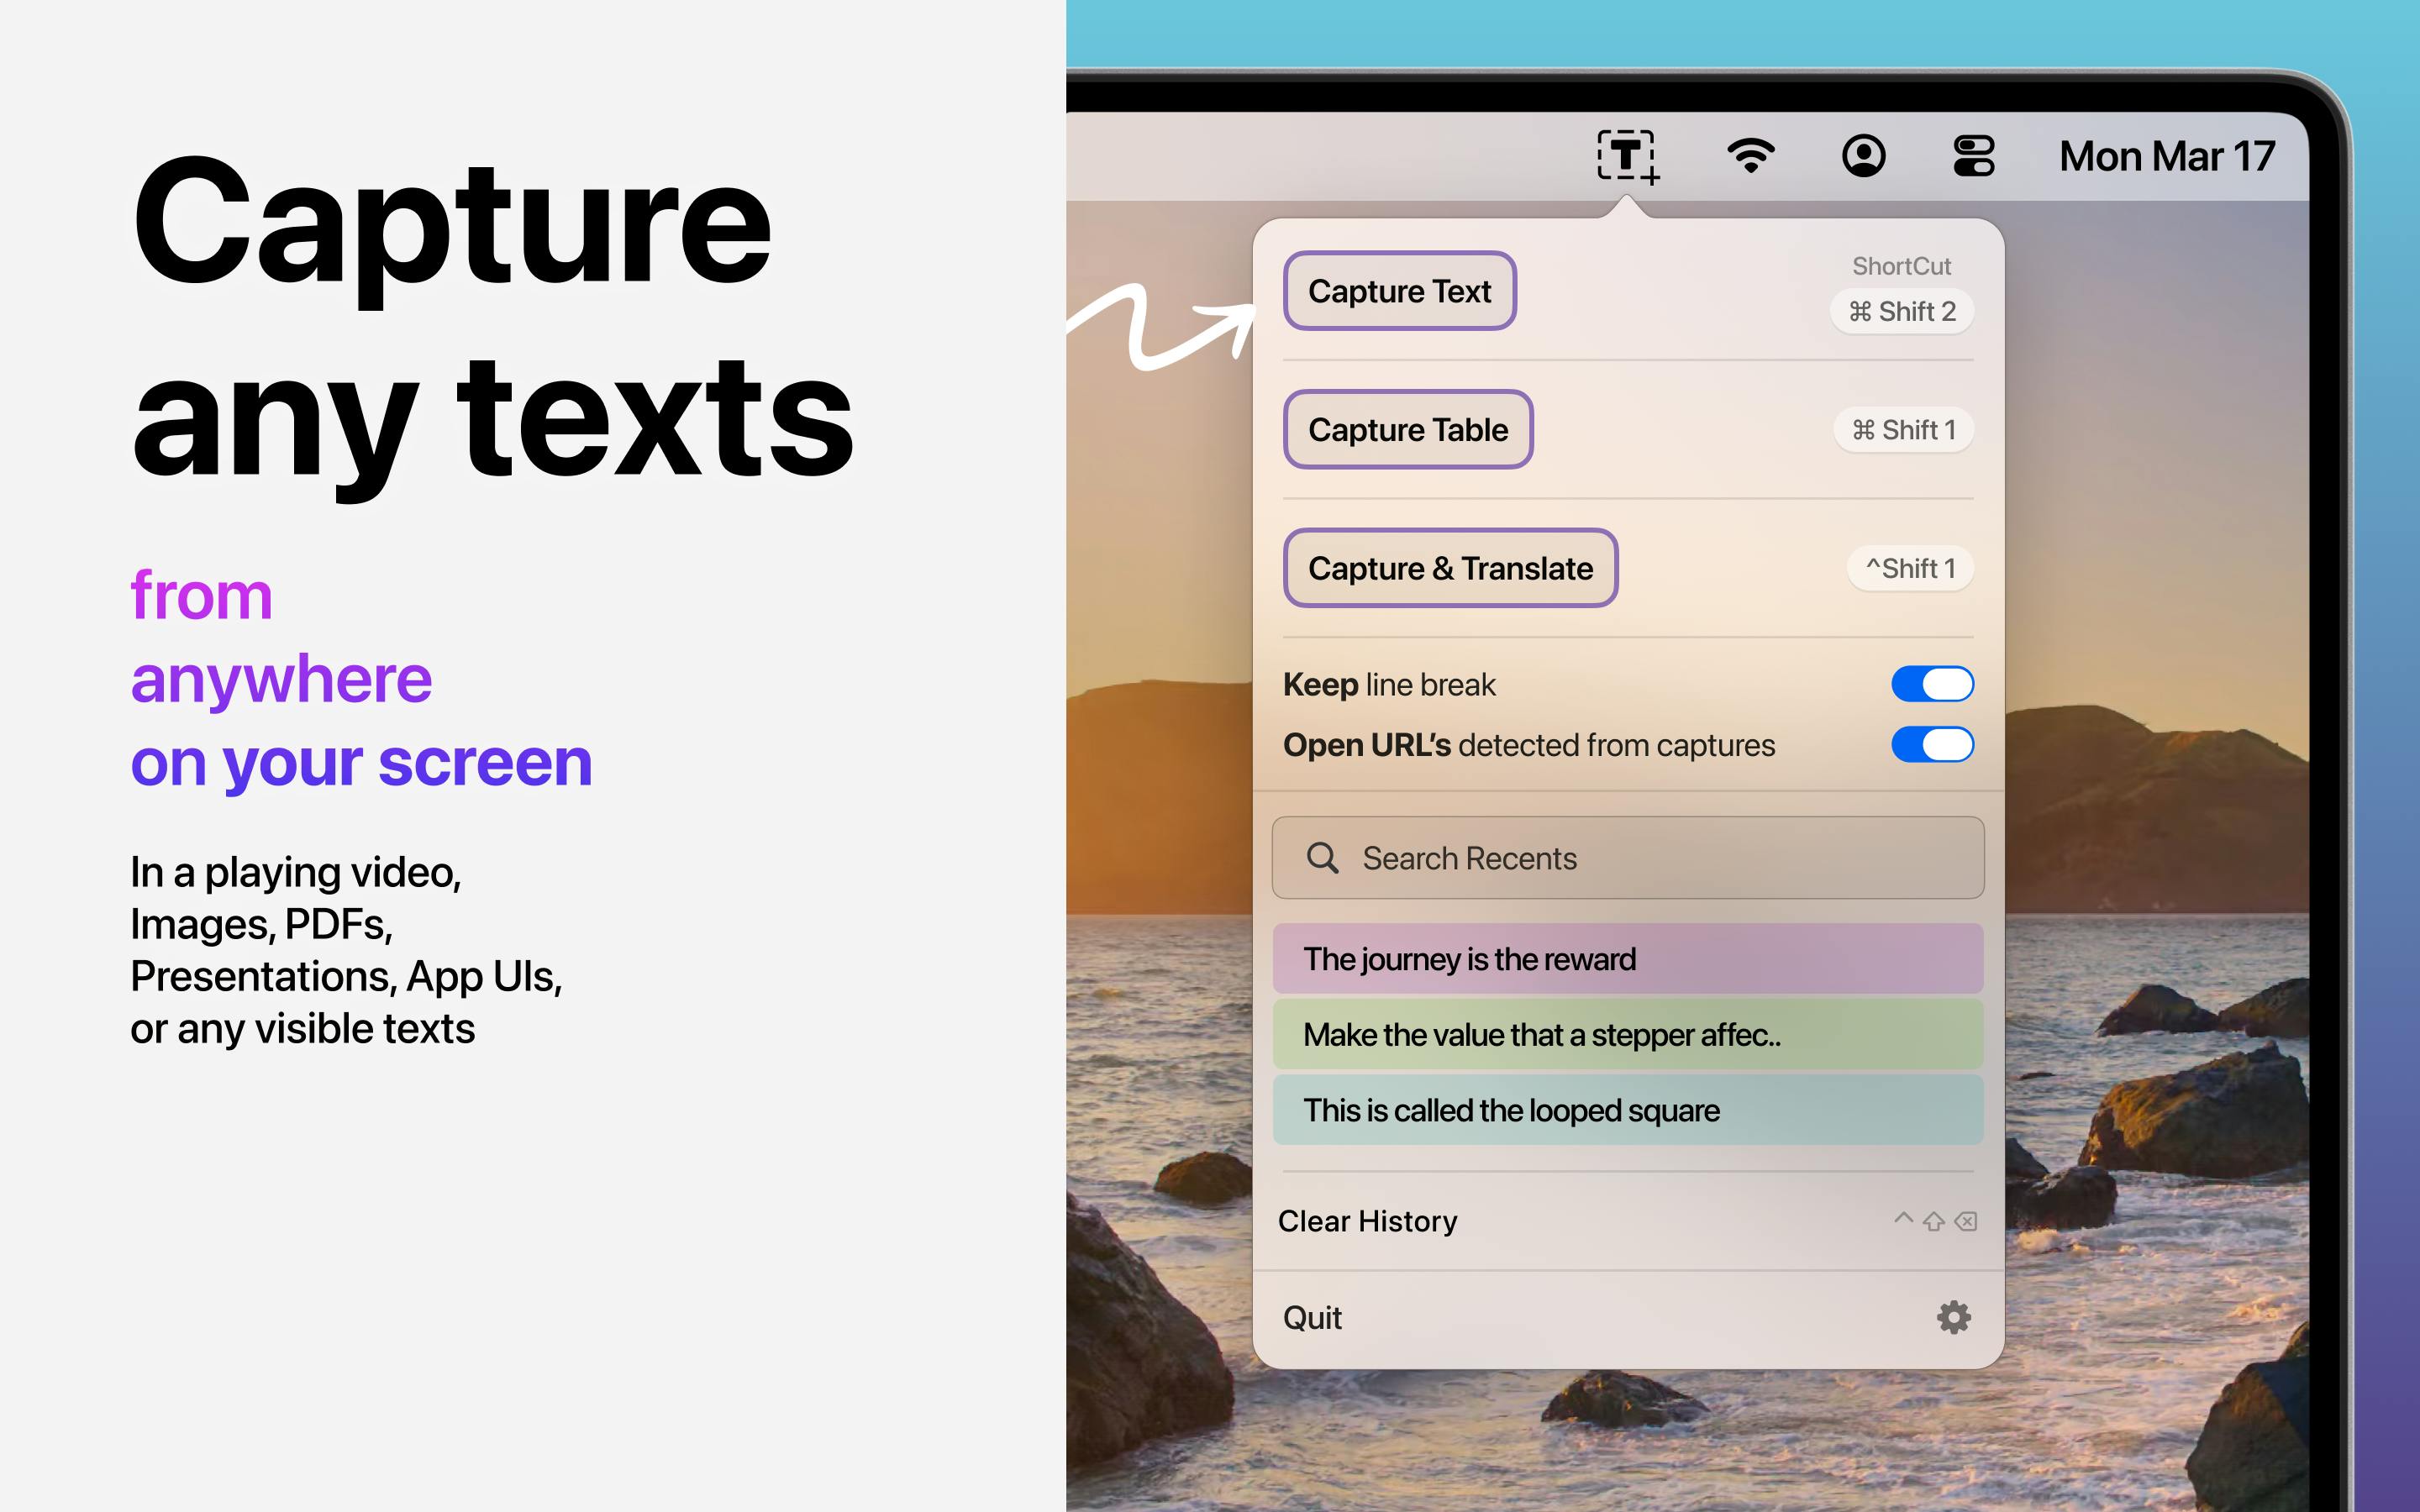
Textly是一款Mac菜单栏效率工具,支持从截图、PDF、视频和应用中框选捕获文字与表格,保持行列完整并导出CSV、Markdown、TSV,还内置即时翻译和剪贴板历史。
 科技前沿
Frameboy:World Labs Atlas 世界模型浏览器实时体验
World Labs 在 Product Hunt 发布 Frameboy,基于 Atlas 世界模型的浏览器实时演示,移动相机即可在云端 GPU 生成新视角,最高 15 fps 串流,探索 AI 生成的可漫游世界。
 科技前沿
Keypause:一键锁定Mac键盘,清洁时不再误触
Keypause是一款Mac菜单栏应用,一键锁定键盘所有按键,方便清洁时避免误触。本文介绍其功能、使用体验、潜在风险及适用场景,帮你判断是否值得尝试。