让LLM智能体不再跑偏:全新Steering Agent监督框架

论文提出Steering Agent,以快慢双路径监督机制应对LLM智能体与多智能体系统中的目标漂移。
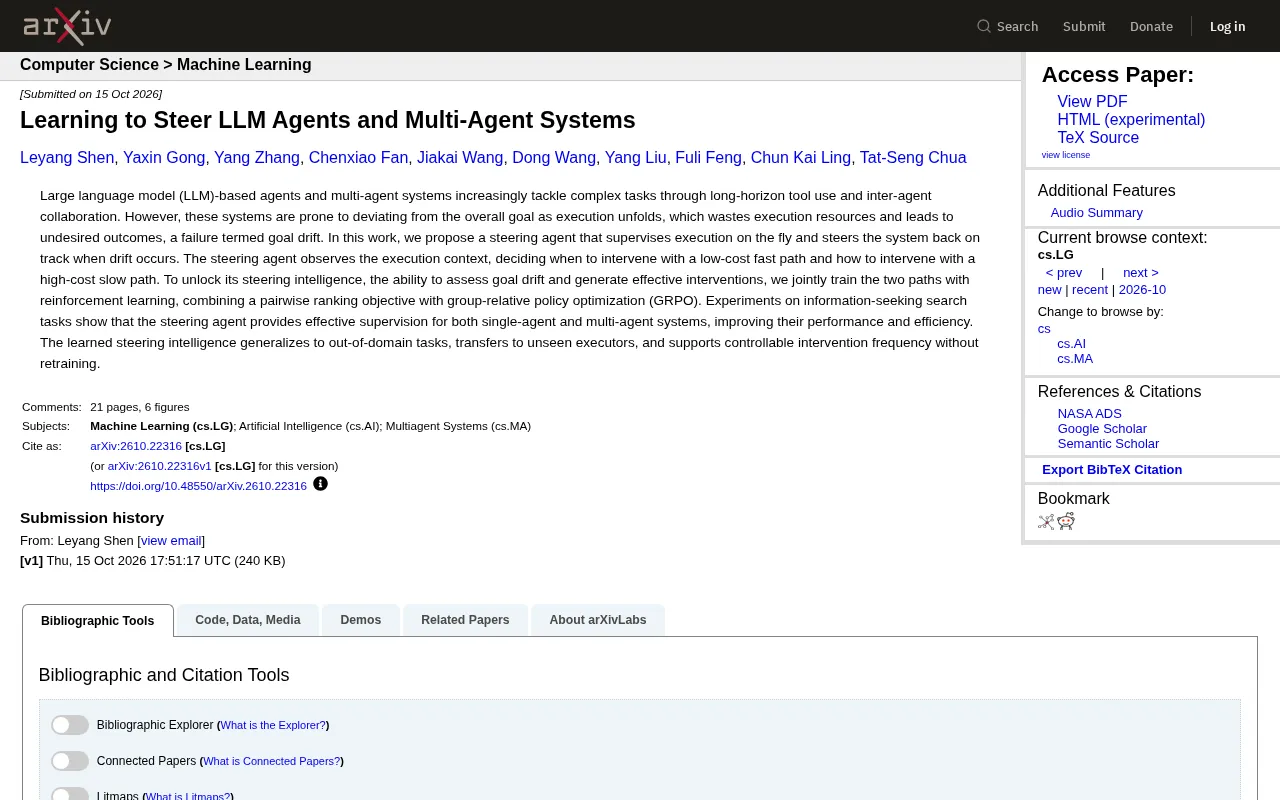
文章介绍了一项针对大语言模型智能体与多智能体系统「目标漂移」问题的研究。目标漂移指智能体在执行长程任务时逐步偏离整体目标的失败模式,在多智能体协作中会因误差传播而更严重。论文提出的Steering Agent采用快慢双路径机制:快路径低成本判断何时干预,慢路径高成本决定如何干预。训练上结合成对排序目标与GRPO强化学习,让监督智能体学会评估漂移并生成有效修正。实验表明,该方案能提升单智能体和多智能体系统的性能与效率,并具备跨任务泛化、跨执行者迁移和可控干预频率等特性。其核心价值在于将监督能力从执行能力中解耦,为多智能体系统提供模块化的旁路监督思路。
多智能体系统的协作能力越强,任务链条越长,一个隐蔽的问题就越容易暴露:执行到中途,整个系统已经悄悄偏离了最初的目标。研究人员将这种现象称为「目标漂移」(Goal Drift),并为此提出了一种新的监督方案——Steering Agent。
什么是目标漂移?为什么它值得关注
基于大语言模型的智能体正在承担越来越复杂的任务,它们可以调用工具、跨越多轮对话、甚至与其他智能体分工协作。但论文指出,随着执行过程展开,这些系统容易偏离整体目标,不仅浪费执行资源,还会导致非预期的结果。
这种偏离并非某一步的明显错误,而是随执行逐步累积的微妙偏移。在长程任务中,早期的一次小偏差可能被后续步骤放大,等到系统「意识到」时,已经消耗了大量算力与调用次数。论文把这定义为一种失败模式:目标漂移。
值得关注的是,漂移问题在单智能体和多智能体系统中都存在,且在多智能体协作场景下可能更严重——因为每个智能体都会基于其他智能体的输出做出决策,误差会在协作链路上传播和放大。
**长程任务(Long-Horizon Tasks)**是理解目标漂移的关键背景。它指需要多轮决策、多次工具调用或长链条推理才能完成的任务,例如多步信息检索、复杂代码生成或跨文档报告撰写。与单步问答不同,长程任务的中间输出会作为后续步骤的输入,因此早期的小偏差不会被自动纠正,而会被后续步骤继承并放大。LLM智能体在每一步都基于当前上下文生成动作,缺乏全局目标的持续对齐机制,因此容易在数十步执行后偏离初衷。目标漂移正是这类任务结构下的典型失败模式。
Steering Agent 的工作机制:快慢双路径
论文提出的核心方案是一个监督式智能体,它实时观察执行上下文,判断是否发生了目标漂移,并决定是否介入把系统拉回正轨。
这个Steering Agent的关键设计在于双路径干预机制:
- 快路径(fast path):低成本判断,决定「何时干预」。它持续监控执行状态,用较低的计算开销快速识别潜在漂移信号。
- 慢路径(slow path):高成本判断,决定「如何干预」。当快路径触发后,慢路径负责生成具体的修正动作或指导信息。
这种分工让系统在大多数时候保持轻量运行,只在真正需要时才调用昂贵的大模型推理。这种设计思路与人类监督者的行为模式有相似之处——日常执行不必事事插手,但发现异常时需要深度介入。
训练方法:强化学习与排序目标联合优化
为了训练出具备「steering intelligence」(即评估目标漂移并生成有效干预的能力)的智能体,论文采用了一种联合训练策略。
两条路径通过强化学习共同训练,目标函数结合了两个部分:成对排序目标(pairwise ranking objective)和组相对策略优化(GRPO)。排序目标帮助模型学会区分「偏离程度」,GRPO则用于优化干预策略本身。这种组合既让智能体学会判断何时该干预,也学会如何干预才有效。
有意思的是,这套训练框架的目标不是让Steering Agent替代原有执行者,而是让它在旁路监督,保持原系统架构不变的前提下提升整体表现。
**GRPO(Group Relative Policy Optimization,组相对策略优化)**是一种用于训练大语言模型策略的强化学习算法。它不依赖独立的价值网络,而是对同一提示采样一组候选输出,用组内相对奖励估计优势,从而降低训练开销并提升稳定性。在Steering Agent的训练中,GRPO用于优化慢路径生成干预动作的策略。**成对排序目标(Pairwise Ranking Objective)**则要求模型对两个候选状态或干预方案进行相对比较,学习判断哪一个更偏离目标、哪一个干预更有效。两者结合,使模型既能区分偏离程度,又能生成高质量干预。
实验结论:单智能体与多智能体系统均受益
论文在信息检索类搜索任务上进行了验证。实验结果显示,Steering Agent能够为单智能体和多智能体系统提供有效监督,同时提升它们的性能与效率。
更值得关注的是泛化能力方面的结果:
- 跨任务泛化:学到的监督能力可以迁移到领域外任务上。
- 跨执行者迁移:监督策略可以迁移到训练时未见过的执行器(unseen executors)上。
- 可控干预频率:无需重新训练即可调整干预频率,这为实际部署提供了灵活性。
这三点共同指向一个实用价值:Steering Agent更像是一种通用的监督能力,而非绑定在特定任务或特定模型上的补丁。
**跨执行者迁移(Cross-Executor Transfer)**指监督模块在一个或多个执行器上训练后,能够泛化到训练时未见过的执行器。这里的执行器可以是不同规模、不同提示模板或不同工具配置的LLM智能体。该能力之所以重要,是因为实际部署中执行器常因成本、版本或任务需求而变化,若监督策略与特定执行器绑定,就难以复用。Steering Agent通过观察执行上下文而非执行器内部参数来判断漂移,因此具备一定的模型无关性,这也是其被视为通用监督能力的重要依据。
对多智能体系统设计的启示
这项工作暴露了一个此前较少被系统化讨论的问题:智能体的执行能力与自我监督能力之间存在落差。当前的LLM智能体擅长执行,但在「判断自己是否还在正轨上」这方面并不擅长,尤其是在长程任务和多智能体协作中。
Steering Agent的思路提供了一种模块化的解法:将监督能力从执行能力中解耦出来,用一个专门的、经过强化学习训练的监督模块来补齐这一短板。对于正在构建多智能体系统的工程团队而言,这种「旁路监督」的架构设计值得参考。
同时,快慢双路径的设计也回应了一个现实约束——监督不能太贵。如果每次干预都调用最大模型反复推理,监督成本可能超过任务本身的收益。这种分级干预的思路,是让监督机制真正可落地的重要一步。
相关推荐

LLaMA-Factory实战:零代码微调大模型全流程
本文介绍LLaMA-Factory开源微调工具,涵盖其60.1K Star项目背景、支持的模型与算法、本地与云服务器部署选择,以及CUDA环境安装步骤,帮助零基础开发者快速上手大模型微调。

曾鸣深度复盘:OpenAI为何难成终局赢家?公司制度将消亡
曾鸣在张晓骏商业访谈录中深度复盘AI终局:模型公司只是基础设施,OpenAI、Anthropic难成最终赢家;下一战役是Agent入口标准之争;公司制度将因AI重构而消亡,只有使命驱动的企业能穿越周期。

OpenHands v1.28.0:OpenCode与PI成内置Agent,密钥可对话申请
OpenHands 21天连推5个版本,v1.27.0将OpenCode与PI写入内置Agent列表,v1.28.0支持对话内申请密钥。本文梳理ACP协议接入方式、凭证复用规则、模型列表变更及升级建议。