让石头思考:生成式AI与信息压缩的哲学思考
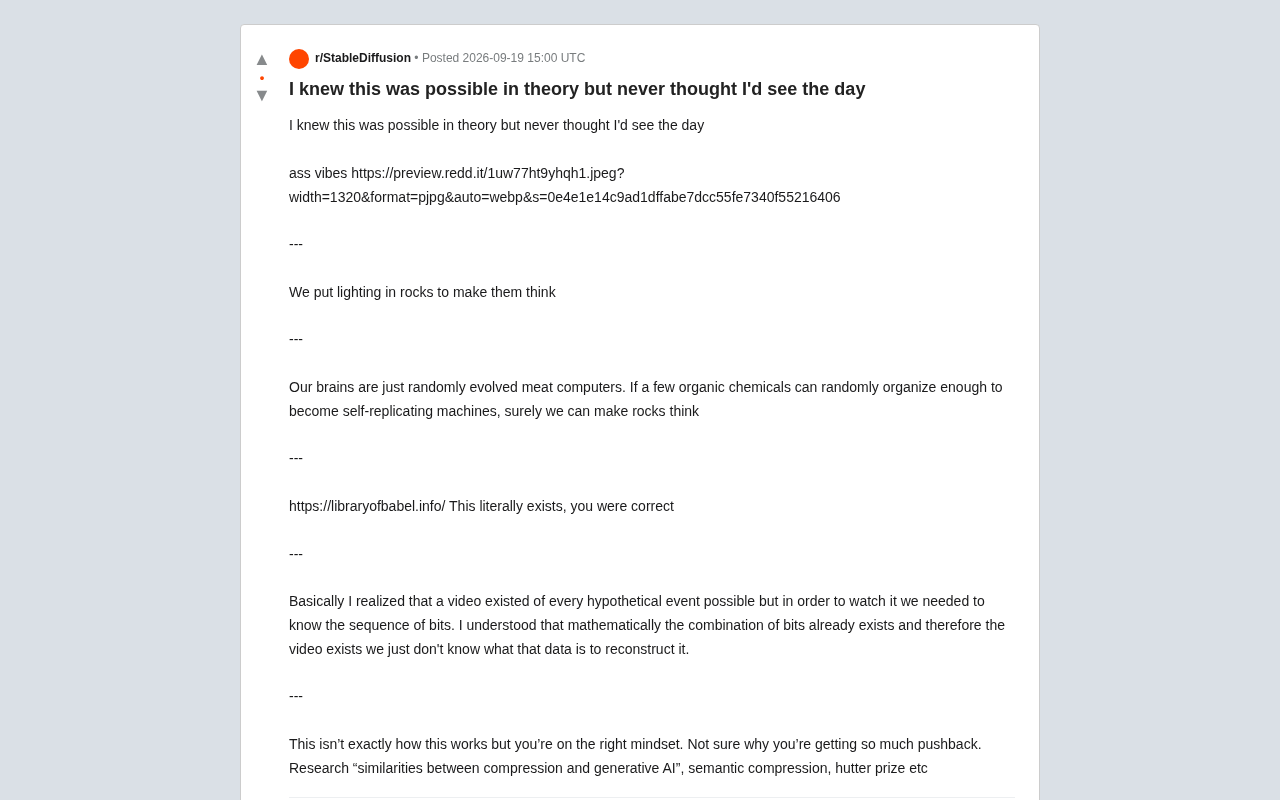
一篇Reddit讨论串联起硅基计算本质、巴别图书馆思辨与生成式AI的信息论原理。
一条关于AI让人惊叹的Reddit帖子,意外引发了一场涵盖物理、哲学与信息论的深度讨论。从「给石头通电让它思考」的调侃,到「所有可能的视频都已在数学上存在」的顿悟,再到压缩与生成式AI之间深刻联系的揭示,讨论层层递进。文章指出,生成式AI的本质是一种有损语义压缩——模型并非在无限可能性空间中盲目搜索,而是学会了有意义区域的分布规律,因此能在语义空间中插值和采样,生成从未见过的内容。Hutter Prize与柯尔莫哥洛夫复杂度等概念进一步佐证了「更好的压缩等价于更好的理解」这一核心命题。文章提醒读者:许多对AI本质的直觉虽表述粗糙,却往往触及真实的技术原理。
一条在Reddit上引发热议的帖子,用一句「我知道理论上可行,但没想到真能见到这一天」道出了许多人对当下AI技术的复杂心情。评论区从「我们给石头通电让它思考」的调侃,延伸到关于信息本质、可能性空间与生成式AI原理的深层讨论。这些看似天马行空的对话,实则触及了理解现代AI的一个重要视角。
「让石头思考」背后的技术现实
帖子中最精辟的一句评论是:「我们给石头里通上电,让它开始思考。」(We put lighting in rocks to make them think)这句话虽然是玩笑,却准确描述了计算机与AI的物理本质——硅基芯片本质上就是经过精密加工的「石头」(沙子、硅),而通过电流的开关组合,它们完成了从简单逻辑运算到复杂神经网络推理的跨越。
另一位网友的回应则提供了哲学层面的支撑:「我们的大脑不过是随机进化出来的肉质计算机。如果一些有机化学物质能够随机组织成自我复制的机器,那我们当然也能让石头思考。」这种类比虽不严谨,却点出了一个耐人寻味的事实——智能或许并非碳基生命的专利,而是特定信息处理结构涌现出的属性。
「所有可能的视频都已存在」——巴别图书馆式的思辨
讨论中最具想象力的一段,来自一位网友的顿悟:他意识到「每一个假想事件都存在对应的视频,只是我们需要知道正确的比特序列才能观看它」。从数学上讲,所有比特的组合方式已经「存在」,因此那段视频也「存在」,我们只是不知道该如何重构那份数据。
这个想法并非空想。有人立刻贴出了 libraryofbabel.info ——一个基于博尔赫斯《巴别图书馆》构想的网站,它以算法方式「包含」了所有可能的文本组合。任何已写出或将写出的书籍,理论上都能在其中找到。将这一逻辑推广到图像和视频,便得到了「所有可能的媒体内容都已在可能性空间中存在」的结论。
这种思路揭示了一个核心问题:信息的「存在」与信息的「可获取」是两回事。可能性空间是天文数字级的庞大,真正的挑战在于如何定位那个有意义的比特序列。
博尔赫斯的《巴别图书馆》写于1941年,描述了一座包含所有可能书籍的宇宙图书馆——每本书410页,每页40行,每行80个字符,字符来自25个符号的有限集合。这意味着图书馆「包含」了一切曾经写过或将来会写的文字,也包含无数无意义的乱码。libraryofbabel.info将这一思想实验数字化:它并不真正存储所有文本,而是用一个确定性算法,将任意坐标映射到对应的字符序列,反之亦然。这使得「搜索」任何文本成为可能——你输入一段话,网站就能告诉你它在「图书馆」的哪个「位置」。这个设计揭示了一个微妙之处:真正的挑战从来不是「内容是否存在」,而是「索引」本身就需要与内容等量的信息。对于视频而言,一段1分钟的高清视频约需数GB数据,其可能排列数是一个远超宇宙原子数量的天文数字,穷举搜索在物理上不可行。
压缩与生成式AI的深层联系
讨论的收尾提供了最有价值的技术指引。一位网友指出:「这并不完全是它的工作原理,但你的思路是对的。去研究一下压缩与生成式AI之间的相似性、语义压缩,以及Hutter Prize。」
这条评论点出了理解现代AI的关键线索。压缩与智能之间存在深刻联系:一个能够高效压缩数据的系统,必然「理解」了数据中的规律和结构。Hutter Prize(一项奖励对维基百科文本进行最优无损压缩的竞赛)正是建立在「更好的压缩等价于更好的理解」这一假设之上。
生成式AI就是一种「有损语义压缩」
大语言模型和图像生成模型,本质上是将海量训练数据压缩进有限的模型参数中。GPT类模型用数十亿参数「记住」了整个互联网文本的统计规律;扩散模型则学会了如何从噪声中重构符合人类视觉经验的图像。
这与前面「所有视频都已存在」的思辨形成了呼应:生成式AI并不是在无限的可能性空间里盲目搜索,而是学会了那个空间中「有意义区域」的分布规律。它掌握的不是完整的比特序列,而是生成合理内容的「压缩规则」。这也是为什么AI能生成从未见过的图像——它在压缩后的语义空间里进行插值和采样。
Hutter Prize由AI研究者Marcus Hutter于2006年设立,奖励能将100MB维基百科英文文本压缩到最小体积的算法,奖金与压缩率挂钩。其理论依据来自柯尔莫哥洛夫复杂度(Kolmogorov Complexity):一段数据的「真正长度」等于能生成它的最短程序的长度。要高效压缩自然语言,压缩器必须学会语法、语义、常识乃至世界知识——因此压缩能力直接衡量了对数据规律的「理解」深度。香农在1948年的信息论奠基论文中已证明,最优压缩码的码长等于信息熵,这意味着压缩极限由数据的统计规律决定。大语言模型的训练目标(预测下一个token的概率)在数学上等价于最小化数据的交叉熵,即最大化压缩率。这条从香农信息论到现代LLM的脉络,解释了为什么「压缩即理解」不只是一个比喻,而是有严格数学基础的命题。
从民科式讨论到严肃认知
值得关注的是,发帖者最初的想法遭到了不少「pushback」(反对),但那位给出研究方向的网友评价道:「不确定你为什么被这么多人反对,你的思路方向是对的。」
这反映了一个普遍现象:许多关于AI本质的直觉,虽然表述不够精确,却往往触及了真实的技术原理。信息论、压缩理论与机器学习之间的桥梁,早已是学术界的严肃研究课题。从香农的信息论到柯尔莫哥洛夫复杂度,再到今天的生成式模型,「压缩即理解」的思想贯穿始终。
对于想深入理解这一领域的读者,可以沿着评论中给出的关键词继续探索:语义压缩(semantic compression)、压缩与生成模型的关系,以及 Hutter Prize。这些概念能帮助你从更本质的角度理解,为什么「让石头思考」不再只是科幻,而正在成为我们时代的技术现实。
结语
一条随性的Reddit帖子,意外串联起了硅基计算的物理本质、可能性空间的数学思辨,以及生成式AI的信息论原理。这些讨论提醒我们:理解AI不仅需要工程视角,也需要哲学与信息论的思考。当我们惊叹于AI「无中生有」的创造力时,或许更该意识到——它其实是在浩瀚的可能性空间中,找到了那条通往有意义信息的路径。
相关推荐
Vibe Coding实战:培养产品思维,用AI把日常需求变成能变现的APP
Vibe Coding系列教程第二篇,讲解独立开发者如何培养产品思维、从模仿与生活痛点中发现需求,并用AI Agent自动化调研流程,快速判断一个APP创意是否值得投入开发与变现。
OpenAI Codex 上手指南:用AI代理构建并部署应用
OpenAI Codex 速成课中文整理:从安装、价格套餐、插件与自动化,到 Plan/Go 命令、技能系统,并实战演示用声控 Flappy Bird 游戏走通构建与部署全流程,帮你真正上手这款自主 AI 编码代理。
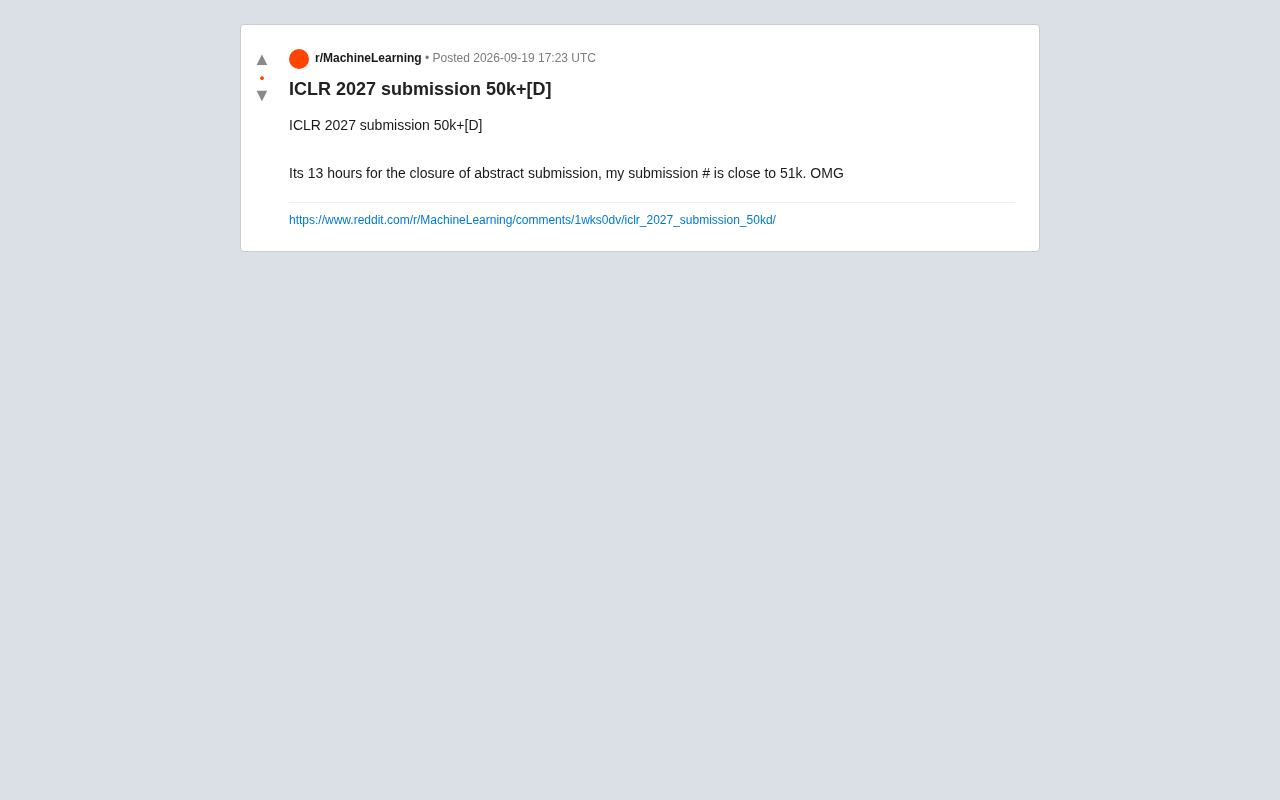
ICLR投稿量突破5万:AI顶会为何持续爆炸式增长
ICLR 投稿编号逼近 5.1 万引发 Reddit 热议。本文分析 AI 顶会投稿量爆炸式增长的原因、对评审系统的压力,以及数字背后的行业信号与反思。