Re-Search:用20问游戏拆解LLM的科研创意瓶颈
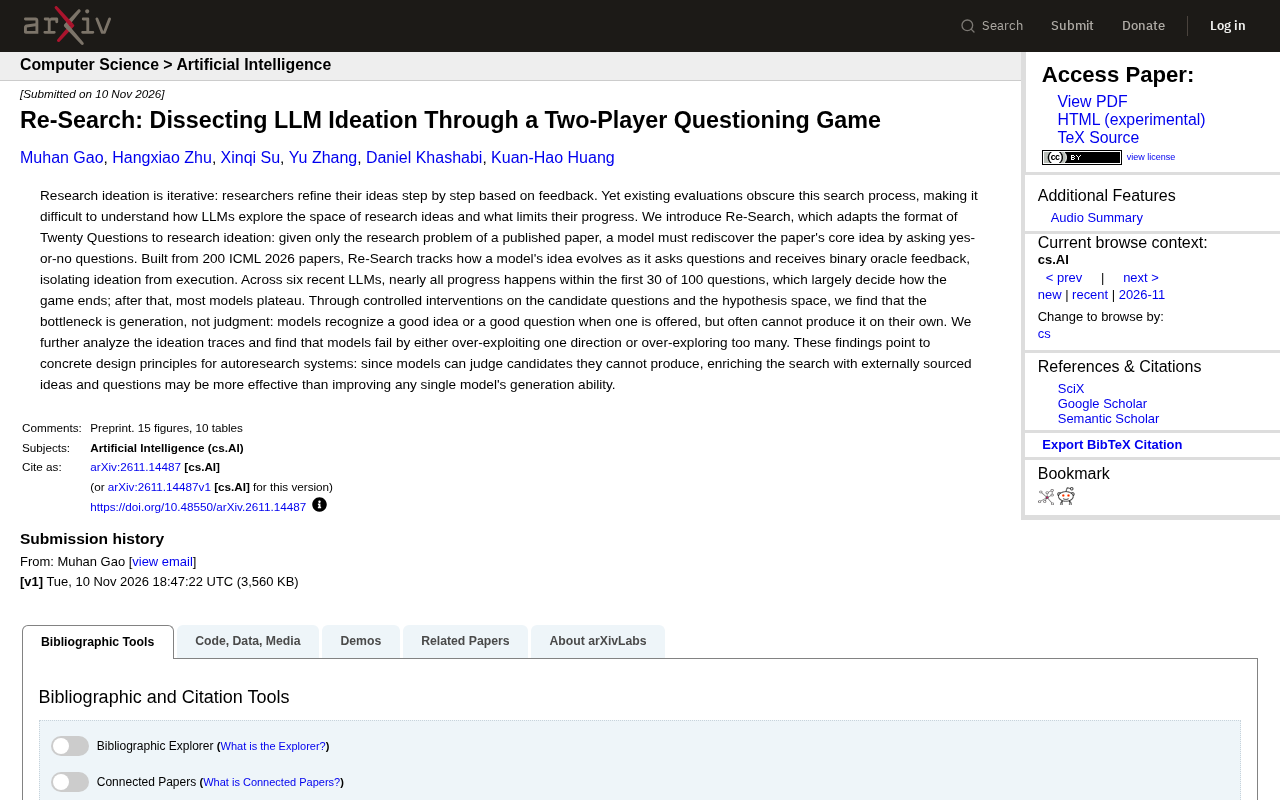
Re-Search用二十问游戏发现LLM创意瓶颈在生成而非判断,且进展集中在前30问。
Re-Search研究将科研创意过程设计成“二十问”游戏,让LLM仅通过是/否问答重新发现论文核心想法,从而隔离创意生成与实验执行。基于200篇ICML 2026论文的评测显示,六个LLM的进展几乎都集中在前30个问题内,之后进入平台期。控制实验表明,模型能识别好想法和好问题(判断能力),但无法自己生成它们(生成能力),瓶颈在于生成而非判断。失败模式分为过度开发单一方向和过度探索过多方向两类。研究建议自动科研系统应优先丰富外部想法和问题的搜索空间,而非单纯提升模型生成能力。
为什么LLM能判断好想法,却想不出好想法?
科研创意的形成从来不是一蹴而就的。研究者基于反馈一步步打磨想法,但现有评测往往只看最终产出,把中间的探索过程完全掩盖了。我们很难知道:LLM在探索研究想法时到底走了哪些弯路?是什么限制了它提出真正有价值的问题?
最近一篇题为《Re-Search: Dissecting LLM Ideation Through a Two-Player Questioning Game》的研究,用一种巧妙的游戏化设计回答了这个问题。它把科研创意过程改造成“二十问”游戏,让模型在纯问答互动中重新发现论文的核心思想,从而把“创意生成”和“实验执行”彻底隔离开来。
把科研创意变成一场“二十问”游戏
Re-Search的设计思路很直接:给定一篇已发表论文的研究问题,模型只能通过提出“是/否”问题来获取二元反馈,目标是逐步逼近论文的核心想法。整个过程不涉及任何代码执行或实验操作,纯粹考验模型在假设空间中的搜索能力。
研究团队从200篇ICML 2026论文构建了这套评测。模型每问一个问题,就收到一次“是”或“否”的反馈,其猜想随问答轮次逐步演化。这种设计把创意生成拆解成可追踪的轨迹,让研究者能精确观察模型如何调整假设、在哪里卡住。
“二十问”游戏(20 Questions)是一种经典的猜谜游戏:一方心中想好一个对象(如动物、物品),另一方通过提出最多20个只能回答“是”或“否”的问题来逐步缩小范围,最终猜出答案。这个游戏常被用作信息检索与假设检验的抽象模型,因为它要求提问者在有限的二元反馈下高效地搜索巨大的假设空间。在人工智能领域,二十问游戏被用来评估智能体的主动探索、信息增益最大化和推理能力。Re-Search借用这一框架,将“猜对象”替换为“猜论文核心想法”,使LLM的创意过程变得可观测、可量化。
前30个问题决定成败,之后多数模型停滞
对六个近期LLM的测试揭示了一个规律:几乎所有的进展都集中在前30个问题内(总共有100个问题)。换句话说,前30%的问答轮次基本决定了游戏的最终结局,此后大多数模型进入平台期,不再产生实质性推进。
这个发现本身就有实践含义。如果模型在早期问答中没有找到正确方向,后续再多轮次也难以补救。创意的“搜索窗口”比想象中更窄,早期问题的质量远比数量重要。
瓶颈在生成,不在判断
研究通过控制候选问题和假设空间的干预实验,得出了一个反直觉的结论:模型的瓶颈是生成能力,而非判断能力。当提供一个好的想法或好的问题时,模型能够识别它的价值;但让模型自己从零产出这些想法或问题时,它往往做不到。
这个区分很关键。它意味着单纯提升某个模型的生成能力,可能不如在搜索过程中引入外部来源的想法和问题更有效。模型缺的不是“鉴赏力”,而是“生产力”。
在机器学习和认知科学中,“生成”与“判断”常被区分为两种不同的能力。生成(generation)指从零开始产生新颖且有用的内容,如提出假设、设计问题或创作文本;判断(judgment)指对已有候选进行评估、打分或选择,如识别哪个想法更有价值。两者在计算复杂度上并不对称:生成通常需要在巨大的组合空间中搜索,而判断只需对给定选项进行比较。LLM在判断任务上表现优异,部分原因在于预训练目标(如下一词预测)和人类反馈强化学习(RLHF)更侧重于评估与排序能力,而非从零构建。因此,Re-Search发现的“判断强于生成”现象,与当前LLM的训练范式一致,也解释了为何引入外部候选池能有效弥补生成短板。
两种失败模式:过度开发与过度探索
对创意轨迹的进一步分析发现了模型的两类典型失败:一类模型过度利用某一个方向,在一条路径上反复深挖却跳不出来;另一类则过度探索太多方向,在每个方向上都浅尝辄止,无法收敛。
这和强化学习中的探索-利用困境如出一辙。好的科研创意需要在两者之间找到平衡,而当前模型似乎缺乏这种动态调节能力。
探索-利用困境(exploration-exploitation dilemma)是强化学习和决策理论中的核心问题:智能体需要在“利用”当前已知最优选项以获取确定收益,与“探索”未知选项以发现可能更优解之间做出权衡。过度开发会导致陷入局部最优,错失更好的全局解;过度探索则会导致资源分散、无法收敛。在科研创意场景中,这一困境表现为:过度开发的模型反复深挖同一方向,无法跳出思维定势;过度探索的模型则不断切换方向,缺乏深度积累。理想策略需要根据反馈动态调整探索率,例如采用乐观初始值、汤普森采样或熵正则化等方法。当前LLM缺乏这种动态调节机制,往往表现出极端的探索或利用倾向。
对自动科研系统的设计启示
Re-Search的结论指向一条具体的设计原则:既然模型能判断它无法生成的东西,那么丰富搜索空间——从外部引入想法和问题——可能比改进单一模型的生成能力更有效。这对自动科研(autoresearch)系统的构建有直接参考价值:与其追求一个更强的生成器,不如设计一个更好的候选池和筛选机制。
把创意过程拆解成可追踪的问答轨迹,也让评测从“看结果”转向“看过程”。这种视角或许比任何单项指标都更能揭示LLM在科研创意上的真实短板。
相关推荐
美国新车均价突破5.1万美元:AI与软件定义汽车如何推高成本
美国新车平均价格突破5.1万美元创历史新高。本文从软件定义汽车、中央计算架构、辅助驾驶传感器预埋与车端AI推理成本角度,分析AI与软件如何推高整车售价,以及这一趋势对消费者和厂商的影响。
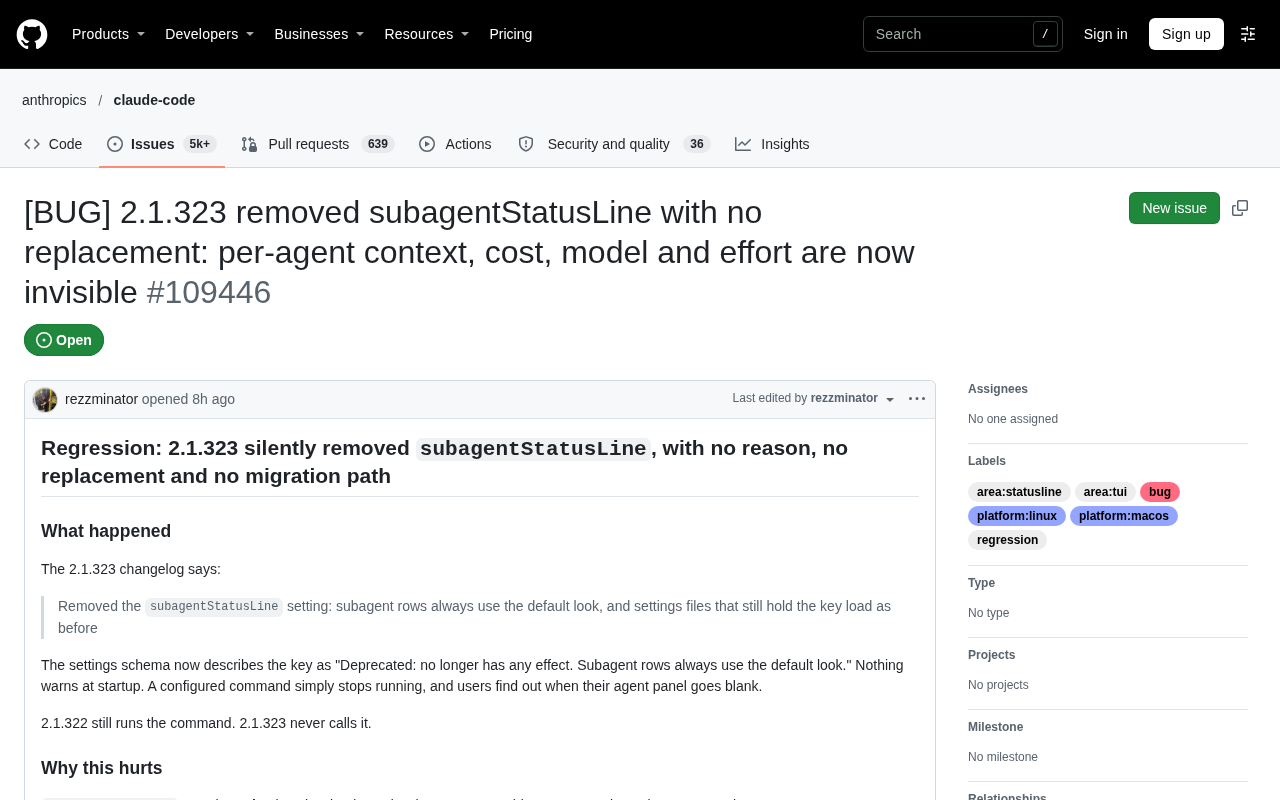
Anthropic无预警移除Claude Code功能,开发者社区不满
Anthropic无预警移除Claude Code功能引发开发者不满。本文分析事件经过、开发者敏感原因及对AI编程工具生态的启示,探讨厂商如何平衡迭代与用户信任。
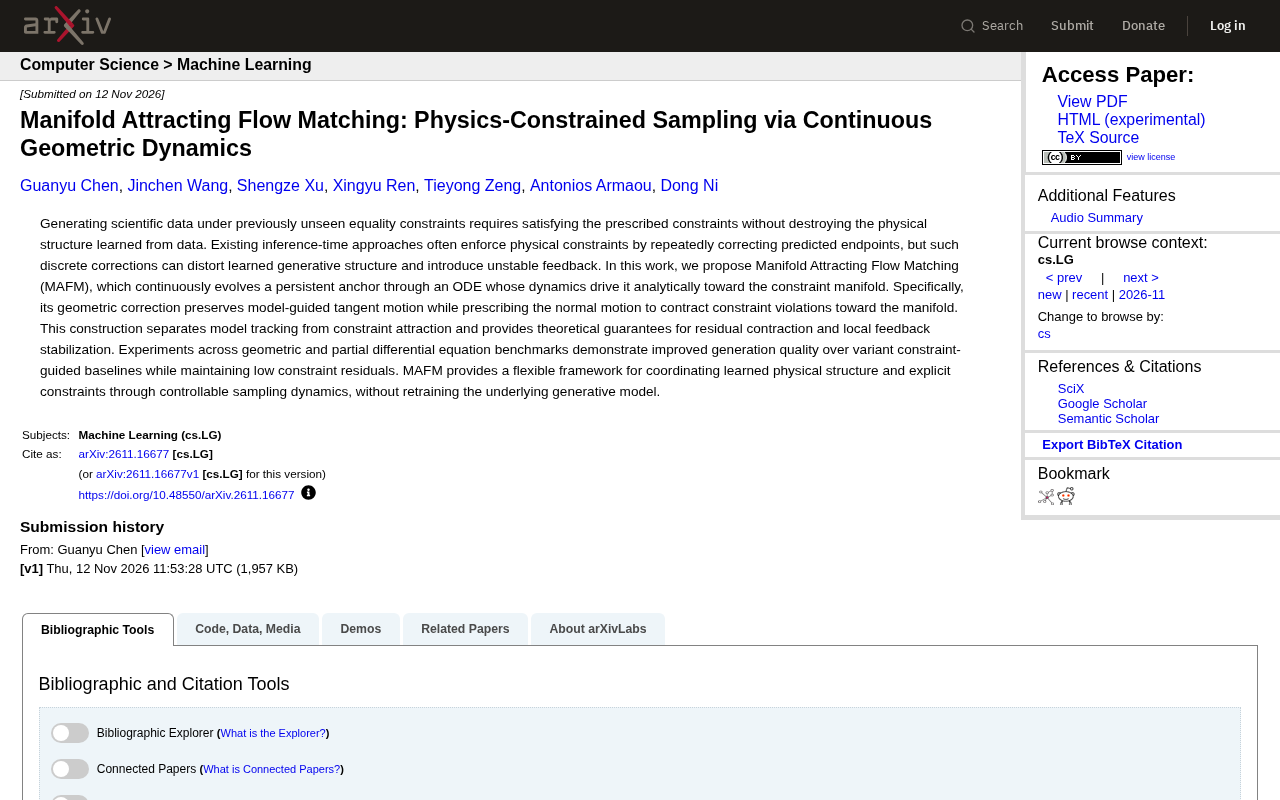
MAFM:流匹配生成中的物理约束新解法
MAFM提出用连续几何动力学替代离散校正,在流匹配生成中实现物理约束满足。本文解析其切向/法向运动解耦机制、理论保证与实验表现,并讨论局限与展望。