REA一天登顶GitHub:让AI逆向任意软件的开源利器

REA 是将软件逆向工程工具链接入 AI 编程助手的开源项目,让 AI 具备「读懂现成软件内部实现」的能力。
REA 是一个迅速登顶 GitHub 的开源项目,它将传统逆向工程工具链封装为 AI 可调用的接口,让 Claude Code、Codex、Cursor 等编程助手能够直接分析编译后的二进制软件。用户只需告知 AI 想研究的功能,AI 便能追踪调用链、梳理数据流,并以「已确认/待验证」的分层方式输出分析结论,有效降低误判风险。更重要的是,REA 打通了从逆向分析到代码落地的闭环——开发者可以直接以分析结果为参照,在自己的项目中实现类似功能。不过,逆向他人软件涉及版权与许可协议风险,工具本身的技术能力与合规使用之间的边界,仍需开发者自行把握。
一个名为 REA 的开源逆向工程项目最近在 GitHub 上快速走红,热度甚至超过了此前备受关注的 Jev。据 B 站 UP 主的介绍,REA 的核心卖点在于:它把传统上门槛极高的软件逆向分析,变成了 AI 可以直接调用的工具链,让 Claude Code、Codex、Cursor 等编程助手具备了「看懂别人软件内部实现」的能力。
REA 到底在做什么
REA 的定位是一套能被 AI 调用的逆向分析工具集。你可以用它来逆向几乎任意形态的软件——UP 主举的例子包括一款 Cellworld 的 PPT 软件、macOS 系统组件,甚至是《侠盗列车手》这样的游戏。换句话说,无论目标是桌面应用、操作系统还是大型游戏,理论上都能尝试用 REA 拆解出一个属于自己的分析版本。
它的关键之处不是让 AI 单纯「写代码」,而是让 AI 拥有了「研究现成软件」的手段。过去 AI 编程助手只能依据你的文字描述去生成功能,而现在它可以顺着真实程序的内部逻辑去反查实现细节,再把结论反馈到你自己的项目里。
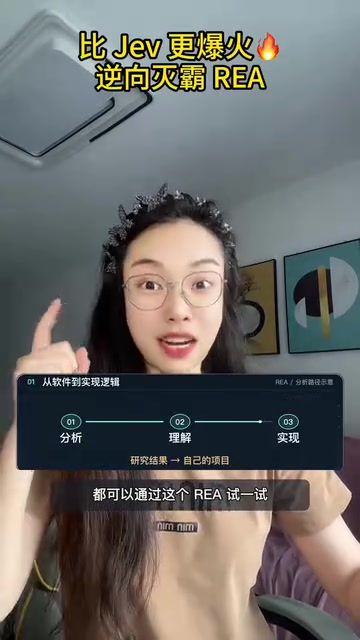
逆向工程(Reverse Engineering)本质上是在没有源代码的情况下,通过分析编译后的二进制文件来还原程序逻辑。传统工具链包括反汇编器(如 IDA Pro、Ghidra)和反编译器(如 Binary Ninja),它们能将机器码转换为接近可读的汇编或伪代码,但读懂这些输出需要深厚的汇编语言基础和大量经验积累。REA 的创新在于将这些工具封装成 AI 可以调用的结构化接口——AI 不再需要人工翻译那些晦涩的反汇编结果,而是通过工具调用直接获取函数签名、调用关系、数据结构等高层信息。这使得原本需要资深安全研究员才能完成的分析工作,在 AI 的协助下变得更加平易近人。
AI 如何接管逆向流程
整个工作流被设计得相当直白。你把 REA 接到 Claude Code、Codex 或 Cursor 上之后,AI 就能调用这些逆向分析工具去查看程序内部的实现逻辑。当你在某个应用里看中了一个感兴趣的功能,只需要告诉 AI 你想研究哪一部分,它就会顺着相关代码往下追查。
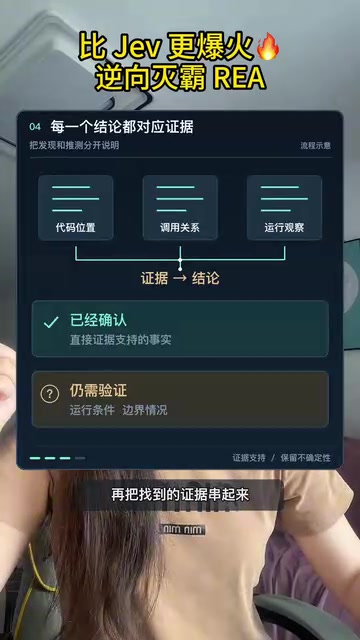
具体而言,AI 会梳理这个功能从哪里开始被调用、调用了哪些数据、数据又是如何被处理的,然后把找到的线索串联成一条完整的证据链。更重要的是,它会区分哪些结论已经确认、哪些还需要进一步验证——这种「有据可查、留有余地」的表达方式,比起 AI 凭空臆测要可靠得多。
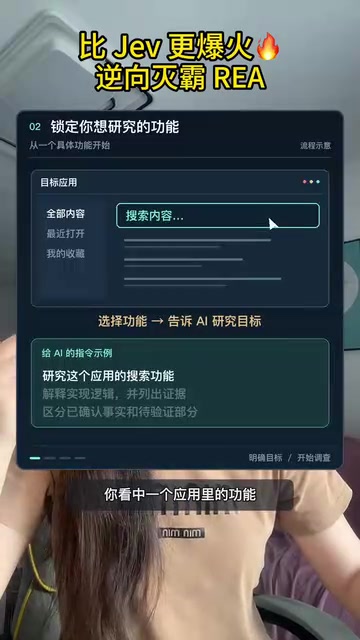
这种分层论证的能力对实际使用价值很大。逆向工程最大的风险就是误判,AI 如果把猜测当成事实输出,很容易把开发者带偏。REA 的流程强调把「已确认」和「待验证」分开陈述,相当于给结论标注了可信度。
从「看懂」到「能用」的闭环
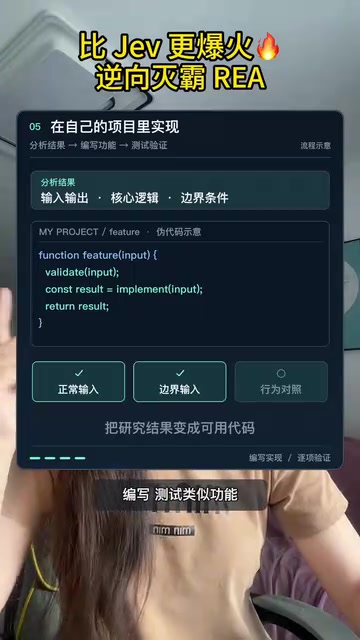
REA 真正打动独立开发者的地方,在于它打通了从分析到落地的最后一步。看懂一个功能的实现逻辑之后,你还能让 AI 根据分析结果,在自己的项目里编写出类似功能,把纯粹的研究结果直接转化成能跑起来的代码。
这意味着做产品的思路可能发生变化。以往你看到一个喜欢的功能,能做的只是向 AI 描述「我想要什么」,然后期待它生成接近的实现。有了 REA,你可以更进一步,让 AI 去研究这个功能「究竟是怎么实现的」,再以此为参照来构建自己的版本。对于缺乏底层逆向经验的独立开发者来说,这无疑降低了技术探索的门槛。
热度背后的冷思考
REA 一天登顶 GitHub,说明「AI + 逆向工程」这个组合确实击中了开发者的痛点。随着 Claude Code、Codex、Cursor 等工具普及,开发者越来越习惯让 AI 承担调研和编码工作,而 REA 恰好把 AI 的能力边界从「生成」扩展到了「理解既有系统」。
不过使用这类工具时也需要保持清醒。逆向他人软件涉及版权、许可协议乃至法律风险,用于学习研究和用于照搬商业功能是完全不同的两件事。REA 提供的是技术能力,如何合规地使用它则取决于开发者自己。对于想尝试 AI 做应用的朋友,这是一个值得关注、也值得谨慎对待的新工具。
在法律层面,逆向工程的合规边界因地区和使用目的不同而存在显著差异。在美国,《数字千年版权法》(DMCA)第 1201 条原则上禁止规避技术保护措施,但为实现软件互操作性而进行的逆向工程通常受到豁免。欧盟《软件指令》第 6 条也明确允许为互操作目的进行逆向。中国《著作权法》同样区分了「合理使用」与侵权行为。实践中,大多数商业软件的最终用户许可协议(EULA)会明确禁止逆向行为,即便法律层面存在豁免空间,违反 EULA 仍可能带来民事风险。将逆向所得直接用于竞品开发与纯粹的学习研究,在法律评价上有本质区别,使用者应在使用前仔细评估目标软件的许可条款。
相关推荐
WorkBuddy智能体实战:从AI问答到自动办公的跨越
WorkBuddy是腾讯推出的AI智能体桌面工作台,能读取本地文件、操作办公软件、执行多步骤任务并定时自动运行。本文详解其核心功能、与传统AI工具的本质区别及适用场景。
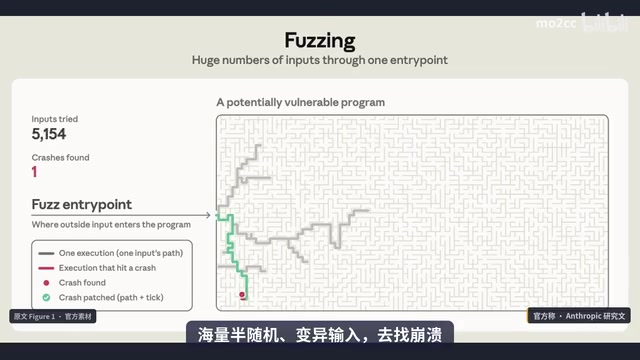
Anthropic研究:LLM让形式化软件验证规模化成为可能
Anthropic Frontier Red Team研究显示,LLM已能在上百个真实开源库的RISC-V汇编级别批量生成形式化证明,覆盖123个OSS-Fuzz库、239个入口点,合计约1.8亿行Rocq证明,并在过程中发现数百量级Bug。文章解析其规格生成、证明流水线、信任边界与成本下降路径。
提示词工程入门:从写提示词到构建AI协作能力
从提示词的四大作用到提示词工程的六步流程,系统梳理AI提示词工程的核心概念、商业价值与三层局限性,帮助初学者建立对提示词工程的完整认知框架。