Reckon:用决策日志校准判断力的iOS量化自我工具

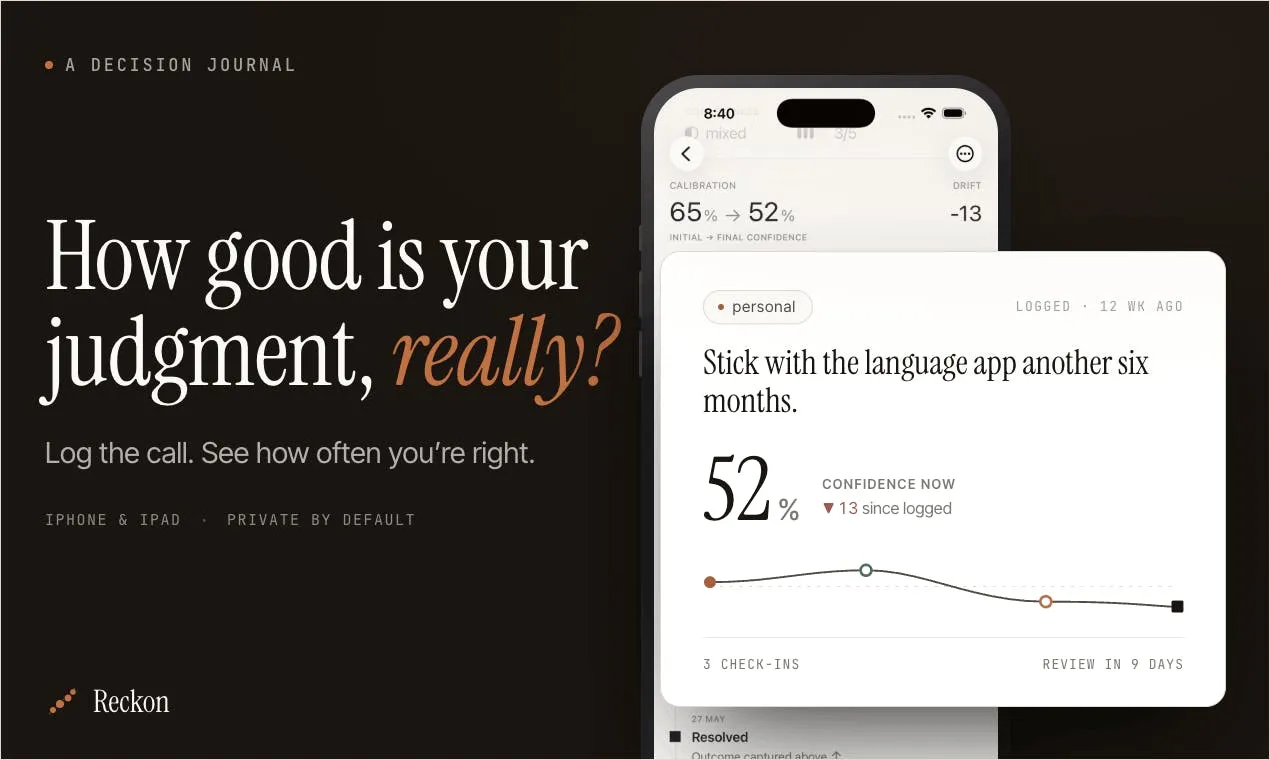
决策的诡异之处在于,它在做出的那一刻就仿佛尘埃落定。我们很少回头审视当初的预测是否准确、信心是否过高,因为事后诸葛的记忆总会悄悄改写一切。近期在 Product Hunt 上线的 iOS 应用 Reckon,试图解决的正是这个盲区——它是一款专注于"校准"(calibrate)的决策日志工具,当前以 82 票、排名 #11 的成绩进入 iOS、生产力与量化自我三个分类。
为什么我们需要一本决策日志
人类的判断有一个系统性缺陷:后见之明偏差(hindsight bias)。当结果揭晓后,我们会不自觉地重构记忆,觉得"我早就知道会这样"。这种自我安慰让我们几乎无法从过去的决策中真正学习,因为我们记住的不是当初的真实想法,而是被结果污染过的版本。
后见之明偏差是认知心理学中研究最为深入的系统性偏差之一,最早由心理学家 Baruch Fischhoff 在 1975 年通过一系列实验正式确立。这种偏差的运作机制涉及记忆重构:当我们得知结果后,大脑会自动将结果信息整合进原有的知识结构中,使得与结果一致的线索变得更加突出,而与结果矛盾的信息则被压制。后续研究进一步将后见之明偏差细分为三种亚型:记忆扭曲(misremembering earlier opinions),即对自己先前判断的记忆发生系统性偏移;必然性错觉(inevitability),即认为已发生的结果是不可避免的;以及可预见性错觉(foreseeability),即相信自己本可以预见结果。这三种亚型在不同情境中的激活程度各异,但共同作用的结果是让人几乎不可能通过纯粹的回忆来客观评估自己的历史判断。在高风险领域,这种偏差的后果尤为严重——医疗误诊的事后审查中,知道最终诊断结果的评审者会系统性地高估误诊的"可避免性";在司法领域,陪审员在知道事故结果后会显著提高对被告"本应预见风险"的判断概率。诺贝尔经济学奖得主 Daniel Kahneman 在《思考,快与慢》中将其称为"理解过去的幻觉",并指出它不仅影响个人决策,还深刻地扭曲了组织中的绩效评估和责任追究。正因如此,仅靠"事后反思"来提升判断力几乎是徒劳的——你需要的是在事前就锁定证据。
Reckon 的产品逻辑正是建立在对抗这一偏差之上。它的核心主张很直接:保留那些被后见之明抹掉的东西——预测本身、当时的信心程度、以及背后的推理过程。这三样东西一旦被固定下来,就成了日后无法抵赖的"证据",让你能诚实地面对自己的判断质量。
从预测到复盘:Reckon 的完整决策记录闭环
这款应用最有价值的地方,在于它设计了一条覆盖决策全生命周期的记录链条,而不只是简单地"记下决定"。
决策时:锁定预测与信心水平
在做决策的当下,你需要写下你的预测、给出一个信心水平,并记录推理逻辑。这一步是整个系统的地基。信心水平的量化尤其关键——它让"我觉得这事八成能成"这类模糊表述变成了可被检验的数字。
这种将主观信心转化为数字的做法,在预测科学中有一个标准的评估框架。衡量预测校准度最经典的指标是 Brier 分数(Brier Score),由气象学家 Glenn Brier 于 1950 年提出,其计算方式是预测概率与实际结果(0 或 1)之差的平方的均值。Brier 分数的取值范围为 0 到 1,越接近 0 表示预测越精准。更直观的评估方式是绘制校准曲线(reliability diagram):将所有预测按信心水平分组(如 60%-70%、70%-80% 等),然后统计每组的实际命中率,如果你的校准是完美的,这些点会落在 45 度对角线上。偏离对角线的程度和方向揭示了你系统性的过度自信或不足自信。Reckon 所承诺的"一年后看到自己的校准曲线",本质上就是这套方法论的个人化应用。当你积累了足够的数据点,这条曲线就成为你判断力的"体检报告"。
过程中:Check-in 机制捕捉信息变化
Reckon 引入了"check-in"(阶段性检查)机制,用来记录结果揭晓之前发生的变化。每当有新信息出现,你可以将其标记为正面或负面,并据此更新你的信心值。这个设计很聪明,因为现实中的决策很少是一次性的静态判断,信息在不断流入,而我们对信息的解读方式往往才是判断偏差的真正来源。
这种信心值的渐进更新,在概率论中对应的是贝叶斯更新(Bayesian updating)——根据新证据持续修正先验概率的过程。理想的决策者应当像一个完美的贝叶斯代理人(Bayesian agent)那样:每获得一条新信息,就根据其诊断价值(likelihood ratio)适度调整信念。然而现实中,人类的概率更新存在诸多系统性偏差:锚定效应(anchoring)让我们对初始信心过度执着,新信息的调整幅度往往不够;确认偏差(confirmation bias)让我们对支持既有信念的信息赋予更高权重,而对反面证据视而不见。Reckon 的 check-in 机制要求用户明确标注信息的正负性质并量化信心变化,这一设计本质上是一种"结构化贝叶斯更新"训练——它迫使你在记录层面对每条新信息的影响做出显式判断,而非让潜意识悄悄完成(或拒绝完成)这一过程。
结果与再审视:对判断的两次拷问
当结果出现时,你记录下究竟发生了什么。而真正体现产品深度的是接下来这一步:几周之后,Reckon 会主动问你——如果重来一次,你还会做同样的决定吗?
这一问将"结果好坏"和"决策好坏"这两个常被混淆的概念区分开来。一个好决策可能因运气不佳而结果糟糕,一个坏决策也可能侥幸成功。职业扑克选手 Annie Duke 在《Thinking in Bets》一书中将这种本能地用结果来判断决策好坏的倾向称为"结果论"(resulting)。
要更清晰地理解这一概念,可以借助一个决策-结果四象限矩阵来思考。第一象限是好决策+好结果,这是理想状态,但容易让人误以为所有好结果都源于好决策。第二象限是好决策+坏结果,这是最容易被错误惩罚的情况——一位基金经理在充分研究后做出的投资决策,即便最终因突发黑天鹅事件亏损,决策过程本身仍然是正确的。第三象限是坏决策+好结果,这是最危险的象限——Duke 称之为"被结果奖赏的坏习惯"。一位创业者在没有充分市场调研的情况下贸然推出产品,恰好赶上行业风口而大获成功,这种经历会在心理上强化"直觉优于分析"的错误信念,为未来更大的失败埋下种子。第四象限是坏决策+坏结果,这反而最不危险,因为负面结果至少提供了纠错信号。在医疗领域,这个矩阵同样适用:一位外科医生严格按照循证指南选择手术方案(好决策),但患者因罕见并发症去世(坏结果),事后审查不应因结果而否定决策过程。Reckon 的"几周后再审视"设计,正是迫使用户进入这个决策-结果分离的框架思考,而非简单地被结果劫持判断。区分二者,正是提升判断力的核心功课。
长期价值:看清你的校准曲线
Reckon 给出的长期价值承诺颇具吸引力。按官方描述,坚持记录一年后,你能看到自己的信心在哪些场景下"高估"(overshoots)、哪些场景下"低估"(undershoots),以及在哪类决策上判断最为敏锐。
这实际上是把"校准"这一在预测科学和概率思维中被反复强调的概念,产品化成了个人可用的工具。校准的概念最早在气象学中得到系统应用——天气预报员是最早被大规模评估校准水平的职业群体,研究发现经过长期反馈训练的气象预报员确实能达到极高的校准水平。在更广泛的预测科学中,Philip Tetlock 的"超级预测者"(Superforecasters)项目是校准研究的里程碑。
这个项目的全称是 "良好判断力项目"(Good Judgment Project),源于美国情报高级研究计划局(IARPA)在 2011 年发起的一项预测锦标赛。IARPA 挑战学术团队开发方法来提升地缘政治预测的准确度,Tetlock 的团队在与包括情报分析师在内的众多参赛者竞争中脱颖而出,其最优秀的预测者——被命名为"超级预测者"——的预测精度甚至超过了能接触机密情报的专业分析师。研究发现,超级预测者的核心认知特质包括:积极开放思维(actively open-minded thinking),即主动寻找反驳自己观点的证据;精细化概率更新,他们习惯以 1-2 个百分点的微小增量调整预测,而非在"会发生"和"不会发生"之间做粗糙的二元跳跃;以及成长型心态,他们视每次预测失准为学习机会而非自我否定。Tetlock 特别强调,校准能力并非天赋,而是可以通过刻意练习(deliberate practice)和持续反馈来系统性提升的技能。这一发现的革命性意义在于:如果普通人在获得适当反馈循环后也能显著提升预测准确度,那么 Reckon 这类工具就具备了真实的训练价值,而非仅仅是记录工具。
一个校准良好的人,说"我有 70% 把握"时,这类判断的实际成功率就应该接近 70%。大多数人从未有机会验证自己的信心是否可靠,而 Reckon 提供的正是这样一面长期的镜子。值得注意的是,研究还发现大多数人在未经训练时呈现系统性过度自信:当他们声称有 90% 把握时,实际正确率通常只有 70-75%。这种过度自信在专业人士中同样普遍甚至更为严重——一项经典研究发现,临床心理学家对其诊断"非常确信"时的准确率与"比较确信"时几乎没有差别。对于经常需要下判断的投资者、创业者、产品经理乃至任何重视理性决策的人来说,这种反馈回路的价值不容小觑。
产品形态与隐私设计
在具体形态上,Reckon 目前支持 iPhone 和 iPad。它采用 iCloud 同步,且无需注册账号——这意味着数据留在用户自己的苹果生态内,无需信任第三方服务器,隐私姿态相当克制。
从技术架构角度看,这种选择属于"零知识"(zero-knowledge)设计的变体。所有信息存储在用户个人的 iCloud 容器中,由苹果的端到端加密基础设施保护,开发者完全无法访问用户数据。具体而言,苹果的 CloudKit 框架为每个应用提供三种类型的数据库:公共数据库(所有用户可见)、私有数据库(仅用户本人可访问)和共享数据库(用户选择性共享)。Reckon 使用的是私有数据库(Private Database),数据以 CKRecord 对象的形式存储,每条记录包含键值对字段——在 Reckon 的场景中,这些字段对应的就是预测内容、信心水平、推理逻辑、check-in 记录和最终结果等结构化数据。私有数据库中的数据计入用户个人的 iCloud 存储配额而非开发者配额,且从 2016 年起苹果对 CloudKit 私有数据库实施了端到端加密,即便苹果自身也无法解密这些数据。这种架构对决策日志类应用尤为重要:用户记录的预测、信心水平和推理过程往往涉及职业决策、投资判断甚至人际关系评估,属于高度敏感的认知数据。从开发者运营角度看,CloudKit 的私有数据库读写完全免费(因为消耗的是用户配额),公共数据库才需要开发者支付超出免费额度的部分——这也大幅降低了独立开发者的运营成本,使得一次性买断的商业模式在经济上更加可行。
商业模式是一次性买断(one-time purchase),而非当下流行的订阅制,这对反感订阅疲劳的用户是个加分项。订阅疲劳(subscription fatigue)正在成为移动应用生态中日益严重的问题:据 2023 年的消费者调研,美国用户平均拥有 6-8 个付费订阅服务,超过半数表示"订阅数量太多",近三分之一在过去一年主动取消过至少一项订阅。在这种市场情绪下,一次性买断的定价策略不仅是对用户偏好的回应,也暗含了一种产品哲学:决策日志的核心价值在于长期积累的数据,而订阅制天然地让用户面临"停止付费即失去价值"的隐性威胁,这与强调长期坚持记录的产品目标存在内在矛盾。没有服务器成本就不需要持续性收入来覆盖运营支出,一次性付费与零服务器架构之间形成了自洽的商业逻辑。开发者为 Roland Leth。
总结:小而锋利的判断力训练工具
Reckon 属于典型的"小而锋利"的工具类产品:它不追求功能堆叠,而是把一个具体的认知问题——判断力的自我校准——做深做透。它的成败很大程度上取决于用户能否养成持续记录的习惯,毕竟"一年后的洞察"需要一年的坚持来兑换,这是所有量化自我类应用共同面临的留存挑战。
这一挑战的严峻程度不容低估。量化自我(Quantified Self)运动始于 2007 年,由《连线》杂志编辑 Kevin Kelly 和 Gary Wolf 发起,核心理念是通过数据追踪来获得自我认知。然而十多年来,该领域面临一个持续性困境:用户在初始新鲜感消退后的留存率极低。研究显示,约三分之一的可穿戴设备用户会在六个月内停止使用。与自动采集数据的硬件设备不同,需要手动记录的应用面临更严峻的留存考验——行为经济学中的"现在偏差"(present bias)意味着用户倾向于低估未来洞察的价值,而高估当下记录的成本。
从产品设计的角度看,量化自我应用的留存困境可以用福格行为模型(Fogg Behavior Model)来分析:行为的发生需要动机(Motivation)、能力(Ability)和触发(Prompt)三者同时到位。对于 Reckon 而言,用户做出重要决策的频率远低于每日步数或饮食记录,这意味着天然的触发频率较低。成功突破这一困境的产品通常依赖三个策略:极低的记录摩擦——如 Day One 日记应用通过 Apple Watch 快捷入口将记录时间压缩到几秒钟;即时的微反馈——如 Duolingo 通过连胜天数和即时评分创造短期激励循环;以及社交问责机制——如 Strava 通过社区分享将个人记录转化为社交承诺。Reckon 的 check-in 机制可被视为降低单次记录认知负担的尝试,同时 check-in 节点也创造了额外的互动频率。但缺乏社交层可能是其长期留存的潜在短板——在预测领域,Tetlock 的超级预测者项目之所以能维持高参与度,很大程度上得益于团队协作和同行比较所提供的外部激励。不过,对于决策日志这种高度私密的品类,引入社交层也可能带来隐私与开放性之间的两难。
但从设计理念看,Reckon 抓住了一个真实且普遍的痛点。在一个越来越强调数据驱动决策的时代,我们花大量精力优化外部系统——A/B 测试产品功能、用数据仪表盘监控业务指标、用算法辅助投资决策——却很少系统性地优化自己这台"判断机器"。认知科学家将人类判断力视为一种**"可训练的元技能"**(trainable meta-skill):它不是某个领域的专业知识,而是跨领域通用的概率评估和信念校正能力。正如运动员需要训练日志来追踪体能进步,决策者同样需要判断日志来追踪认知校准的改善。Reckon 提供的,正是给自己做一次长期回归测试的机会。
相关推荐

LynnReal-Omni:32B统一视频扩散模型开源,四步生成多任务全覆盖
LynnReal-Omni 是基于 MiniMax H3 架构的 32B 统一视频扩散模型,支持文生视频、图生视频、姿态引导、视频修复等多任务,四步快速生成,Flash 版单张 H100 上 377ms 完成 540p 视频,权重与 ComfyUI 节点已开源。

Anthropic联合创始人:AI"紧急停止开关"或应强制立法
Anthropic联合创始人向BBC表示,AI系统的"紧急停止开关"(kill switch)可能需要通过法律强制推行。本文分析这一呼吁背后的产业逻辑、技术挑战以及监管与创新之间的张力。

AI数据中心建设热潮,正冲击工业创伤深重的城市
AI数据中心建设热潮正与曾受重工业创伤的城市社区激烈碰撞。以费城为例,全国性反对声浪聚焦能耗、水资源与环境公平问题,揭示AI增长与地方利益的结构性冲突。