Reddit宣布停用RSS订阅,本地AI工作流再遭重击

Reddit将于11月13日停用RSS,本地AI信息流被迫寻找替代。
Reddit 宣布将于 11 月 13 日停止 RSS 订阅服务,直接冲击依赖 RSS 抓取内容构建本地 AI 信息流的开发者。r/LocalLLaMA 社区一位用户描述,其通过 RSS 汇总特定主题帖子并交由本地模型摘要的自动化流程将失去最稳定入口,此前 Reddit 强制登录政策已让智能体无法获取帖子。文章梳理了 Reddit 从匿名访问到轻量订阅通道持续收紧的轨迹,指出受影响的恰是非商用、低频率的个人用法。替代方案包括官方 API、第三方聚合服务或迁移到仍支持 RSS 的社区,但均需付出合规、隐私或可靠性代价,事件也再次暴露本地 AI 工作流对单一数据源的脆弱依赖。
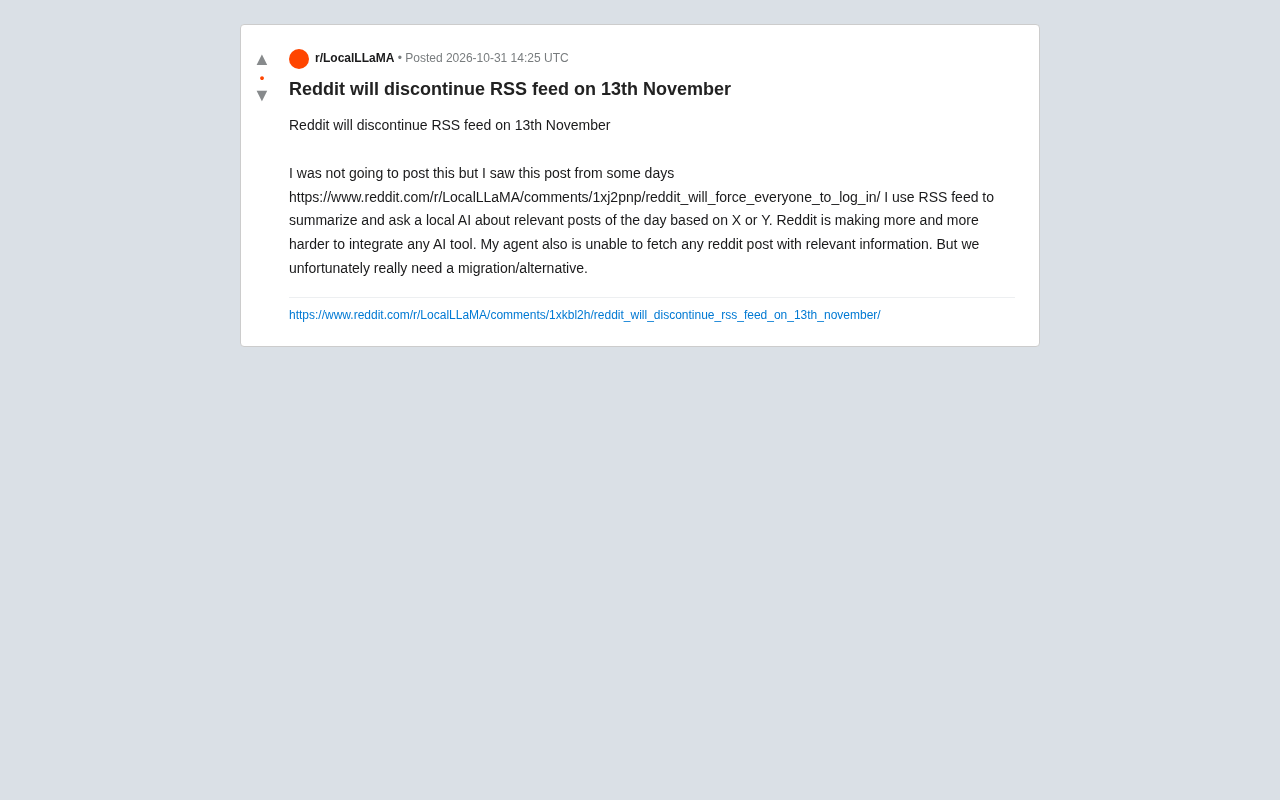
Reddit 正在一步步收紧对第三方访问的闸门。最新的一步是:RSS 订阅功能即将于 11 月 13 日停止服务。对于普通用户,这或许只是个不起眼的小变动;但对于依赖 RSS 搭建本地 AI 信息流的开发者来说,这意味着一套运转良好的自动化流程被迫按下暂停键。
一个 RSS 用户的日常,正在被切断
在 r/LocalLLaMA 社区,一位用户发帖表示,自己原本并不打算声张,但看到几天前另一篇关于“Reddit 将强制所有人登录”的讨论后,决定把这个问题摆上台面。
他的使用场景非常具体:通过 RSS 抓取 Reddit 上特定主题的帖子,汇总后交给本地 AI 模型,让模型围绕当天与某个关键词或某个社区相关的内容进行摘要,并回答相关问题。这套流程完全跑在本地,不依赖 Reddit 官方 API,也不涉及商业用途——它更像是一种个人知识管理的自动化延伸。
消息传来,意味着这条信息管道将被直接掐断。RSS 停止服务后,这个本地 AI 助手将失去最稳定的数据入口。
RSS(Really Simple Syndication)是一种基于 XML 的开放内容聚合协议,诞生于上世纪 90 年代末。网站将最新内容按统一格式发布为 RSS 源,用户只需一个阅读器或脚本定时拉取该源,即可自动获取更新,无需逐个访问页面,也无需登录或调用平台专有接口。由于 RSS 源是公开、无状态、纯读取的,它长期被视作“轻量级数据管道”,广泛用于资讯聚合、播客分发和自动化工作流。对本地的 AI 信息流而言,RSS 的价值在于稳定、结构化且不依赖授权,因此它常被当作最省事的输入层。但 RSS 只是传输格式,平台是否继续发布源完全由平台自己决定,这也埋下了说停就停的隐患。
Reddit 对 AI 工具的“围城”越筑越高
这位用户用了一个很直白的判断:“Reddit 正在让集成任何 AI 工具变得越来越难。”
这不是孤例。此前社区讨论的“强制登录”政策,已经让不少自动化脚本和匿名抓取手段失效。他的智能体(agent)如今已经无法获取任何带有相关信息的 Reddit 帖子。从强制登录到停用 RSS,Reddit 对外部访问的控制呈现出清晰的收紧轨迹:先切断匿名访问,再关闭轻量级订阅通道,剩下的只有需要授权、受条款约束的官方 API。
对于本地 AI 玩家而言,这种变化的杀伤力在于,它针对的恰恰是最“无害”的那类使用方式——不爬取全站、不高频请求、不商用,只是把公开内容读进自己的模型里做摘要。但平台的安全与商业考量,显然不会为这种个人用法开一扇小窗。
官方 API 与 RSS 的差别,是理解这次变动影响的关键。Reddit 官方 API 需要注册应用、获取 OAuth 凭证,并遵守明确的速率限制(按分钟和每日配额计)与使用条款,部分大规模商用访问还需付费。相比之下,RSS 既不需要身份认证,也不受类似配额约束,接入成本极低。因此,停用 RSS 在技术上并非“关掉一个功能”,而是把原本零门槛的公开读取,统一收拢到有身份、可审计、可计费的接口之下。对开发者来说,这意味着必须增加认证流程、处理令牌刷新与限流重试,还要评估条款是否允许把数据送入第三方或本地模型。
迁移与替代:没有完美选项,但必须行动
帖子的结尾带着一丝无奈:“我们真的需要一个迁移方案或者替代品。”
这大概是所有依赖 RSS 的本地 AI 用户共同的心声。现实是,Reddit 的替代数据入口正在收窄,而完全等效的替代品并不存在。可行的路径大致有几条:转向 Reddit 官方 API(需要注册应用、遵守速率限制和条款)、通过第三方聚合服务间接获取内容、或者干脆把信息源迁移到仍然支持 RSS 的社区和论坛。
每一条路都有代价。官方 API 带来的合规性和稳定性提升,但接入复杂度和限制也同步上升;第三方服务增加了中间环节,可靠性和隐私边界需要重新评估。对于把“本地”视为核心价值的用户来说,任何引入外部依赖的方案都是一种妥协。
评估替代方案时,有几个维度值得纳入决策:一是稳定性,官方 API 最稳但门槛最高,第三方聚合服务居中,自建抓取最脆弱;二是隐私边界,内容是否经过第三方服务器、是否会被记录,直接影响“本地处理”的价值主张;三是切换成本,接口协议差异(RSS 的 XML 与 API 的 JSON)需要适配层,最好抽象出统一的数据源接口,让上游替换不影响下游摘要逻辑。此外,还可以考虑用开源抓取框架配合缓存与去重策略降低对单一源的依赖,但需注意平台条款与访问频率,避免触碰反爬边界。没有一种方案能同时满足稳定、免费、隐私与合规,取舍取决于个人工作流对哪一项最敏感。
本地 AI 信息流的脆弱性,被再次提醒
这则消息真正值得思考的地方,不在于 RSS 本身。RSS 作为一种古老的开放协议,早已不是主流,但它代表了一种“内容可被自由读取”的互联网契约。当平台逐步收回这种契约,依赖公开数据构建的本地 AI 工作流就暴露出结构性的脆弱:你的模型再强、流程再优雅,数据入口一旦关闭,整条管线就归零。
对本地 AI 社区的开发者来说,这或许是一个重新审视数据源策略的契机——不要把信息流绑死在单一平台上,优先选择仍然尊重开放协议的来源,并在架构上为“某个源突然消失”预留切换成本。Reddit 的 RSS 停服只是一个具体事件,但它指向的趋势,值得每一个搭建个人 AI 信息管道的人认真对待。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。