人类 vs LLM模拟来访者:在线咨询训练对话模式对比

研究对比真人角色扮演与Mixtral模拟来访者,发现咨询对话模式相似但存在偏离。
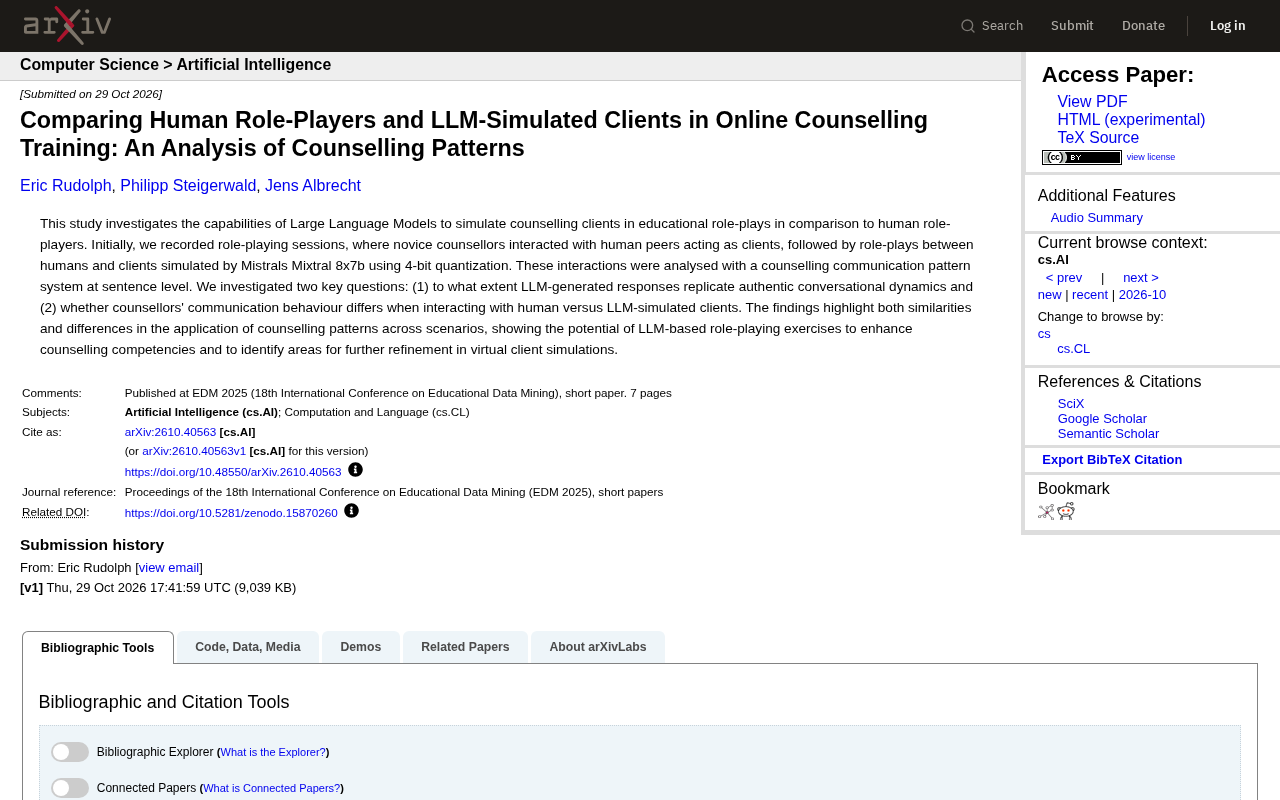
一项新研究将大语言模型用于心理咨询训练中的来访者角色扮演,采用Mistral的Mixtral 8x7b(4-bit量化)模拟来访者,并与真人角色扮演进行句级对话模式对比。研究让同一批新手咨询师分别与真人和AI来访者对话,按咨询沟通模式系统在句子层面编码分析。结果发现,LLM能在一定程度上复现真实对话动态,但部分咨询模式的分布与真人存在差异;咨询师面对AI时的沟通行为也与面对真人时不完全一致。研究认为LLM角色扮演有潜力作为可扩展、低成本的训练补充手段,但需针对偏离明显的模式进行校准,且结论受单一模型和新手样本限制。
心理咨询训练长期依赖真人角色扮演,但陪练成本高、标准化难。一项新研究将目光投向大语言模型:用Mistral的Mixtral 8x7b(4-bit量化)模拟来访者,与真人角色扮演进行句级对话模式对比,试图回答两个问题——LLM能否复现真实对话动态?咨询师面对人类和AI时的沟通行为是否不同?
研究设计:把咨询对话拆到句子级
研究团队先录制新手咨询师与真人同伴(扮演来访者)的角色扮演会话,再让同一批咨询师与Mixtral 8x7b模拟的来访者对话。所有交互均按咨询沟通模式系统在句子层面编码分析。
这种设计的巧妙之处在于控制变量:同一批咨询师、同一套编码体系,差异只来自"来访者"是人是机器。相比问卷或整体评分,句级模式分析能捕捉更细粒度的对话结构,比如提问类型、情感回应频率、引导与跟随的比例。
咨询沟通模式系统(Counseling Communication Patterns System)是一类用于编码咨询师与来访者对话行为的观察性工具。它将每句话按功能归类,例如提问类型(开放式/封闭式)、情感反映、内容复述、引导性陈述、跟随性回应等。与整体评分或自评问卷相比,句级编码能揭示对话的微观结构:谁能主导话题、咨询师多频繁地跟随来访者的情感线索、提问与反映的比例如何随时间变化。该系统的优势在于可操作性强、评分者间一致性可检验,因而适合跨条件(真人 vs. AI)的严格对比。
核心发现:相似与差异并存
研究结论并非简单的"AI可以替代真人"或"AI完全不像人",而是指出两种场景下咨询模式的应用既有相似也有差异。LLM生成的回应在一定程度上复现了真实对话动态,但在某些咨询模式的分布上与真人角色扮演存在偏离。
说个细节咨询师一侧的行为变化:面对LLM模拟来访者时,咨询师的沟通行为并非与面对真人时完全一致。这意味着即使来访者是AI,咨询师的对话策略也会发生微妙调整——这对训练有效性是个关键提醒:如果训练目标是迁移到真人咨询场景,模拟对象的"非人感"可能潜移默化地塑造出不同的沟通习惯。
由于原文未披露具体的模式分布数据与效应量,目前无法判断差异的幅度有多大,这也是后续研究需要补足的部分。
4-bit量化是指将模型权重从通常的16位浮点数压缩到4位整数表示,以大幅降低显存占用和推理成本。常见做法包括GPTQ、AWQ等后训练量化方法,能在消费级GPU上运行较大模型。代价是可能引入数值精度损失,影响生成文本的流畅性、多样性或指令遵循能力。在本研究中,使用4-bit量化的Mixtral 8x7b意味着模拟来访者的回应质量可能受量化影响,这是解读“LLM能否复现真实对话动态”时不能忽略的技术变量。
Mixtral 8x7b是Mistral AI发布的稀疏混合专家(Mixture-of-Experts, MoE)架构大语言模型。它包含8个专家网络,每个token推理时仅激活其中2个,总参数量约46.7B,但每token计算量接近12.9B稠密模型,因而在保持较强生成能力的同时降低推理成本。该模型支持多语言和较长上下文,常被用于对话模拟、摘要等任务。选择这一模型进行来访者模拟,兼顾了生成质量与部署可行性,但也意味着结论未必能直接推广到其他架构(如稠密模型或更大规模的MoE模型)。
对咨询训练的实践意义
研究的价值主张很明确:LLM角色扮演练习有潜力增强咨询胜任力,同时帮助识别虚拟来访者模拟中需要改进的环节。对培训项目而言,这意味着一种可扩展、低成本的陪练选项——不受真人演员时间与状态波动影响,可反复练习高难度情境。
但"有潜力"不等于"可直接部署"。研究同时指出了虚拟来访者模拟需要进一步打磨的方向:如果LLM在特定咨询模式上的表现偏离真人,训练中形成的互动脚本可能与真实来访者的需求错位。合理的做法是把LLM模拟定位为真人角色扮演的补充而非替代,并针对偏离明显的模式做定向校准。
局限与后续方向
该研究使用的是特定模型(Mixtral 8x7b)加4-bit量化,量化可能影响生成质量,结论能否推广到其他模型尚不明确。样本为新手咨询师,资深咨询师的表现是否呈现同样的行为偏移也未可知。此外,句级编码依赖人工标注,标注者一致性等细节在摘要层面未展开。
后续研究可扩大模型与咨询师群体的覆盖范围,并量化不同咨询模式的偏离程度,为虚拟来访者的"拟真度"建立可操作的评估标准。
标注者间一致性(inter-annotator agreement)是内容分析中衡量编码可靠性的关键指标,常用Cohen's kappa、Krippendorff's alpha等统计量。当多名研究者对同一批对话句子独立编码时,若一致性低,说明编码规则模糊或主观性过强,句级模式分布的比较结论便不可靠。在对比真人角色扮演与LLM模拟的对话时,确保两组数据由同一标准、同等严格度编码,是控制偏差的重要环节。原文摘要未披露该指标,读者在评估研究结论时需留意这一方法学细节。
相关推荐
触屏MacBook与混乱的苹果:一场刻意为之的冒险
The Vergecast 深入讨论触屏 MacBook Pro 的发布逻辑、ProLed 命名争议、iPad 被 iPhone 与 Mac 两头挤压的困境,以及苹果在 AI 时代如何靠高端硬件维持竞争力。

研究权力50年:Robert Caro的写作与权力洞察
Robert Caro研究权力50年,在访谈中谈Lyndon Johnson的说服力与杠杆、Robert Moses从理想主义到冷酷的变迁、大规模建设的困境,以及传记写作中压缩主题与孤独专注的方法。

2万美元的机器人能替你干家务吗?实测结果令人意外
一段YouTube实测视频展示2万美元机器人如何响应洗碗、关灯、倒垃圾、喂狗等指令。本文分析其真实能力边界、语音交互技术现状,以及家务机器人距离普及还有多远。