RidgeFill:免训练后层缓存填充,预填充提速最高1.6倍
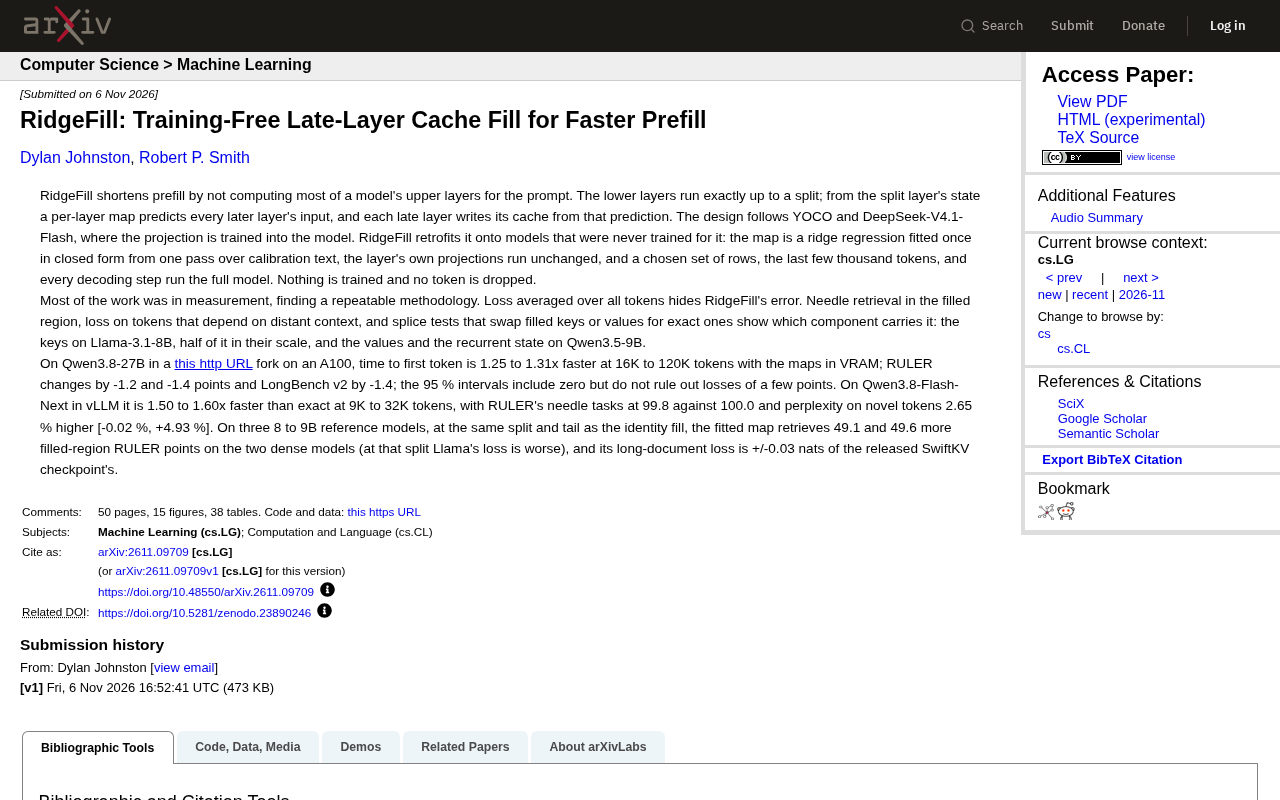
RidgeFill用一次闭式岭回归拟合层间映射,免训练跳过部分层以加速长上下文预填充。
RidgeFill针对长上下文预填充瓶颈,提出一种免训练加速方案:浅层精确计算到切分层,后续各层用闭式岭回归从一次校准前向中拟合的映射预测输入并写入KV缓存,同时保留选定行、最后几千token和解码步的完整计算,不丢弃任何token。作者强调平均loss会掩盖误差,设计needle retrieval、远距离token loss和splice test三条检测线,发现不同模型承压组件不同。实测Qwen3.8-27B在llama.cpp下16K-120K提速1.25-1.31倍,Qwen3.8-Flash-Next在vLLM下9K-32K提速1.50-1.60倍,精度下降约1-1.4点。其价值在于把需预训练的架构改动降级为一次性校准拟合,适合作为分层加速策略的一环。
大模型推理的瓶颈正在从解码转向预填充。当上下文长度拉到数万乃至十几万token时,逐层完整计算prompt的开销让首token延迟变得难以接受。RidgeFill给出了一条少见的路径:不训练、不丢token,用一次闭式岭回归拟合出的层间映射,跳过模型后段大部分层的计算,直接预测这些层的输入并写入KV缓存。
思路源头:把YOCO式的层间投影搬到未训练模型上
RidgeFill的设计参照了YOCO和DeepSeek广告-V4.1-Flash的架构思路——在这两类模型中,用一个投影把浅层状态映射到深层输入,本身是训练阶段就固化进模型的。RidgeFill要解决的是另一个问题:如何把同样的机制事后加装到从未为此训练过的模型上。
它的做法是:浅层照常精确计算到某个切分层;从切分层的状态出发,为每一个后续层拟合一个映射,预测该层的输入,再由该层自己的投影照常写出缓存。映射本身就是一个岭回归,从一段校准文本的单次前向中以闭式解拟合得到,只拟合一次。层的原始投影保持不动,不做任何微调。
为了控制误差,几个位置保留完整计算:选定的若干行、最后几千个token,以及解码阶段的每一步。原文强调"没有训练任何东西,也没有丢弃任何token",这是它区别于token剪枝类加速方案的关键。
YOCO(You Only Cache Once) 是一种解码器-解码器架构:先用一个浅层编码器处理整段上下文,只保留一次全局KV缓存,再由一个深层解码器通过跨注意力读取该缓存,从而避免逐层重复存储KV。其关键设计是浅层输出到深层输入之间存在一个可训练的投影,使深层无需重新编码上下文。RidgeFill借用的正是“层间投影”这一结构,但YOCO的投影在预训练阶段就与模型联合优化,而RidgeFill面对的是已经冻结的普通模型,只能事后用统计方法拟合一个近似映射。
闭式岭回归指解具有解析表达式、无需迭代优化的岭回归:给定输入矩阵X和目标Y,权重W = (XᵀX + λI)⁻¹XᵀY。其中λ控制正则强度,用于在样本有限时稳定解。RidgeFill在校准文本上采集切分层状态与后续各层真实输入作为(X, Y)对,一次前向后直接算出W,因此“拟合”成本仅相当于一次推理。闭式解也意味着映射是线性+正则的,表达力有限,这正是误差需要靠保留部分精确计算来兜底的原因。
真正的难点在测量,而不在拟合
这篇工作把大量篇幅放在方法论上,原因很直接:在所有token上取平均的loss会掩盖RidgeFill的误差。填充区域里的错误被大量简单token稀释,看起来损失很小,实际能力可能已经退化。
作者因此设计了三条互补的检测线:填充区域内的needle retrieval、依赖远距离上下文的token上的loss、以及把填充的key或value替换为精确值再比较的splice test。结论是不同模型上承压的组件并不相同——在Llama-3.1-8B上误差主要来自key,其中一半体现在scale上;在Qwen3.5-9B上则落在value和递归状态上。这种组件级的归因,比一个笼统的加速比更有工程价值,因为它指明了哪里需要保护、哪里可以放宽。
splice test 是一种组件级归因手段:把RidgeFill预测写入KV缓存的key或value,替换为同一位置由精确计算得到的真实张量,再观察下游指标是否恢复。若替换key后精度回升明显、替换value无变化,则误差主要来自key侧;反之亦然。它相当于对缓存内容做受控消融,把笼统的端到端损失拆解到具体组件,从而指导保护策略——例如对承压组件保留精确计算,对宽松组件继续走预测路径。
实测表现:加速比与精度代价并存
在A100上用llama.cpp分支跑Qwen3.8-27B,映射放在VRAM中,16K到120K token区间首token时间是精确计算的1.25到1.31倍。精度侧,RULER下降1.2和1.4个点,LongBench v2下降1.4个点;95%置信区间包含零,但也不能排除几个点的真实损失。
在vLLM上跑Qwen3.8-Flash-Next,9K到32K token区间相对精确计算达到1.50到1.60倍加速。RULER的needle任务为99.8对100.0,新词perplexity高出2.65%,区间为-0.02%到+4.93%。
三个8到9B参考模型上,在与identity fill相同的切分和尾部设置下,拟合映射在两个dense模型上多拿回49.1和49.6个填充区RULER点(该切分下Llama的loss更差),长文档loss与已发布的SwiftKV checkpoint相差在±0.03 nats以内。
工程视角:它适合放在什么位置
RidgeFill的价值不在于刷新加速比纪录,而在于把一条原本需要预训练的架构改动,降级成一次性的校准拟合。代价是精度并非无损,收益则随上下文变长而更明显——16K到120K的区间里加速比稳定,说明它针对的正是长上下文预填充这块最贵的成本。
几个现实约束需要正视。一是需要每个模型单独拟合映射,校准文本的选择会影响结果,这部分成本原文没有展开。二是映射需要常驻VRAM,显存紧张的场景要权衡。三是精度损失在部分基准上虽有置信区间覆盖零,但仍需在下游任务上验证,尤其是对远距离依赖敏感的应用。
更稳妥的用法是把它当作分层策略的一环:对延迟敏感、上下文极长的请求启用填充,对精度敏感的任务回退到精确计算。原文保留最后几千token和每个解码步的完整计算,本身就是这种混合思路的体现。至于key侧误差集中在scale这一发现,也提示后续可以在映射中加入对scale的专门校正,以更小的代价换回精度。
首token延迟(TTFT) 是预填充阶段的核心指标:请求到达后,模型需逐层处理全部输入token并写出KV缓存,才能生成第一个输出token。上下文越长,预填充的FLOPs和KV写入量越大,TTFT随之线性甚至超线性增长,而解码阶段每步只处理一个新token。RidgeFill跳过部分层的预填充计算,直接压缩的正是TTFT这一项,因此其收益随上下文变长而更明显,对短请求则意义有限。
相关推荐
Claude Code隐藏设置:开启Idle Compaction省大钱
Claude Code 的 Idle Compaction 设置可避免提示缓存过期后整段上下文按全价重发。本文介绍问题根源、开启路径与注意事项,帮助开发者降低长会话的 API 成本。
13个AI实用技巧:省钱、护隐私、升级数字生活
梳理The Explainer分享的13个AI实用技巧,涵盖用AI代理省钱谈判、数据删除请求、Claude Code诊断电脑、本地离线模型、车内语音学习与运动姿态分析,并强调人类监督与安全边界。
Claude Code省钱三件套:三个免费工具砍掉Token浪费
介绍Claude Code三个免费Token优化工具:RTK压缩终端输出、Caveman精简回复、微软Token Economizer学习仓库剪掉未用工具,测试中成本降低18%到31%,并提醒micro skills默认关闭需手动开启。