RLDS:用子任务分解重构强化学习信用分配
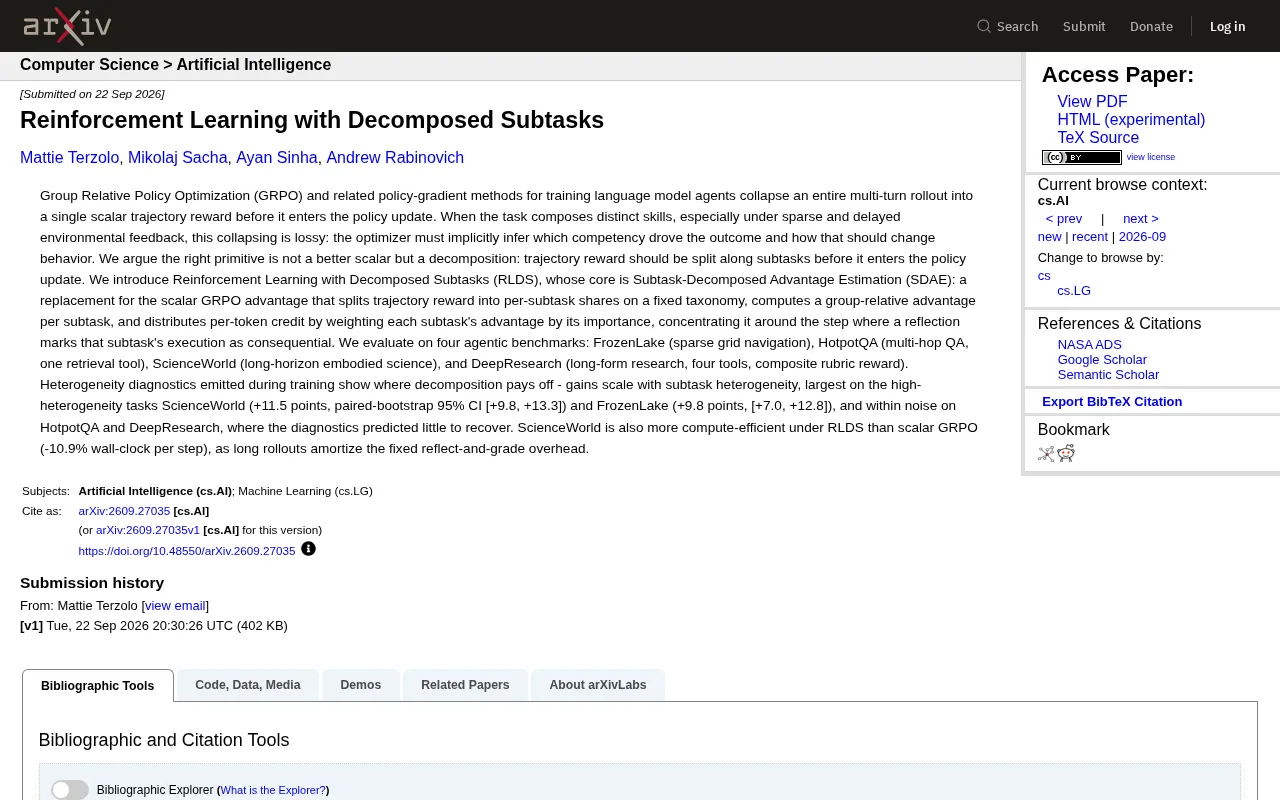
RLDS通过将轨迹奖励分解到子任务维度,解决GRPO在复合技能任务中的信用分配失真问题。
GRPO等策略梯度方法将多轮交互轨迹压缩为单一标量奖励,在复合技能任务中导致信用分配模糊——优化器无法区分是哪项子技能驱动了最终结果。论文提出RLDS方法,其核心组件SDAE将轨迹奖励按固定子任务分类拆分,分别计算组相对优势,并通过"反思"标记将梯度集中至关键决策token。在四个基准测试中,收益与子任务异质性正相关:高异质性任务ScienceWorld和FrozenLake分别提升+11.5和+9.8分,低异质性任务HotpotQA和DeepResearch的提升处于噪声范围内,与方法自身诊断一致。此外,RLDS在长轨迹场景下还比标量GRPO减少了10.9%的墙钟时间,提供了兼顾性能与效率的解决方案。
GRPO的瓶颈:标量奖励丢失了什么
在训练语言模型智能体(agent)时,GRPO(Group Relative Policy Optimization)及相关策略梯度方法有一个共同做法:把一次完整的多轮交互轨迹压缩成一个标量奖励,再送入策略更新。这个看似合理的简化,在处理复合技能任务时暴露出明显短板。
当一个任务由多种不同能力组合而成,尤其是在环境反馈稀疏、延迟的情况下,这种"塌缩"是有损的。优化器不得不隐式地去推断:到底是哪一项能力驱动了最终结果?这项能力又该如何调整?换句话说,一个单一的分数无法告诉模型"哪里做对了、哪里做错了",信用分配(credit assignment)因此变得模糊。
这篇 arXiv 论文提出的核心观点是:正确的做法不是去设计一个"更好的标量",而是分解——轨迹奖励应当在进入策略更新之前,沿着子任务维度拆分开来。
GRPO(Group Relative Policy Optimization)是近年来用于大语言模型对齐与强化学习微调的一类策略梯度算法,由DeepSeek广告团队在2024年提出并广泛应用于推理模型训练(如DeepSeek-R1)。它的核心思路是:对同一个输入采样一组输出,以组内平均奖励作为基线,计算每条输出相对于基线的优势值,从而避免训练一个独立的价值网络(critic)。这种设计使GRPO比PPO更轻量,尤其适合生成式任务。然而,这一设计的前提假设是奖励信号足够"充分"——即一个标量分数能够代表整条轨迹的质量。当任务由多个异质子技能组成时,这一假设会导致优化器无法区分"整体失败是因为哪个子技能出了问题",信用分配(credit assignment)问题因此被放大。
RLDS 与 SDAE 的核心机制
论文提出的方法叫 RLDS(Reinforcement Learning with Decomposed Subtasks),其核心组件是 子任务分解优势估计(Subtask-Decomposed Advantage Estimation, SDAE)。它被设计为标量 GRPO 优势函数的替代品,工作流程可以拆成三步。
按固定分类拆分奖励
SDAE 首先根据一个固定的子任务分类体系(taxonomy),把整条轨迹的奖励分摊到各个子任务上,得到每个子任务各自的奖励份额。这样一来,原本被压缩成一个数字的反馈,重新展开为一组带有语义含义的分量。
分子任务计算组相对优势
在拆分之后,方法对每一个子任务分别计算组相对优势(group-relative advantage)。这延续了 GRPO 用同组样本做基线对比的思路,但把对比粒度细化到了子任务层面,而不是整条轨迹。
按重要性分配 token 级信用
最后,SDAE 通过对每个子任务的优势按其重要性加权,来分配 token 级别的信用(per-token credit)。信用会集中在"反思"(reflection)标记该子任务执行具有关键影响的那一步附近。这种做法让梯度信号更精准地落在真正重要的决策点上,而不是均匀地摊在整条序列上。
Token级信用分配(per-token credit assignment)是序列决策强化学习中的经典难题。在语言模型训练场景下,一条回答可能包含数百个token,但真正决定最终奖励的往往只是其中少数关键决策点。如果将奖励信号均匀分摊到序列中每一个token,大量与结果无关的token也会获得梯度更新,造成"噪声梯度"问题。SDAE通过"反思"标记(reflection token)来定位哪一步对某个子任务的执行有关键影响,将梯度集中引导至这些位置,实质上是在做一种轻量级的时序信用分配,概念上与优势函数在强化学习中的作用类似,但粒度细化到了子任务与token的交叉维度。
四个基准上的实验结果
作者在四个具有代表性的智能体基准上评估了 RLDS,它们覆盖了从稀疏导航到长程科研的不同任务形态:
- FrozenLake:稀疏奖励的网格导航;
- HotpotQA:多跳问答,仅含一个检索工具;
- ScienceWorld:长程具身科学任务;
- DeepResearch:长文本研究,涉及四种工具,采用复合评分标准(composite rubric reward)。
实验中一个值得关注的设计是训练过程中输出的异质性诊断(heterogeneity diagnostics),它能揭示分解在什么场景下真正有价值。结论相当清晰:收益随子任务异质性增长而放大。
在高异质性任务上提升最为显著——ScienceWorld 提升 +11.5 分(配对自助法 95% 置信区间 [+9.8, +13.3]),FrozenLake 提升 +9.8 分([+7.0, +12.8])。而在 HotpotQA 和 DeepResearch 上,提升处于噪声范围内,这恰恰与诊断的预测一致:这两个任务本身可回收的信息就不多。
这种"诊断先行、结果印证"的呈现方式,让方法的适用边界变得可解释,而不是一味声称普适有效。
这四个基准在任务结构上各具代表性。FrozenLake是经典的稀疏奖励网格世界,智能体须在几乎没有中间反馈的情况下导航到目标格;HotpotQA要求跨多篇文档进行多跳推理,仅使用单一检索工具,子任务异质性较低;ScienceWorld是一个具身环境中的长程科学实验模拟,智能体需规划并执行多步操作,涉及感知、推理与行动等异质技能;DeepResearch则模拟真实的文献调研流程,使用搜索、摘要、引用等四种工具,并以复合评分标准(composite rubric reward)衡量报告质量。任务的多样性保证了实验结论在不同反馈密度与技能构成条件下的可靠性。
计算效率的额外收益
除了任务表现,RLDS 在 ScienceWorld 上还展现出比标量 GRPO 更高的计算效率——每步的墙钟时间(wall-clock)减少了 10.9%。原因在于长轨迹能够摊薄"反思与评分"(reflect-and-grade)这一固定开销:轨迹越长,这部分额外成本被均摊得越充分。
这一点对实际训练很有意义。人们通常会担心细粒度的信用分配会引入额外计算负担,但在长程任务场景下,RLDS 反而在效率上占了便宜。
方法的意义与边界
RLDS 的贡献不只是刷高了两个基准的分数,更在于它重新审视了策略梯度方法中奖励处理的基本单元。把"更好的标量"这一优化方向,转向"如何分解奖励",这是一个思路层面的转变。
同时,论文对方法的适用范围保持了克制的态度:分解带来的收益强烈依赖于任务的子任务异质性。对于技能构成单一、反馈相对密集的任务,细粒度分解的价值有限。这种坦诚的边界界定,反而增强了结论的可信度。
对于关注 LLM agent 训练的研究者而言,RLDS 提供了一个可借鉴的范式:在动手改进奖励标量之前,先问一句——这个任务的奖励是否值得被拆开?
相关推荐

腾讯WorkBuddy实测:AI Agent如何碾压传统聊天助手
腾讯WorkBuddy实测对比豆包:AI Agent如何直接操作电脑完成PPT转PDF、文件归档等任务。从安装门槛、国内生态、价格、插件市场四方面分析WorkBuddy优势,并给出AI Agent选择建议。

奥特曼称个人PC囤RAM“相当糟糕”,数据中心利用率更高
OpenAI CEO萨姆·奥特曼在Reddit引发热议的表态中称,个人PC配备大量RAM是“相当糟糕”的资源利用方式,数据中心凭借集中调度能实现更高内存利用率。本文解析这一观点背后的技术逻辑与行业信号。

付费5美元教AI说话:一场关于AI训练本质的社会实验
一位开发者搭建了运行真实语言模型的「假AI实验室」,用户支付5美元即可教模型一句话。这个社会实验揭示了AI训练中数据成本、用户参与和话语权的深层关系。