RL赛车智能体撞墙后卡死?试试这几种恢复策略

PPO竞速智能体撞墙卡死,需用消融实验区分数据、观测与动作空间瓶颈。
文章讨论了一位开发者训练SuperTuxKart强化学习智能体时遇到的撞墙卡死问题。PPO策略在21条赛道完成91/105场比赛,不及简单路径跟随器的100/105场,失败集中在撞墙后持续转向或救援后再次掉落。作者将原因归结为三类:恢复数据不足、观测视距有限、动作空间缺少刹车。在单人计时赛中,行为克隆与DAgger平均约38.3秒,SAC混合回放约38.7秒,但四车竞速尚未对比。文章建议优先做快速消融实验——延长赛道前瞻、加入刹车动作、针对性DAgger标注碰撞附近状态、可视化注意力——以定位瓶颈,而非盲目增加数据。同时提醒自动救援后的状态属于分布外,需专门数据增强。核心结论是先诊断再治疗,恢复能力往往比纯速度更重要。
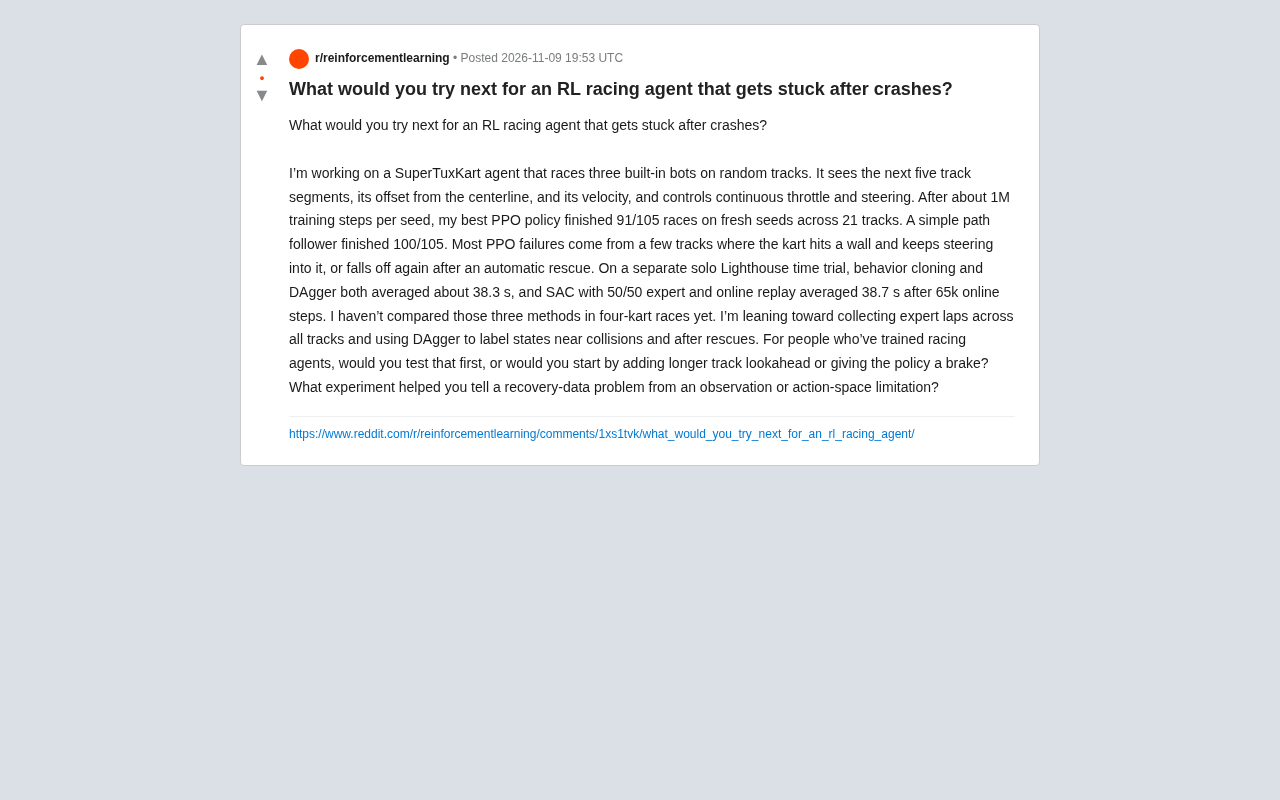
在强化学习(RL)竞速游戏中,智能体撞墙后卡死是一个典型难题。一位开发者训练SuperTuxKart智能体时,PPO策略在21条赛道上完成91/105场比赛,而简单路径跟随器完成了100/105场。失败案例集中在少数赛道:卡丁车撞墙后持续转向撞墙,或在自动救援后再次掉落。这引出一个关键问题:如何区分恢复数据问题、观测限制还是动作空间限制?
问题背景:撞墙卡死背后的三种可能
该智能体的观测包括前方五个赛道段、中心线偏移和速度,动作是连续的油门和转向控制。经过约100万训练步后,PPO策略的表现仍不理想。开发者倾向于收集专家圈速数据,用DAgger标注碰撞附近和救援后的状态。但在四车竞速场景下,行为克隆、DAgger和SAC(混合专家与在线回放)尚未对比。
从技术角度看,卡死可能源于三个层面:
- 恢复数据不足:智能体很少经历“卡死后如何脱困”的状态,导致策略在这些区域失效。
- 观测限制:五个赛道段的视距可能不足以预判碰撞后的脱困路径。
- 动作空间限制:只有油门和转向,没有刹车,智能体无法通过减速来调整姿态。
PPO(近端策略优化) 是一种主流的on-policy强化学习算法,通过限制策略更新的步长来保证训练稳定性。它使用裁剪的目标函数避免策略在单次更新中变化过大,在连续动作空间中表现良好,因此常被用于自动驾驶和机器人控制等任务。PPO的局限在于样本效率较低,每次更新后旧数据即被丢弃,需要大量环境交互。在竞速游戏中,这意味着智能体需要反复经历撞墙等边缘状态才能学到恢复策略,而这类状态在随机探索中出现的概率本就不高,进一步加剧了恢复数据稀缺的问题。
DAgger(Dataset Aggregation) 是一种交互式模仿学习算法。它先用专家演示训练初始策略,然后让策略在环境中运行并收集其访问到的状态,再请专家对这些状态标注正确动作,将新数据聚合进训练集并重新训练,如此迭代。与纯行为克隆相比,DAgger的关键优势在于训练分布会逐渐覆盖策略自身容易出错的区域——比如撞墙附近和救援后的状态。在RL竞速场景中,这意味着DAgger能针对性地为卡死状态提供专家动作标签,而不是只在专家轨迹的分布上做拟合。
实验对比:行为克隆、DAgger与SAC
在Lighthouse广告单人计时赛中,行为克隆和DAgger平均约38.3秒,SAC(50/50专家与在线回放)在65k在线步后平均38.7秒。这些结果在单人场景下接近,但四车竞速的交互复杂度更高。多源分析(基于Reddit讨论和类似RL竞速项目经验)表明,DAgger在标注碰撞附近状态方面有优势,因为它能主动查询专家在关键状态下的动作。
不过,也有开发者指出,单纯增加恢复数据可能不够。如果观测本身无法区分“撞墙后应该倒车还是转向”,那么再多的数据也无法让策略学会正确行为。因此,先做消融实验:固定数据,改变观测(如增加更长的赛道前瞻)或动作空间(如加入刹车),观察性能变化。
SAC(Soft Actor-Critic) 是一种off-policy的最大熵强化学习算法,其目标函数在最大化回报的同时最大化策略熵,鼓励探索并提升鲁棒性。Off-policy的特性使SAC可以将专家演示数据与在线交互数据混合放入回放缓冲区,实现类似“示范增强”的效果。文中提到的“SAC(50/50专家与在线回放)”即指回放缓冲区中一半来自专家轨迹、一半来自智能体自身交互。这种混合方式让SAC在数据效率和探索之间取得平衡,但与DAgger不同,SAC并不主动查询专家在关键状态下的动作,而是被动利用已有专家数据,因此在碰撞恢复这类稀疏关键状态上的覆盖能力可能弱于DAgger。
行为克隆(Behavior Cloning) 是最简单的模仿学习方法,直接将状态-动作对作为监督学习数据训练策略,本质上是分布匹配。它的问题在于协变量偏移:策略在自身运行时会进入专家数据中未出现的状态(如撞墙卡死),此时误差会累积放大。在竞速任务中,行为克隆能学会正常行驶,但对碰撞恢复等边缘状态缺乏泛化能力,这解释了为何其在单人计时赛中表现尚可,却在需要恢复能力的场景中暴露短板。
诊断方法:如何定位问题根源
要区分恢复数据问题与观测/动作限制,可以设计以下实验:
- 增加赛道前瞻长度:将五个赛道段扩展到更远,观察卡死频率是否下降。如果下降明显,说明观测限制是主因。
- 加入刹车动作:给策略一个刹车维度,看是否能学会减速脱困。如果刹车被频繁使用且成功率提升,说明动作空间限制。
- 针对性DAgger:仅在碰撞附近和救援后状态查询专家,对比整体成功率变化。如果提升有限,可能问题不在数据。
- 可视化注意力:检查策略在卡死时的观测输入,判断是否“看到”了墙壁但无法输出正确动作。
有开发者分享,在类似项目中,加入刹车后策略学会了在撞墙前减速,减少了卡死。但也有观点认为,更长的前瞻才是关键,因为智能体需要提前规划脱困路径。这两种方案并不互斥,可以同时测试。
消融实验(Ablation Study) 是机器学习中用于归因分析的实验设计方法:通过系统地移除或修改模型的某个组件、输入或能力,观察性能变化,从而判断该因素对最终结果的贡献。在本文语境下,消融实验意味着固定训练数据和算法,只改变观测维度(如延长赛道前瞻)或动作空间(如加入刹车),对比卡死率的变化。这种控制变量法的价值在于将“恢复数据不足”“观测限制”“动作空间限制”三个假设分离开来,避免同时改动多个因素导致无法归因。相比直接投入大量数据收集,消融实验成本低、周期短,能快速缩小问题范围,是RL工程实践中定位瓶颈的标准手段。
分布外状态(Out-of-Distribution, OOD) 指智能体在部署或评估时遇到的状态,其分布与训练数据显著不同。自动救援后的状态就是典型例子:智能体在训练中很少经历被救援传送回赛道的场景,因此该状态在训练分布中占比极低。当策略面对OOD状态时,其输出动作缺乏数据支撑,容易失效。解决思路包括在训练中主动注入救援状态进行数据增强,或使用DAgger让专家为这些状态标注动作,从而将OOD状态纳入训练分布。
实践建议:从诊断到迭代
对于这位开发者,建议优先做快速消融实验,而不是直接投入大量数据收集。具体步骤:
- 用现有PPO策略在卡死赛道上测试,记录状态分布。
- 快速训练一个带刹车的变体,对比卡死率。
- 如果刹车有效,再结合DAgger标注恢复状态;如果无效,尝试增加前瞻。
- 在四车场景下对比DAgger与SAC,关注交互导致的碰撞恢复。
有意思的是,自动救援后的状态可能分布外,需要专门的数据增强。有开发者建议在训练中主动注入救援状态,让策略学会从异常中恢复。
总之,先诊断再治疗。通过控制变量实验,可以明确瓶颈所在,避免盲目增加数据或调整网络结构。对于RL竞速智能体,恢复能力往往比纯速度更重要。
相关推荐

Agentic Paper Bomb:用多智能体自动生成企业合规文档
Reddit 开发者分享 Agentic Paper Bomb 实验:让五个 AI 智能体扮演高管角色,自动生成企业合规、安全、DevOps 等文档。探讨多智能体协作生成文档的潜力与隐忧。

《Rob Roy》经典台词解析:领导者的代价与生存抉择
解析《Rob Roy》中Rob Roy与Sibbald的经典对峙台词,探讨领导力的代价、生存与尊严的权衡,以及权力博弈背后的人性洞察。

黄仁勋被曝聘请擅长处理丑闻的公关公司
据 Wired 报道,黄仁勋在《纽约时报》报道其妻子商业往来后,聘请了一家曾处理高知名度性丑闻的公关公司。本文分析这一举动背后的危机管理信号及其对英伟达声誉的影响。