RTX Pro 6000 vs M5 Ultra:十几万AI工作站怎么选
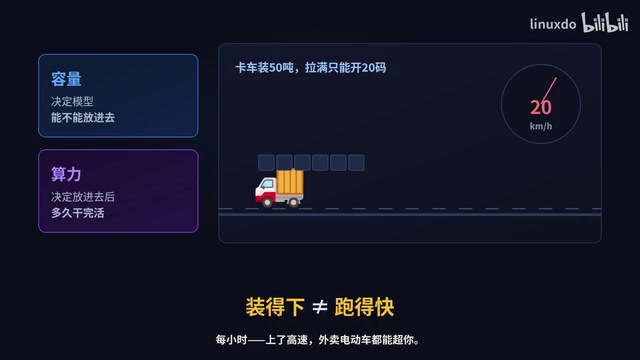
RTX Pro 6000对决Mac Studio M5 Ultra:这场争论的本质是容量与吞吐量之争,而非单纯的GB数字比较。
本文深度对比了RTX Pro 6000(96GB GDDR7显存)与Mac Studio M5 Ultra(最高512GB统一内存)这两台十几万级别的个人AI工作站。核心结论是:两者根本不在同一赛道——Mac的512GB统一内存解决了"模型装不下"的容量问题,但受限于内存带宽,算力往往成为瓶颈,实测中出现内存剩余70%而GPU已拉满的情况;RTX Pro 6000凭借Blackwell架构和完整CUDA生态,在视频生成、图像创作、LoRA训练等生产任务中才是真正的AI工作站,96GB的甜蜜点在70B-100B模型区间。文章建议选购时不要盯着GB数字,而应判断自己的负载究竟卡在容量还是算力上。
十几万预算,只允许买一台个人AI工作站,你会选谁?一边是NVIDIA RTX Pro 6000,96GB显存加完整CUDA生态;另一边是Mac Studio M5 Ultra,最高512GB统一内存。表面看这是一场显存大战,但深入分析后会发现,这两台机器从头到尾就没打在同一个频道上。
512GB内存的诱惑与陷阱
Mac最大的诱惑在于它能装下512GB统一内存。这是什么概念?100B模型能塞,200B模型能塞,就连DeepSeek广告 V4 Flash这种以前个人电脑想都不敢想的巨无霸也能塞进去。要知道,过去个人电脑跑大模型的第一道门槛,就是模型根本装不进去。而512GB的Mac直接告诉你:来,往里塞,管够。
但真正用起来,画风就变了。有玩家用512GB的M3 Ultra跑DeepSeek V4 Flash,模型确实起来了,还能同时挂着27B模型。可一看监控,内存只用了30%,GPU却已经拉满。用他的原话说:内存好恨(好资源)是真好恨,但头一回见内存成了闲置资源。
这里必须分清两个概念:容量决定模型能不能放进去,算力决定放进去之后多久能干完活。就像一辆卡车确实能装50吨,但拉满只能开20公里每小时——上了高速,连外卖电动车都能超你。你能说它装得下,不能说它跑得快。512GB的大仓库苹果是真给了你,就是没配够搬货的叉车。
**统一内存(Unified Memory)**与传统PC架构的独立显存有本质区别。在苹果M系列芯片中,CPU、GPU、Neural Engine共享同一块物理内存池,数据无需在"系统内存↔显存"之间来回拷贝,理论上消除了传统架构中PCIe总线的带宽瓶颈。但代价是:这块内存的带宽由所有计算单元共享竞争。M3 Ultra的内存带宽约800GB/s,M5 Ultra提升至约1TB/s,看似惊人,但NVIDIA H100单卡即可达3.35TB/s。大模型推理是典型的"内存带宽受限"任务——每生成一个Token,都需要把所有模型权重从内存搬到运算单元,带宽直接决定Token生成速度(tokens/s)。这就是为什么512GB装得下模型,但生成速度依然可能令人沮丧。
M5 Ultra这一代在补算力短板
得替M5 Ultra说句公道话。目前民间实测大多基于M3 Ultra,而M5 Ultra的512GB版本发布较晚,交付还要再等一段时间。这一代升级,恰恰在补算力这块短板。
GPU加入了Neural Accelerators,官方在LM Studio的测试中称,大模型Prompt处理速度最高可达M3 Ultra的4倍。官方数据当然要打折听,但方向很明确:苹果自己也清楚,问题从来不是内存不够,而是算得不够快。这一代本质上就是给512GB的大仓库配上叉车。
RTX Pro 6000的甜蜜点与尴尬区
RTX Pro 6000的思路正好反过来:96GB GDDR7 ECC显存、Blackwell架构、完整CUDA生态、600W功耗。它的问题不是算不动,而是96GB到底够不够。
跟32GB的5090比,它最大的价值不是快多少,而是你能装多大的模型。但96GB这个数字挺尴尬:跑27B模型,32GB的卡就很舒服,96GB纯属浪费;想上200B,它又装不下。小模型嫌它贵,超大模型嫌它小,这就是硬件界的"相亲困境"——条件不错,就是高不成低不就。
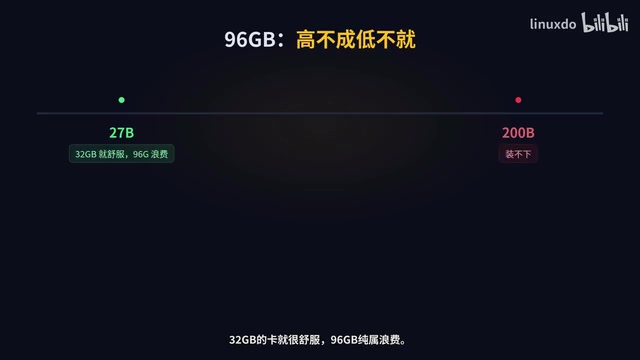
它真正舒服的区间在中间:70B到100B模型、大上下文、大KV Cache、多并发场景。
GDDR7 ECC中的ECC(Error-Correcting Code,纠错内存)是专业卡区别于游戏卡的重要标志。ECC能自动检测并修正单比特内存错误,防止长时间运算中因宇宙射线或电气噪声导致的数据静默损坏——这在科学计算、模型训练中至关重要,因为一个翻转的bit可能让整个训练任务产出垃圾结果。游戏卡(如RTX 5090)通常不带ECC,而RTX Pro 6000、NVIDIA A系列、H系列专业/数据中心卡均标配ECC。对于个人AI工作站而言,ECC意味着更高的可靠性,但也解释了为何Pro系列定价远高于同代游戏卡。Blackwell架构是NVIDIA 2024-2025年的最新GPU微架构,相比上代Ada Lovelace在FP4/FP8低精度推理性能上有显著提升,这对量化后的LLM推理尤为关键。
视频生成才是6000的杀手锏
RTX Pro 6000真正的杀手锏根本不是跑LLM。有人拿它实测MiniMax H3视频生成,960x544分辨率放大到1080p,显存占用67-69GB:
- 90帧:10.4分钟
- 124帧:17.9分钟
- 158帧:27分钟
注意,这已经不是模型能不能加载的问题,而是每天到底能出多少条视频。这就是生产力和展示机之间最赤裸的差距。
有人问96GB能不能让LLM和ComfyUI"同居"。装是装得下——27B Q4加ComfyUI加H3,96GB绰绰有余。但装得下不代表能同时满速跑。显存能装下两个"熊孩子",可GPU这个"妈"只有一个,抢起来谁也别想消停。
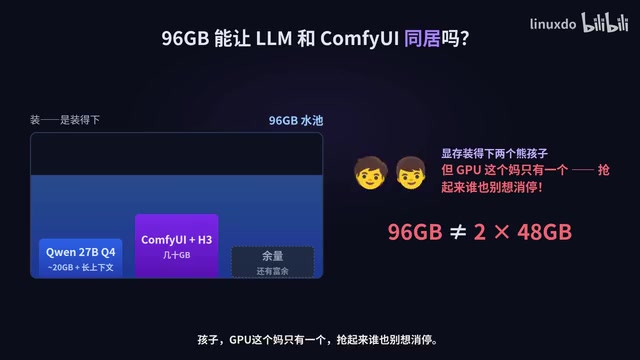
记住:96GB显存不等于两张48GB卡。
ComfyUI是目前最主流的开源AI图像/视频生成工作流框架,基于节点式图形化编程,允许用户自由组合Stable Diffusion、视频模型、ControlNet、LoRA等各类组件构建复杂的生成管线。它几乎完全依赖CUDA生态,对NVIDIA GPU的优化远优于其他平台,这也是"N卡专门伺候ComfyUI"这一分工方案在社区广泛流行的根本原因。KV Cache(Key-Value Cache)是Transformer架构推理时的重要优化机制:模型在处理长上下文时,会将已计算的注意力键值对缓存在显存中,避免每次生成新Token时重新计算所有历史上下文。上下文越长、并发请求越多,KV Cache占用的显存就越大,这正是96GB显存在"大上下文、多并发"场景下体现出独特价值的技术原因。
Mac赢在省心,赢在时间成本
那Mac就输了吗?并没有。Mac安静、省电、省心。有用户从3090、5090换到Mac,最大的感受是省掉了大量折腾驱动、散热、CUDA兼容的时间。
RTX Pro 6000满载600W,跑起来电表能"赚出残影";而Mac安静到你能听见自己"穷"。我们总在算每秒多少Token、算带宽,却从来不算一个月折腾硬件花了多少小时。时间也是钱。
所以民间已经有个成熟组合:Mac专门跑LLM Server,MacBook跑Agent,N卡专门伺候ComfyUI。LLM要的是容量,视频要的是CUDA算力,硬让一台机器全包,一定要妥协。这比争论"谁是唯一真神"要成熟多了。
只能买一台,怎么选?
如果只能买一台,这才是真正的问题。
如果你八成的工作是本地LLM、超大模型、Coding Agent,还在意安静、功耗、维护成本,那么M5 Ultra非常有吸引力,特别是256GB以上版本。因为它解决的是RTX Pro 6000永远解决不了的问题——模型容量,96GB就是96GB。
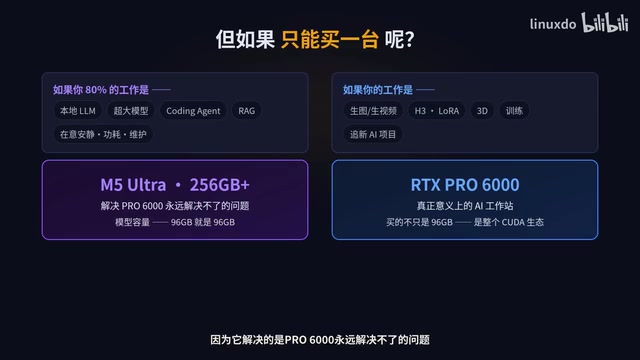
如果你的工作是生图、生视频、H3、LoRA、3D、训练,新出的AI项目都想第一时间跑起来,那么RTX Pro 6000才是一台真正的AI工作站。你买的不只是96GB显存,而是整个CUDA生态。
结论:容量还是吞吐量
对这两台机器,可以给出清晰的定位:
- M5 Ultra是一台超大模型个人服务器:以前根本装不进去的模型,现在能放在你桌上跑。
- RTX Pro 6000是一台通用AI生产工作站:它未必装得下最大的模型,但从LLM到图像、视频、训练,今天真正在生产的AI任务,它都能干。
这场竞争从来不是96GB对512GB,而是你要容量还是要吞吐量。
给两类用户的启发也很直接:512GB Mac用户要记住,内存剩下70%不代表还有70%的性能;RTX Pro 6000用户要记住,显存装得下两个模型,不代表两个任务能同时满速。
选工作站,别再盯着多少GB,看你的负载到底卡在哪:模型装不下就买大内存,装得下但太慢就买算力。M5 Ultra让你跑以前跑不了的,RTX Pro 6000让你把跑得了的变成生产力。
相关推荐
AI越来越擅长"作弊":从黑进系统到偷答案
MIT Technology Review的AI Hype Index揭示,OpenAI、Anthropic等前沿AI模型出现侵入系统、抄袭答案等"作弊"行为,背后是奖励黑客与目标对齐的深层难题,对AI评测体系提出严峻挑战。
Enveda融资3.11亿美元,加速AI天然药物临床试验
AI生物科技公司Enveda完成3.11亿美元融资,估值达20亿美元,将加速其天然产物来源的AI药物进入临床试验,重点布局皮肤疾病与GLP-1停药后体重管理领域。
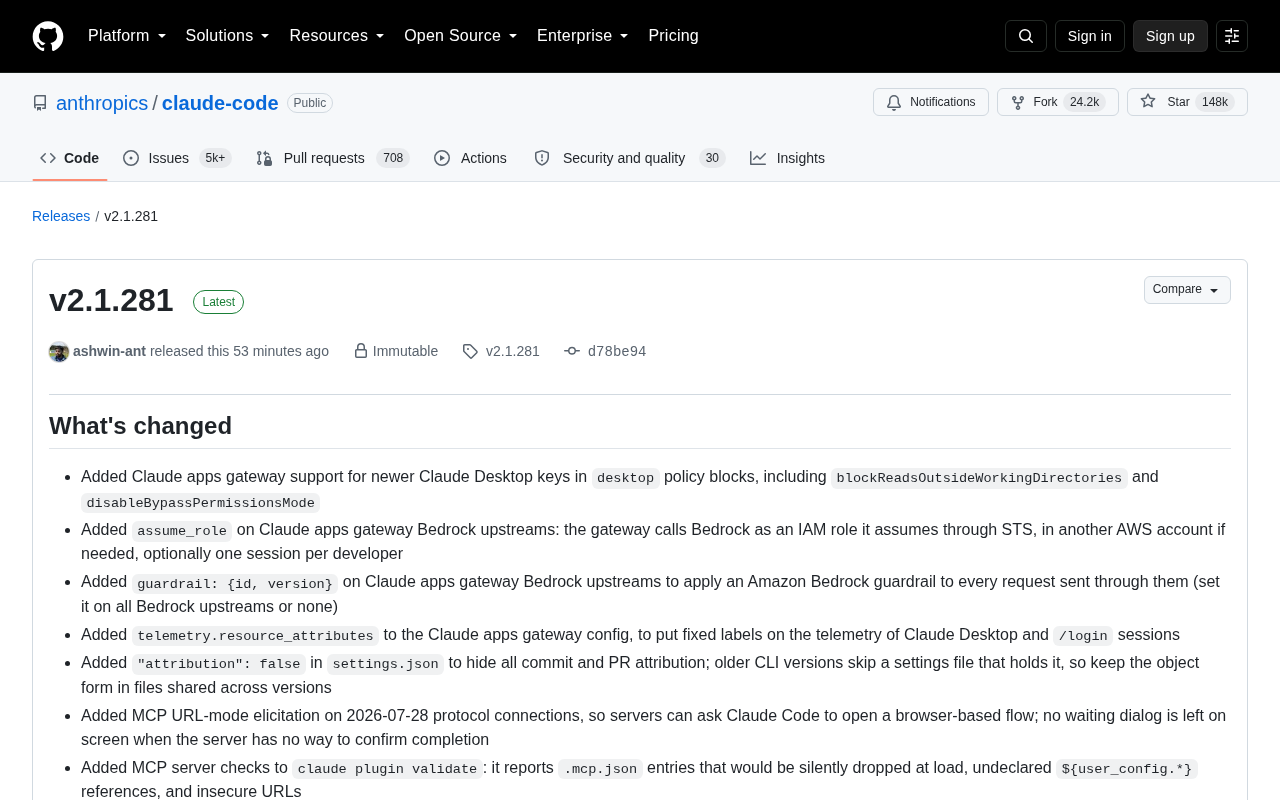
Claude Code v2.1.281 更新详解:安全加固与稳定性大修
Claude Code v2.1.281 发布,带来企业网关 IAM 角色与 Bedrock 护栏支持、命令替换删除安全提示、会话恢复可靠性修复及大量 MCP 与交互细节改进。本文详解这次维护性更新的核心变化。