如何关闭侵入式AI功能:实用禁用指南
当AI从辅助工具变成强制安装
几乎所有主流软件和操作系统都在内置AI功能。从操作系统层面的智能助手,到浏览器、办公套件、开发工具,AI正以前所未有的速度渗透进日常使用的每一款产品中。然而,这股浪潮也引发了越来越多用户的反感——Hacker News上《How to disable or avoid intrusive AI》的讨论正是这种情绪的集中体现。
Hacker News社区背景补充:Hacker News是由硅谷知名创业孵化器Y Combinator于2007年创建的技术社区,聚集了全球大量程序员、创业者和技术爱好者。该平台以其高质量的技术讨论、理性的批判精神和对用户隐私的高度关注而闻名。社区用户通常对技术产品持有较高的判断标准,对于侵犯用户自主权、过度商业化的产品设计往往会展开激烈讨论。因此,当《How to disable or avoid intrusive AI》话题在该平台引发热议时,这不仅代表了技术从业者的共同关切,也反映出AI产品化过程中出现的系统性问题正在引发广泛的用户反感。
AI功能向消费级软件的大规模渗透始于2022年底ChatGPT的发布。在此之前,AI在软件产品中的存在主要以推荐算法、语音助手等相对低调的形式出现。但生成式AI的突破性进展彻底改变了格局:微软在2023年将Copilot深度整合进Windows、Office和Edge浏览器;Google在搜索结果中强制展示AI Overviews;Adobe在Creative Suite中嵌入Firefly生成式功能;甚至连终端工具和文件管理器也开始加入AI特性。这场"AI军备竞赛"的驱动力来自资本市场——在2023-2024年间,宣布AI战略的公司股价普遍获得显著溢价,这促使几乎所有软件厂商都急于在产品中加入AI功能,不论该功能是否真正解决了用户痛点。
问题的核心不在于AI本身,而在于它的"侵入式"呈现方式。许多AI功能默认开启、难以关闭,甚至在用户明确表示不需要时依然反复弹出提示。对于追求专注、注重隐私、或不希望工作流被打断的用户来说,这种"被迫使用"的体验已成为一种数字负担。
侵入式AI的典型表现
在采取应对措施之前,有必要了解AI侵入的常见场景。
强制默认开启
最常见的问题是AI功能被默认启用。无论是搜索引擎顶部的AI摘要、办公软件侧边栏的智能助手,还是IDE中自动弹出的代码补全建议,用户往往在没有主动选择的情况下就被推送了这些功能。更令人不满的是,关闭入口通常藏得很深,需要在多层设置菜单中反复寻找。
IDE中AI功能的技术实现:集成开发环境(IDE)中的AI代码补全工具,如GitHub Copilot、Tabnine等,基于在海量开源代码上训练的生成式模型。这类工具通过分析当前代码上下文、项目结构和编程语言特征,实时预测开发者接下来可能编写的代码。技术上,它们会将编辑器中的代码片段发送到云端服务进行推理,然后返回建议。虽然能显著提升某些场景下的编码效率,但也带来问题:频繁的自动弹出建议会打断编码思路;将专有代码发送到云端引发知识产权和商业机密泄露风险;在网络延迟较高时反而降低响应速度。更关键的是,许多开发者认为过度依赖AI补全会削弱对代码的深入理解和问题解决能力。
AI功能的"强制默认开启"实际上是用户体验设计中"暗黑模式"(Dark Patterns)问题的延伸。暗黑模式这一概念由UX设计师Harry Brignull在2010年提出,指的是通过设计手段操纵用户做出非自愿选择的界面策略。常见手法包括:将退出选项设计得极难发现(也称为"蟑螂旅馆"模式——容易进入、难以退出)、使用视觉误导让用户误点同意按钮、以及通过反复弹窗施加心理压力使用户最终妥协。欧盟的《数字服务法》和美国联邦贸易委员会已开始对暗黑模式进行监管,但AI功能的强制推送目前仍处于监管灰色地带。
数据与隐私顾虑
许多AI功能依赖将用户数据上传至云端进行处理。对于处理敏感信息的用户——如律师、医生、开发者——这意味着潜在的隐私和合规风险。即便厂商声称数据不会被用于训练,用户对"默认联网上传"这一行为本身仍抱有强烈的不信任感。
AI云端处理的技术原因:当前主流的AI功能主要基于大语言模型(LLM)和机器学习算法实现。这些功能通常需要将用户输入的数据发送到云端服务器进行处理——因为模型参数量巨大(如GPT-4拥有数千亿参数),本地设备难以承载完整推理过程。云端处理意味着用户的文本、代码、文档内容需要通过网络传输,这也是隐私顾虑的根源。部分厂商开始尝试端侧AI方案,通过量化、剪枝等技术将小型模型部署在本地,但功能通常受限。此外,AI功能往往需要持续的网络连接来获取模型更新、进行A/B测试,以及收集用户交互数据用于改进算法,这种"常驻后台"的运行模式也是造成资源占用和干扰的重要原因。
针对云端AI处理的隐私问题,业界正在积极探索端侧(On-device)AI方案。Apple在2024年推出的Apple Intelligence采用了"混合架构"——简单任务在设备本地处理,复杂任务通过其"私有云计算"(Private Cloud Compute)处理,声称数据不会被存储或用于训练。高通、联发科等芯片厂商也在移动处理器中集成专用的NPU(神经网络处理单元),使得智能手机能在本地运行数十亿参数的模型。模型压缩技术如GGUF量化格式,可以将原本需要数十GB显存的模型压缩到几GB甚至更小,使其能在普通消费设备上运行。然而,端侧AI目前在能力上仍与云端大模型存在明显差距,且会显著增加设备的电池消耗和发热。
AI功能默认收集和处理用户数据的做法,在法律层面也面临越来越大的挑战。欧盟《通用数据保护条例》(GDPR)的核心原则之一是"数据最小化"——只应收集实现特定目的所必需的最少数据,且必须获得用户的明确知情同意。2024年生效的《欧盟人工智能法案》(EU AI Act)更进一步,要求AI系统的开发者和部署者对高风险应用提供透明度报告、进行影响评估,并确保用户有权拒绝自动化决策。在美国,虽然缺乏统一的联邦隐私法,但加州的CCPA/CPRA、科罗拉多州AI法案等地方性法规也开始对AI数据处理提出约束。对于使用AI功能的企业用户而言,如果AI工具将客户数据发送到云端进行处理,可能违反行业特定的合规要求,如医疗行业的HIPAA、金融行业的SOX法案等。
注意力与工作流干扰
频繁弹出的AI建议、提示气泡和"试试新功能"的引导,会不断打断用户的专注状态。对于需要深度思考的工作,这种持续的视觉和交互干扰会显著降低效率。
AI建议频繁弹出对工作效率的负面影响,可以从认知科学角度得到深入解释。计算机科学家Cal Newport在其著作《深度工作》中指出,人类进入高效专注状态(即"心流"状态)通常需要15-25分钟的不间断集中,而一次中断后恢复到同等专注水平可能需要额外的23分钟。加州大学尔湾分校的Gloria Mark教授的研究进一步证实,频繁的任务切换不仅降低工作质量,还会显著增加心理压力和疲劳感。AI功能的持续提示本质上制造了一种"被动中断"——即使用户选择忽略提示,大脑仍需消耗认知资源来处理和过滤这些视觉信号,这就是所谓的"注意力残留"效应。从这个角度看,侵入式AI不仅是体验问题,更是一个实实在在的生产力问题。
关闭侵入式AI的三大实用方法
针对不同类型的软件和使用场景,以下是社区总结出的行之有效的应对策略。
方法一:系统与应用层面的设置排查
第一步是深入设置菜单。大多数厂商即便把关闭选项藏得很深,通常仍会提供禁用入口。建议重点检查以下几类设置项:
- 隐私与数据设置:查找"AI功能"、"智能建议"、"数据共享"、"改进产品体验"等选项并逐一关闭。
- 通知设置:禁用AI相关的提示、气泡和引导性通知。
- 实验性功能开关:许多软件将AI放在"实验室"或"预览功能"中,可以整体关闭。
方法二:选择不含AI的替代软件
当无法彻底关闭某款软件的AI功能时,切换到更注重简洁和隐私的替代品是更彻底的解决方案。开源社区提供了大量选择:
- 用轻量级的开源编辑器替代内置AI助手的商业IDE;
- 使用不含AI摘要的隐私搜索引擎;
- 选择本地优先、不强制联网的办公工具。
开源软件的优势机制:开源软件采用源代码公开、社区协作的开发模式,任何人都可以查看、修改和分发代码。这种透明性使得用户能够准确了解软件的功能实现,不存在"黑箱"操作。开源社区通常由志愿开发者和用户组成,决策过程相对民主,更倾向于优先考虑用户需求而非商业指标。例如,如果某个开源项目试图强制添加联网AI功能,社区成员可以通过代码审查提出反对,甚至分叉(Fork)项目创建去除该功能的版本。这种机制天然地抑制了侵入式设计。此外,开源软件通常遵循"默认安全"和"最小权限"原则,不会在用户不知情的情况下收集数据或启用额外功能,这与当前许多商业软件的"默认开启AI"策略形成鲜明对比。
开源社区对侵入式功能的抵制有着深厚的历史传统。最著名的案例之一是2014年Mozilla在Firefox浏览器中默认启用DRM(数字版权管理)模块,引发社区强烈反对并催生了多个去除该功能的分叉版本。类似地,当Ubuntu在2012年将用户桌面搜索结果发送给Amazon时,社区的抗议最终迫使Canonical撤回了该功能。在AI时代,这种"用户主权"运动正在重新活跃:已有开发者创建了去除AI功能的浏览器分叉版本、维护屏蔽AI服务域名的社区列表,以及开发专门的浏览器扩展来过滤AI生成的搜索结果。自由软件基金会(FSF)创始人Richard Stallman长期倡导的"用户自由"理念——用户应完全控制其使用的软件——在这场反侵入式AI运动中再次获得了广泛共鸣。
方法三:网络层面的拦截
对于技术能力较强的用户,还可以在网络层面进行拦截。通过配置hosts文件、防火墙规则或DNS过滤,屏蔽AI功能所依赖的特定服务器域名,可以从根源上阻止AI功能的联网行为。
网络拦截的技术原理:Hosts文件是操作系统中用于将域名映射到IP地址的本地配置文件,优先级高于DNS查询。通过在hosts文件中将AI服务的域名指向无效IP(如127.0.0.1或0.0.0.0),可以阻止应用程序与对应服务器建立连接,从而禁用依赖该服务的AI功能。DNS过滤则是在网络层面进行拦截,通过配置路由器、防火墙或使用专门的DNS服务(如Pi-hole),可以批量屏蔽特定域名的解析请求。这种方法的优势是作用范围广、不需要修改每个应用的设置;但缺点是可能误伤其他功能,且需要持续维护屏蔽列表。对于企业环境,网络层拦截还能统一管理多台设备,防止敏感数据通过AI功能外泄。
需要注意的是,这种方法有一定技术门槛,且可能影响软件的其他正常功能,需谨慎使用。
这场讨论背后的深层信号
这个话题折射出当前AI产品化过程中的一个重要矛盾:厂商的商业动机与用户的实际需求之间存在错位。
对厂商而言,AI是最重要的营销卖点和资本叙事,将其默认开启、广泛铺开有助于提升"AI使用率"这一关键指标。但对相当一部分用户来说,他们需要的是稳定、可预测、不被打扰的工具体验。当AI从"可选的增强"变成"无法拒绝的默认",用户的自主权就受到了侵蚀。
指标驱动与用户体验的冲突:在互联网和软件行业,"数据驱动"的产品管理方法论占据主导地位。产品团队通常会设定关键指标(如AI功能使用率、用户停留时长、功能点击率)来衡量产品表现和团队绩效。当AI成为公司战略重点时,"AI功能渗透率"往往成为核心KPI。为了提升这些数字,产品经理倾向于采用默认开启、频繁提示等"激进"策略。然而,这种量化指标无法准确反映用户的真实满意度——一个被迫频繁看到AI建议的用户可能贡献了很高的"曝光量",但实际体验很差。这种错位在技术公司尤为明显:工程师文化推崇效率和控制权,而产品文化强调增长和参与度,两者在AI功能的呈现方式上产生了根本性分歧。
值得强调的是,这种反弹并非"反对AI",而是"反对被强制"。真正优秀的AI产品设计应当尊重用户的选择权:默认克制、易于开启、也易于关闭。让用户在需要时主动召唤AI,而非让AI无时无刻地推销自己。
结语:把选择权还给用户
随着AI功能持续扩张,如何优雅地关闭AI或许会成为越来越多用户的刚性需求。对于个人用户,掌握设置排查、替代软件和网络拦截这三层应对手段,基本可以重新夺回对工作环境的控制权。
而对于产品设计者,Hacker News上的这场讨论是一个值得倾听的信号:AI能力的强弱固然重要,但对用户自主权的尊重同样是产品体验的核心。在人人都在加AI的时代,克制反而可能成为一种差异化的竞争力。
核心要点
相关推荐
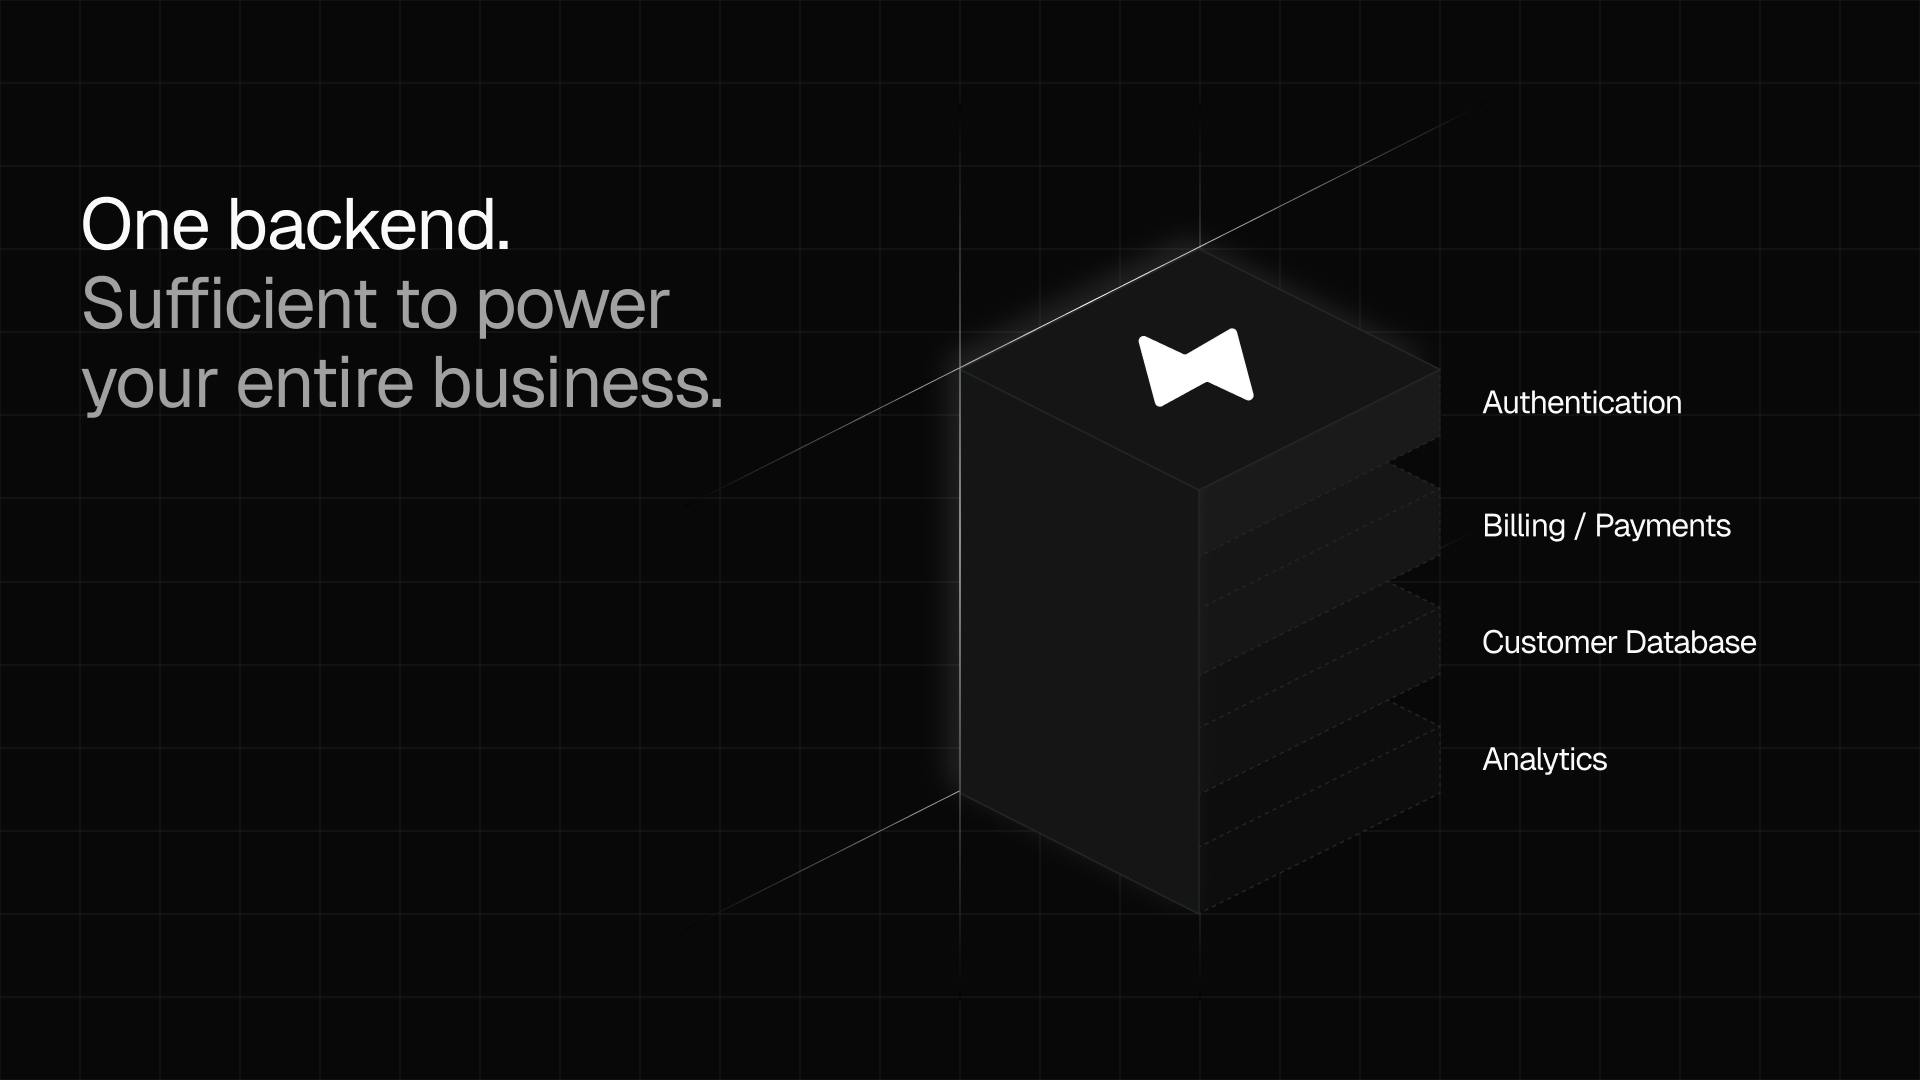
tiun.:为AI开发者打造的一站式认证与支付系统
登顶 Product Hunt 的 tiun. 为 AI 开发者提供认证、支付、账单、客户数据与分析的一体化系统,一条命令即可安装,帮助开发者当天上线付费产品。本文解析其定位、卖点与竞争格局。
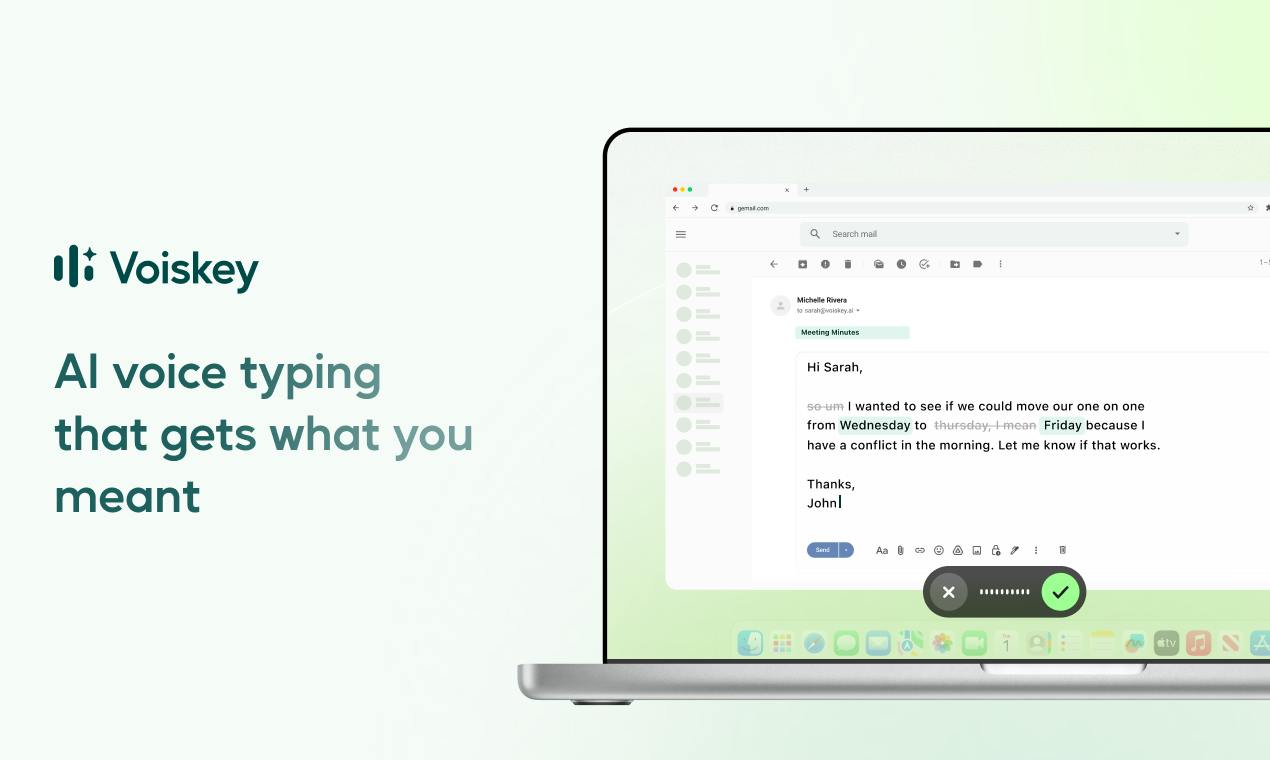
Voiskey:能读懂语境的AI语音输入工具
Voiskey是一款登上Product Hunt排名第3的AI语音输入工具,能根据场景和读者自动调整语气,比打字快5倍,支持iOS、macOS、Android、Windows四大平台及100多种语言。
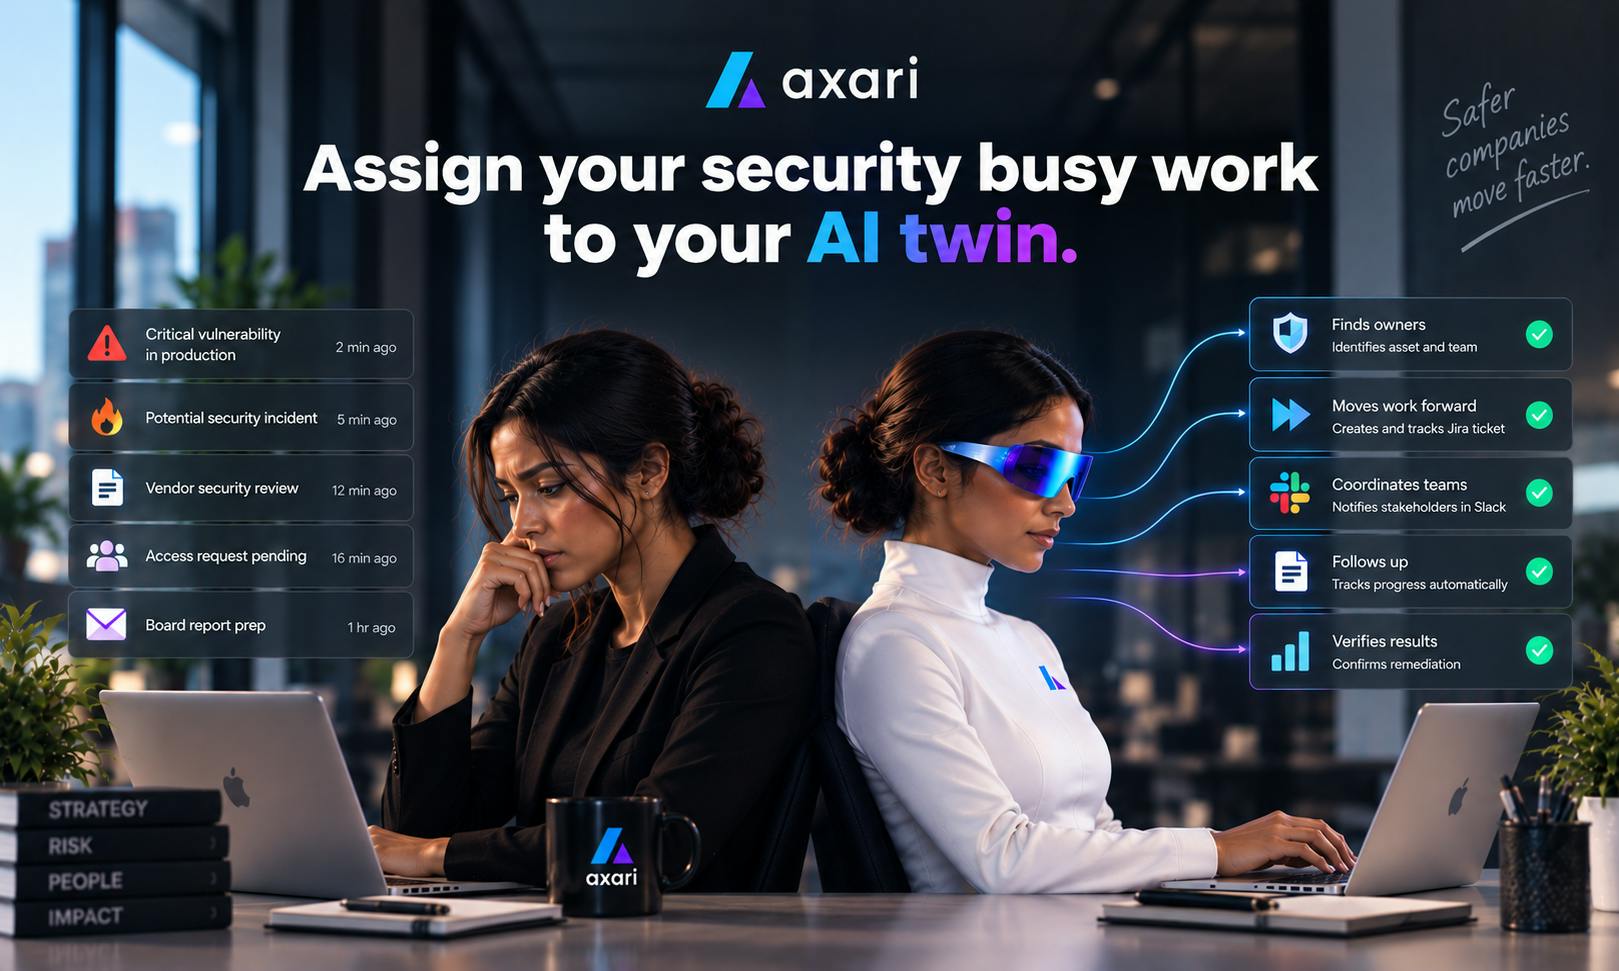
Axari:让AI分身接管你的安全运营琐事
Product Hunt新品Axari主打「AI分身」概念,帮安全团队自动处理重复性运营琐事,可在Slack、MS Teams中指派目标并自主推进任务。本文解析其产品逻辑、行业定位与需要冷静看待的问题。