AI模型提示词效果评估:本地vs API的科学选择方法

随着AI模型快速迭代,开发者面临实际难题:如何在本地模型和API服务间做出明智选择?通用benchmark已无法满足特定场景需求,本文分享提示词评估的实战方法论。
评估困境:通用基准的局限性
AI领域每周都有新模型发布,但通用基准测试(如MMLU、HumanEval)往往无法反映真实业务场景表现。MMLU(Massive Multitask Language Understanding)是一个包含57个学科领域的多选题测试集,涵盖从初等数学到专业法律的广泛知识;HumanEval则是OpenAI发布的代码生成基准,包含164个Python编程问题。这些基准在模型发布时被广泛引用,但其局限性日益明显。
通用基准测试的设计初衷是为了横向比较不同模型的综合能力,但它们存在三个根本性局限:第一,静态测试集容易被针对性优化,导致benchmark污染问题——模型在训练时可能已经见过测试数据。Benchmark污染(benchmark contamination)是当前LLM评估领域最受关注的挑战之一:由于现代LLM的训练语料通常来自互联网大规模爬取,而许多benchmark的测试题目早已公开发布在网上,数据泄漏几乎不可避免。2023年多项研究揭示了这一问题的严重性——部分模型在GSM8K数学基准上的真实能力与其公布分数存在显著落差。为应对这一挑战,社区开始推动动态基准(如LiveBench,每月更新测试题目)和私有测试集的使用,但这又带来了可复现性和透明度的矛盾。第二,多选题形式无法评估模型在开放式生成任务中的表现,而实际应用中90%以上是生成式任务;第三,这些基准忽略了提示工程的影响,同一模型在不同提示词策略下(如Few-shot示例、思维链引导)性能可能相差30%以上。
关于提示词策略的影响值得展开说明:Few-shot提示是指在提示词中包含若干输入-输出示例,帮助模型理解任务模式和期望格式,通常3-5个示例即可显著提升表现。思维链(Chain-of-Thought, CoT)由Google Brain团队在2022年提出,通过引导模型"逐步思考"来分解复杂推理任务,在数学推理和逻辑分析类任务上可将准确率提升10-40个百分点。这些提示工程技术意味着,模型的实际表现高度依赖于提示词的设计质量,同一模型在原始提示与精心设计的提示下可能展现出截然不同的能力水平,因此脱离具体提示词讨论模型性能毫无意义。
综上所述,MMLU得分85%的模型A在你的客服场景中表现可能不如得分78%但针对对话优化的模型B。
它们衡量的是模型的通用能力上限,而非在特定提示词模板、特定输出格式要求下的实际表现。例如,一个MMLU得分更高的模型在特定的JSON结构化输出任务中,表现可能不如得分较低的模型。
结构化输出是生产环境中的高频需求,用于将LLM集成到现有系统工作流。JSON输出任务要求模型不仅生成正确内容,还必须严格遵循Schema定义(字段名、数据类型、嵌套结构)。这种任务对模型的指令遵循能力(instruction-following)提出极高要求。研究表明,即使是顶级模型,在复杂嵌套JSON生成中的格式错误率也可达15-30%。OpenAI的Function Calling和Anthropic的Tool Use等特性通过在模型训练时加入结构化输出样本来缓解这一问题,但开源模型往往缺乏这类专项优化,需要通过更精细的提示工程或输出解析器(如LangChain的PydanticOutputParser、Instructor库等)来补救。近期Outlines、Guidance等受限解码(constrained decoding)工具的出现,允许在推理时强制模型输出符合特定语法或Schema的文本,从根本上解决了格式合规性问题,但可能以牺牲少量生成质量为代价。
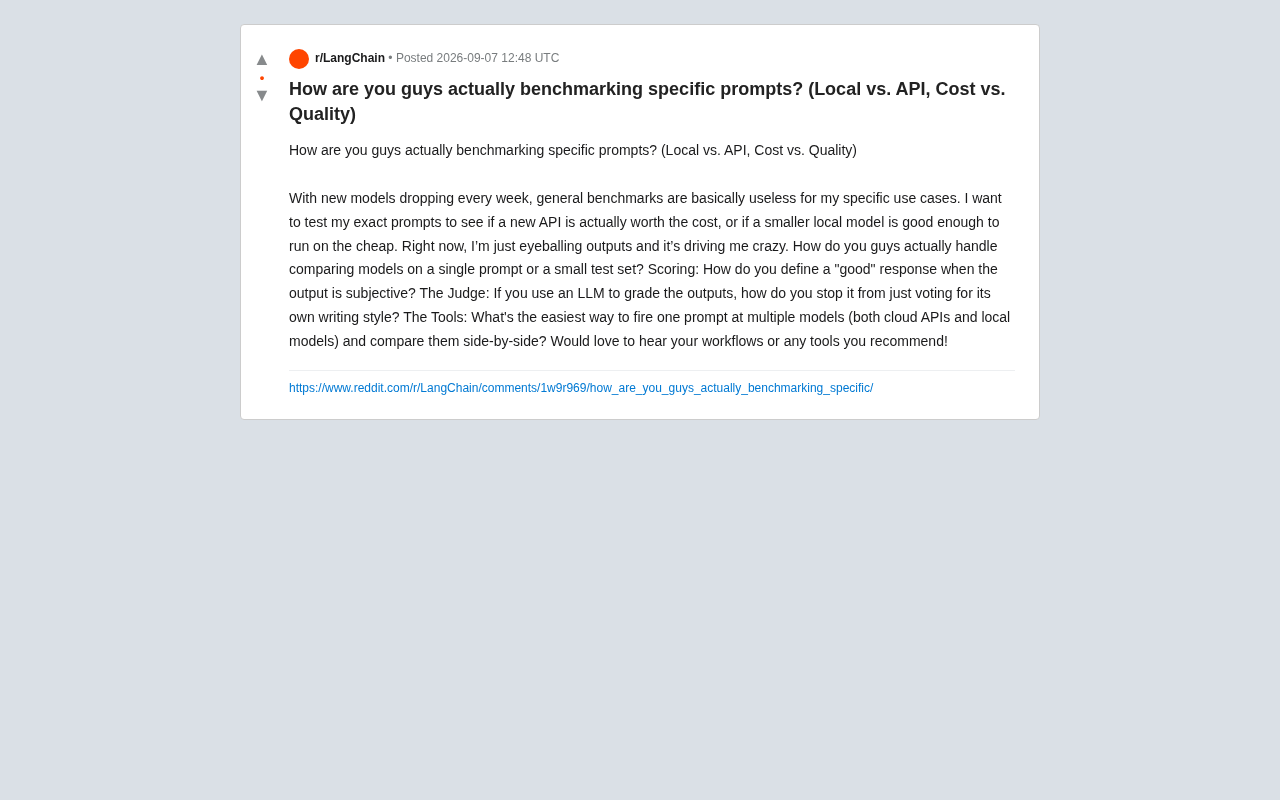
一位开发者在Reddit分享困扰:想测试具体提示词在不同模型上的表现,判断新API是否值得付费,或更小的本地模型能否满足需求。目前只能靠"肉眼观察"输出,这种方式既不科学也难以规模化。
这触及AI应用开发的核心矛盾:如何在成本、质量和部署方式间找到最优平衡点。
三大核心评估挑战
主观性评分难题
当输出结果具有主观性时,如何定义"好的回答"?不同应用场景对"好"的定义截然不同:客服对话需要共情能力,代码生成需要准确性,创意写作需要新颖性。建立适配业务的评分标准,是精准评估的前提。
实用方法包括:
- 定义多维度评分矩阵(准确性、完整性、风格一致性等),为每个维度设定权重
- 建立黄金标准测试集,包含已知的优质回答作为参照
- 引入人工抽样验证,定期校准自动化评估准确性
LLM-as-Judge的偏见问题
使用大语言模型评判其他模型输出已成常见做法,但存在明显偏见。LLM-as-Judge是2023年由UC Berkeley等机构在论文《Judging LLM-as-a-Judge》中系统性提出的评估范式。研究发现,GPT-4作为评委与人类专家的一致性超过80%,但同时存在位置偏见(倾向于选择排在前面的回答)、冗长偏见(偏好更长的回答)和自我增强偏见(偏好自己生成风格的内容)。这些偏见使得单一模型评委的结果可信度受限,业界因此发展出多评委投票、Elo评分系统等改进方案。值得注意的是,后续研究还发现了"权威偏见"——当评委模型被告知某个回答来自"更强"的模型时,即使回答质量相当,它也倾向于给出更高评分。这进一步印证了盲评机制的必要性。
Elo评分系统原本用于国际象棋选手排名,由匈牙利裔美国物理学教授Arpad Elo于1960年代提出,现被引入LLM评估领域。其核心思想是通过两两对比(pairwise comparison)来计算相对强度:让两个模型回答同一问题,由评委判断哪个更好,然后根据胜负结果更新Elo分数。每次对比的分数变化取决于双方的当前评分差——一个低分模型击败高分模型会获得更多分数增长,反之则变化较小。Chatbot Arena是这一方法的代表性实践,由UC Berkeley的LMSYS团队运营,通过数百万次匿名人类投票建立模型排行榜,已成为业界公认的模型能力风向标。相比单次绝对评分,Elo系统的优势在于:降低评分标准不一致的影响、能捕捉细微差异、对新模型只需少量对比即可定位其水平。但缺点是需要大量样本才能收敛到稳定排名(通常需要数千次对比),且无法直接反映具体能力维度(如代码生成vs创意写作),因此Chatbot Arena后续推出了分领域排行榜作为补充。
缓解策略包括:
- 使用多个不同架构的模型作为评委进行交叉验证
- 设计无关风格的评分标准(如事实准确性、逻辑连贯性)而非主观偏好
- 采用"盲评"机制,隐藏模型来源信息
- 定期用人工评估校准模型评委的准确性
多模型并行测试的工程挑战
如何高效地将同一提示词发送给多个模型(包括云端API和本地部署模型),并进行横向对比?这涉及API调用、本地推理环境、结果收集和可视化等多个环节。不同模型提供商的API格式、认证方式、速率限制和错误处理机制各不相同,构建一个统一的测试编排层本身就是一项不小的工程投入。此外,本地模型的推理速度高度依赖硬件配置(GPU显存、计算能力),测试结果中的延迟指标需要区分模型本身的推理效率和硬件环境的差异。还需注意的是,不同模型对相同概念使用不同的参数命名(如temperature、top_p的默认值和行为可能略有不同),甚至tokenizer的差异也会影响输入长度计算和成本估算,这些细节在横向对比时需要格外注意。
实战工具与评估工作流
推荐工具链
目前已有工具可简化评估流程:
PromptFoo:开源提示词测试框架,支持多种模型提供商,可自动化运行测试集并生成对比报告。PromptFoo采用YAML配置文件定义测试用例,支持断言式验证(如检查输出是否包含特定关键词、是否符合JSON Schema、是否通过自定义函数校验等),并可集成到CI/CD流水线中实现提示词的回归测试。CI/CD(持续集成/持续部署)是软件工程中的核心实践,指代码变更后自动触发构建、测试和部署流程。将这一理念应用于提示词管理意味着:每次修改提示词模板后,系统自动运行预定义的测试用例集,验证输出质量未发生退化(回归)。这在实际生产中至关重要——一个看似微小的提示词措辞调整可能导致某类边界输入的输出质量大幅下降。PromptFoo支持与GitHub Actions、GitLab CI等流水线工具集成,使提示词像代码一样接受版本控制和自动化测试,这是提示词工程走向工程化成熟度的关键一步。PromptFoo原生支持OpenAI、Anthropic、Google、本地Ollama等数十种模型后端,使得从定义测试到获取对比结果的整个流程可以在几分钟内完成。
LangSmith:LangChain生态的评估平台,提供数据集管理、自动评估和可视化对比功能。作为LangChain框架的配套观测工具,LangSmith不仅支持评估,还提供完整的LLM应用调试和监控能力,包括调用链追踪、Token用量统计和成本核算,适合已在使用LangChain构建应用的团队。
MLOps(Machine Learning Operations)是将DevOps实践应用于机器学习系统的方法论,但LLM应用有其独特挑战。传统ML模型的版本管理关注模型权重文件,而LLM应用还需管理提示词模板、Few-shot示例库、检索增强(RAG)的知识库版本等多个动态组件。检索增强生成(RAG)是当前LLM应用最主流的架构模式之一,其核心思想是在模型生成回答前,先从外部知识库中检索与用户查询相关的文档片段,将其作为上下文注入提示词,从而让模型基于最新、准确的信息回答问题。RAG有效缓解了LLM的知识截止日期限制和幻觉问题,被广泛应用于企业知识问答和文档分析等场景,但它也使得系统评估更为复杂——不仅要评估生成质量,还需评估检索环节的召回率和精确率。
监控维度也不同于传统ML:除了推理延迟和错误率,还需追踪Token用量(直接关联成本)、输出内容安全性、幻觉率等LLM特有指标。此外,LLM的不确定性使得A/B测试更复杂——相同输入可能产生不同输出(由temperature等采样参数控制),需要更大样本量才能得出统计显著结论。因此,LLM应用的MLOps需要专门工具链支持,如LangSmith、Weights & Biases for LLMs等。
OpenRouter:统一的API网关,通过单一接口访问多个模型提供商,简化多模型测试。OpenRouter解决了多模型测试中的一个关键工程痛点:开发者只需维护一套API调用代码,即可在数百个模型间自由切换。它还提供实时的模型定价比较和可用性监控,这对成本敏感的评估场景尤其有价值。类似的聚合服务还包括LiteLLM等开源方案,后者可以自托管部署,更适合对数据流转有严格控制要求的企业。OpenRouter和LiteLLM都遵循OpenAI API兼容格式,这意味着现有基于OpenAI SDK编写的代码几乎无需修改即可切换到其他模型提供商,极大降低了多模型评估的开发成本。
Ollama + Open WebUI:本地模型管理方案,便于在本地环境快速切换和测试不同模型。Ollama将模型的下载、量化版本管理和推理服务封装为简洁的命令行操作(如ollama run llama3即可下载并启动推理),而Open WebUI则提供了类似ChatGPT的图形界面,支持多模型并排对比。对于需要在本地评估开源模型(如Llama、Mistral、Qwen系列)的开发者而言,这一组合是入门门槛最低的方案。Ollama底层使用llama.cpp推理引擎,支持GGUF格式的量化模型,在Apple Silicon Mac上还能利用Metal GPU加速,使得在笔记本电脑上运行7B-14B参数模型成为轻松可行的事情。
科学评估工作流
典型评估流程包含以下步骤:
- 构建测试集:收集20-100个代表性输入,涵盖边界情况和常见场景。测试集的质量直接决定评估结论的可靠性,建议从真实用户交互日志中提取样本,并确保覆盖长尾场景(如多语言输入、模糊指令、对抗性提示等)。测试集的规模需要平衡统计显著性和评估成本:20个用例是最小可行规模,适合快速筛选;50-100个用例可以覆盖大多数业务场景;对于关键业务系统,建议扩展到200+用例并按场景类别分层抽样。
- 定义评估标准:根据业务需求设定可量化指标(如准确率、延迟、成本)
- 批量运行:使用自动化工具并行测试所有目标模型
- 多维度评估:结合自动评分(LLM评判+规则)和人工抽样。自动评分通常包括两类:基于规则的硬性检查(如JSON格式是否合法、是否包含禁止内容、输出长度是否在范围内)和基于LLM的软性评判(如回答的相关性、完整性、语气适当性)。建议对LLM评分结果进行至少10-20%的人工抽样校验,计算人机一致性(Cohen's Kappa系数),当一致性低于0.6时需要重新调整评分标准。
- 成本收益分析:计算每个模型的性能/成本比,考虑API费用或硬件成本
- 持续迭代:随业务场景变化,定期更新测试集和评估标准。模型提供商频繁更新模型版本(有时甚至是静默更新,即在不变更版本号的情况下调整模型行为),这意味着上个月的最优选择可能在本月不再成立,将评估流程自动化并定期执行(建议至少每月一次,或在模型版本更新后立即触发)是保持决策时效性的关键。
成本与质量的权衡艺术
选择本地模型还是API服务,不只是技术问题,更是商业决策。需综合考虑:
性能要求:任务复杂度是否需要顶级模型?还是中等模型已能满足需求?实践中,许多生产场景(如文本分类、实体提取、简单摘要)使用参数量较小的模型(7B-14B级别)即可达到与顶级API相当的效果,尤其是在经过针对性微调之后。模型微调(Fine-tuning)技术的进步使这一策略更加可行:现代高效微调方法如LoRA(Low-Rank Adaptation)仅需更新原始参数量的0.1%-1%即可达到接近全参微调的效果,而QLoRA更进一步,支持在4-bit量化模型上进行LoRA微调,使得在单张消费级GPU上微调大模型成为可能。这意味着一个经过领域微调的7B模型,在特定任务上可能超越通用的70B模型,而成本仅为后者的十分之一。
延迟敏感度:实时应用可能需要本地部署以降低网络延迟。API调用通常涉及100-500毫秒的网络往返时间,而本地推理可将端到端延迟控制在几十毫秒级别。在流式输出场景下,首token延迟(Time to First Token, TTFT)比总生成时间更能影响用户体验——流式输出是指LLM在生成过程中逐token将内容发送给客户端,而非等待完整回答生成后一次性返回。本地部署的TTFT通常在10-50ms,而API调用受网络延迟影响,TTFT可能达到200-800ms。对于聊天机器人的实时对话体验和内容审核等场景,这一差异直接影响用户满意度和系统可用性。
数据隐私:敏感数据可能无法发送到外部API。在医疗、金融、法律等受监管行业,数据合规要求(如GDPR、HIPAA、中国《数据安全法》和《个人信息保护法》)可能明确禁止将用户数据传输至第三方服务器,此时本地部署或私有云部署成为唯一选项。即使在非强监管行业,将客户对话、内部文档等敏感信息发送到外部API也可能带来商业风险,需在合同和技术层面进行充分的安全评估。
规模效应:请求量达到一定规模后,本地部署的总体成本可能更低。业界通常使用"盈亏平衡点"来量化这一决策:假设本地部署一台配备高端GPU(如NVIDIA A100)的服务器月成本约为2000-5000美元(含硬件折旧、电力和运维),而API调用按token计费(如GPT-4o约每百万输入token 2.5美元)。当月请求量超过一定阈值时,本地部署的单次请求边际成本趋近于零,总体成本将低于API方案。
盈亏平衡点分析需考虑多项成本因素。本地部署的固定成本包括:硬件采购(高端GPU服务器5-15万元)、机房托管或云服务器租赁(月均3000-8000元)、电力消耗(单卡A100功耗400W,按工业电价月成本约300元)。可变成本主要是运维人力(至少0.5个FTE)。API方案的成本则完全按用量计费:GPT-4o输入token约0.017元/千token,输出约0.05元/千token。假设业务场景平均每次请求2000输入token+500输出token,单次成本约0.06元。当月请求量超过100万次时(月成本6万元),本地方案的总成本优势开始显现。但这一阈值因模型选择、硬件配置和运维效率差异较大,需根据实际情况建模计算。值得注意的是,选择本地部署开源模型而非复刻顶级闭源API的能力,意味着可以使用更小的模型(如Llama 3 8B替代GPT-4o),进一步大幅降低硬件门槛和盈亏平衡点。
此外,量化技术(如GGUF、GPTQ、AWQ)使得70B参数的模型可以在消费级GPU上运行,进一步降低了本地部署门槛。量化技术通过降低模型参数的数值精度(如从FP16降至INT8或INT4)来压缩模型体积和推理显存需求,同时尽量保持性能。GGUF(GPT-Generated Unified Format)是llama.cpp项目推出的量化格式,支持从Q2到Q8多种精度级别,其独特优势是支持CPU+GPU混合推理,即使GPU显存不足以加载完整模型,也可将部分层卸载到CPU运行;GPTQ针对大模型设计,通过逐层量化和二阶信息最小化精度损失,是最早广泛应用的大模型量化方案;AWQ(Activation-aware Weight Quantization)则根据激活值重要性选择性量化权重,在同等量化精度下通常保持更好的性能。实践表明,4-bit量化可将70B模型的显存需求从140GB降至40GB左右,在消费级RTX 4090(24GB显存)上通过部分层卸载到CPU即可运行,且在多数任务上性能仅下降3-7%。这使得本地部署的硬件门槛从数万美元的企业级GPU降至数千美元的消费级显卡。
维护成本:本地部署需要投入运维资源,而API服务则按需付费。本地方案的隐性成本包括GPU驱动更新、模型版本管理、服务监控告警、故障恢复机制等,这些都需要专业的MLOps工程能力支撑。此外,开源模型的更新速度极快(Meta的Llama系列几乎每季度一个大版本),评估和迁移到新版本模型本身也需要投入时间和精力。对于团队规模较小或缺乏MLOps经验的团队而言,API服务的"零运维"特性往往比看似更低的计算成本更有价值。
通过科学的评估方法,可为每个具体场景找到最优解,而不是盲目追求最新或最大的模型。在AI应用开发中,"够用"往往比"最好"更重要。一个系统化的评估框架不仅帮助做出当下的最优决策,更重要的是建立起持续监控和迭代的能力——在这个模型每月都在进化的时代,评估能力本身就是核心竞争力。
核心要点
- 通用基准测试存在数据污染、题型局限和忽略提示工程影响三大根本性问题,无法替代针对具体业务场景的自定义评估
- 主观性评分、LLM评委偏见和多模型并行测试是三大核心评估挑战,需通过多维评分矩阵、多评委交叉验证和统一测试编排层来应对
- PromptFoo、LangSmith、OpenRouter和Ollama等工具链可显著降低评估工程复杂度,使提示词评估融入CI/CD流程
- 本地部署vs API服务的选择是综合性商业决策,需从性能、延迟、隐私、规模效应和维护成本五个维度进行盈亏平衡分析
- 量化技术和高效微调方法的进步,使得小模型在特定任务上达到大模型水平成为可能,大幅拓宽了本地部署的适用场景
- 在模型快速迭代的时代,建立可自动化、可持续执行的评估体系比一次性选择"最好的模型"更具战略价值
相关推荐

LangGraph入门指南:AI Agent的操作系统全解析
LangGraph 被称为 AI Agent 的操作系统,本文系统梳理其与 LangChain 的关系、状态节点边三大要素、持久化 checkpoint、human-in-the-loop 及子图等核心能力与学习路径。

吴恩达谈Agentic AI:拨开炒作看智能体构建的核心技能
吴恩达 Agentic AI 课程开讲,剖析智能体炒作背后的真实价值。从客户支持、法律文档到医疗诊断的落地场景,揭示评估与错误分析为何是构建智能体工作流的核心技能。

吴恩达谈Agentic AI:构建智能体应用的核心方法论
吴恩达 Agentic AI 课程深度解读:从术语被过度炒作说起,剖析智能体工作流在客户支持、深度研究、法律与医疗诊断中的真实应用,并揭示优秀开发者依靠评估(Evals)与错误分析的纪律化开发流程这一核心方法论。