如何量化评估Agent系统工程质量?六维度评估体系全解析
Agent系统工程质量不能只看成功率,需从六维度、四层评估器和发布门禁体系综合衡量。
本文从一道常见面试题切入,揭示"看成功率"这一直觉答案的根本缺陷:Agent是非确定性决策系统,单一指标无法反映真实工程质量。作者将工程质量拆解为效果、过程、可靠性、成本、可观测性和安全六个维度,并提出以"每成功任务成本"作为北极星指标,配合任务成功率、Pass@1、P95时延等六个过程指标。测量层面,文章给出确定性校验→规则启发式→LLM裁判→人工仲裁的四层评估器体系,确保数据可信。最终,所有指标要被嵌入"离线回归→影子模式→灰度发布→失败沉淀"的发布门禁流程,形成持续改进的飞轮。文章以三个自检问题收尾,定义高工程质量的本质是:每一次犯错都可控、可查、可改。
为什么"看成功率"这个直觉答案会失灵
一个高频面试题足以让不少候选人当场卡壳:抛开底层模型能力,你怎么量化评价一个 Agent 系统的工程质量?直觉的答案往往是——看成功率,任务跑通的比例,再配上用户反馈。但面试官只需追问三层,这个答案就会崩塌:成功率报表很好看,业务指标却纹丝不动怎么解释?模型有随机性,同一个任务跑两次结果不同,你的成功率还可信吗?线上出了故障,你能在十分钟内把 Agent 的每一步都回放出来,说清楚是模型、工具还是编排的锅吗?
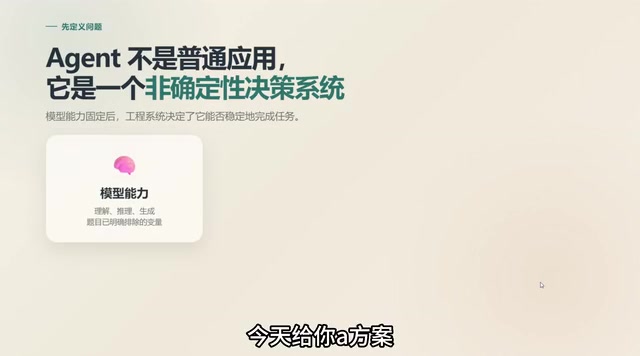
问题的根源不在候选人,而在于评估 Agent 系统本身就不是"一个数能达完"的事。传统软件是确定性的:相同输入永远得到相同输出。而 Agent 本质上是一个非确定性决策系统——同一个问题今天给你 A 方案,明天可能给 B 方案。
这里有一个关键等式:用户真正感知到的质量 = 模型能力(理解、推理、生成)+ 系统工程(编排、工具、记忆、权限、观测、测试、恢复机制)。既然面试题已经把模型能力这一块排除掉了,那剩下的全部变量都压在系统工程这一侧。衡量的重点从来不是它某一次多聪明,而是它能不能稳定可控地把结果交付出来。
衡量工程质量的六个维度
把"稳定可控"拆开,可以得到六个不可或缺的维度:
效果质量——任务最终有没有正确完成、是否满足用户约束。这是根,但光看结果不够,结果对也可能是"瞎猫碰上死耗子"。
过程质量——工具选得对不对、路径顺不顺、出错能不能自己纠正收敛。
可靠性——面对异常、超长任务、环境突变,系统能不能自己恢复。
效率与成本——Agent 每走一步都在花钱,每一次成功背后烧了多少时间、多少 token、多少工具费用,账必须算清。
剩下两个维度最容易被漏掉:可观测性(一次失败能不能完整回放、定位、归因)和安全与治理(权限、敏感数据、高风险动作是否始终可控)。
一句话总结:六个维度缺一个,你看到的质量都可能是虚高的。
北极星指标与六个过程指标
有了维度,还要顶上具体的数。第一条原则——别只看成功率,更要看成功的代价。
这里推荐一个北极星指标:每成功任务成本(Cost per Success),公式很朴素,总成本除以成功任务数。
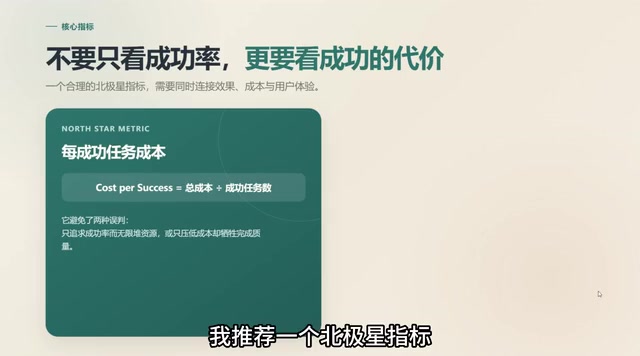
它之所以能当北极星,是因为它对两个极端具有"一票否决"的能力:只冲成功率就会疯狂堆资源,只抠成本就会牺牲质量。把效果和成本绑在同一个指标里,报表就不容易骗人了。
北极星之下再配六个过程指标:
- 任务成功率:成功必须是可验证的业务终态——数据库真写了、文件真落地了,而不是模型嘴上说"完成了"。
- Pass@1:首次尝试就成功,比允许反复重试后的成功率更贴近真实体验。
- P95 端到端时延:看长尾,而且要把模型耗时和工具耗时分开拆,才知道时间耗在哪。
- 无干预达成率:全程不需要人接管,这才是真正的自动化。
- 工具调用有效率:专门抓无效循环、参数反复报错这类毛病。
- 恢复成功率:工具挂了、环境异常了,它能不能自己爬回来把任务干完。
Pass@k 是评估语言模型代码生成能力时提出的标准化指标,由 OpenAI 在 HumanEval 基准测试中引入,后来被广泛借用到 Agent 评估领域。Pass@1 表示模型在单次采样时就生成正确结果的概率,Pass@k 则表示在 k 次采样中至少有一次正确的概率。两者的差距直接反映了系统的稳定性:Pass@1 低而 Pass@10 高,意味着系统需要"多跑几次靠运气"才能成功,在生产环境中这通常是不可接受的。文章强调 Pass@1 比"允许反复重试后的成功率"更贴近真实体验,正是因为终端用户往往只有一次耐心,而不是在后台悄悄重试十次后才拿到结果。
四层评估器:让测出来的数变得可信
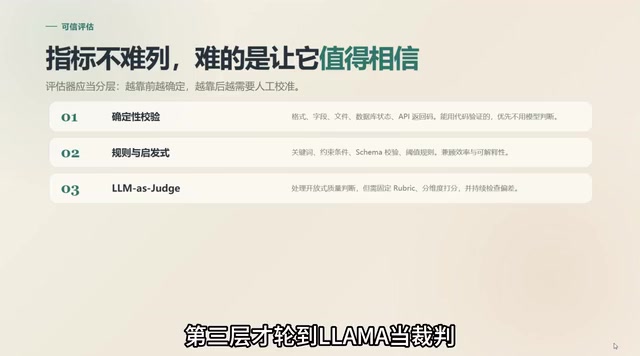
指标有了还不够——你测出来的数可信吗?这正是面试第二个追问挖的坑。解法是一套四层评估器,原则是越靠前越确定,越靠后越要人工兜底。
第一层 确定性校验:格式、字段、文件、数据库状态、API 返回码,凡是能用代码验证的,坚决别用模型判断——又快又稳还好调试。
第二层 规则与启发式:关键词约束检查、Schema 校验、预执行规则,兼顾效率与可解释性。
第三层 LLM 当裁判:才轮到处理开放式质量判断,但要守两条纪律:一是固定评分标准,一个维度配一个判定器,别拿一个大 prompt 评所有维度;二是持续检查它有没有偏好偏差。
第四层 人工仲裁:抽样复核争议样本,用来校准评估器与真实标准的一致性。
此外还有个"双轨原则":既要看结果对不对,也要看路径好不好。结果帮你判断价值,路径帮你定位问题、做修复。
LLM-as-a-Judge(用LLM充当裁判) 是近年来 Agent 评估体系中被广泛采用的技术方案。其核心思路是:当任务输出无法用硬规则判定正确性时,用一个独立的语言模型来打分或做二元判断。常见实现是构造一个 Evaluator Prompt,将任务描述、预期标准和实际输出一并传入,让裁判模型输出评分及理由。这套方法的优势在于能处理自然语言层面的"合理性",但也存在几个已知缺陷:位置偏差(倾向于给先出现的选项打高分)、冗长偏差(更长的回答往往得分更高)、自我强化偏差(同款模型裁判同款模型输出时评分虚高)。因此在第三层 LLM 裁判中,强调"一个维度配一个判定器"和"持续检查偏好偏差",正是针对这些已知失效模式的工程防护。
把评估变成发布门禁
一堆指标怎么真正用起来?一句话——把评估变成发布门禁,而不是躺在文档里的报告。每一次改提示词、升级工具、调整工作流、换模型版本,统统走同一条质量管线,四个闸门层层把关:
- 离线回归:一个黄金测试集,覆盖核心流程、历史故障、边界场景。这关跑不通什么都别上。
- 影子模式:在真实流量旁路跑,不碰真实用户,只干一件事——比较新旧两条轨迹的差异。
- 灰度发布:放一小部分真实流量,盯四个仪表盘(成功率、干预率、延迟、成本),达标才允许全量。
- 全量与失败沉淀:最关键的一步,全量阶段产生的线上失败绝不能丢,要持续沉淀成下一轮回归资产。
线上失败 → 人工归因 → 沉淀 bad case 进回归集 → 修复验证,这条飞轮转得越快,工程质量越高。
影子模式(Shadow Mode) 是一种流量镜像测试技术,源自金融和通信行业的系统切换实践,近年在 ML 系统部署中被大量采用。其工作原理是:生产系统正常响应用户请求,同时将相同的输入并行发送给候选版本,候选版本完整执行但结果不返回给用户、不产生任何副作用。对于 Agent 系统,这意味着新版工作流会在真实请求上跑完整个决策和工具调用链路,但所有写操作(数据库写入、文件创建、外部 API 调用)必须被拦截或导向沙箱环境,否则会造成数据污染。影子模式的价值在于它能暴露仅在真实流量分布下才会出现的长尾问题,这是离线测试集难以覆盖的。
四个最常见的坑
做 Agent 的同学多少都踩过这些坑:
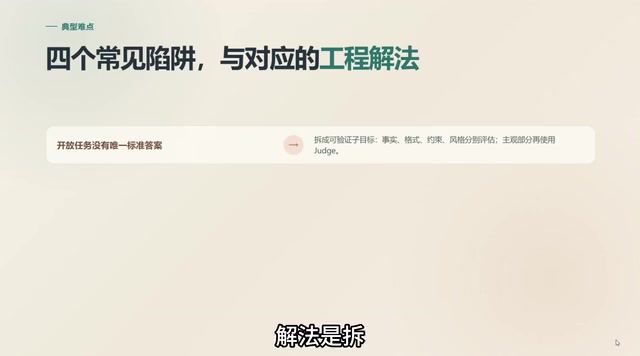
坑一:开放任务没有唯一标准。 比如"写段好文案"怎么判对错?解法是拆——拆成可验证的子目标,事实、格式、约束、风格分开判,能自动判的用代码,主观部分才交给模型裁判。
坑二:同一任务跑两次结果不一样。 解法很朴素——评估时固定模型版本和采样参数,多次运行报告均值、分位数、置信区间,只报单个分数没人信。
坑三:成功率涨了,业务体验却没变好。 这说明你被代理指标骗了。解法是回到业务终态,看无干预达成率、每成功任务成本、用户完成时长这些硬通货。
坑四:外部环境一直变。 工具商悄悄改个 Schema,Agent 就静默退化了。解法是给工具做契约校验、注入异常做压力测试、定时巡检,工具一变更就自动触发关键链路回归。
高工程质量的真正定义
回头看开场那场面试,候选人缺的不是聪明,而是一套系统。真正的回答应该是:
高工程质量不是 Agent 从不犯错——非确定性系统不可能不犯错。高工程质量是每一次犯错都可控、可查、可改。
说到底,评价一个 Agent 系统的工程质量,本质是在评价一件事:这个团队有没有持续改进一个非确定性系统的能力。
最后送你三个自检问题:第一,今天这个系统能不能用,你能拿出一组可信的数吗?第二,出了问题能不能快速回放、归因到具体某一层?第三,每一次失败是不是都变成了明天回归集里的一道题?三个都能答"是",这个 Agent 系统的工程质量就是过硬的。
相关推荐
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。