如何用Mock网关解决LangChain智能体的工具Schema幻觉难题
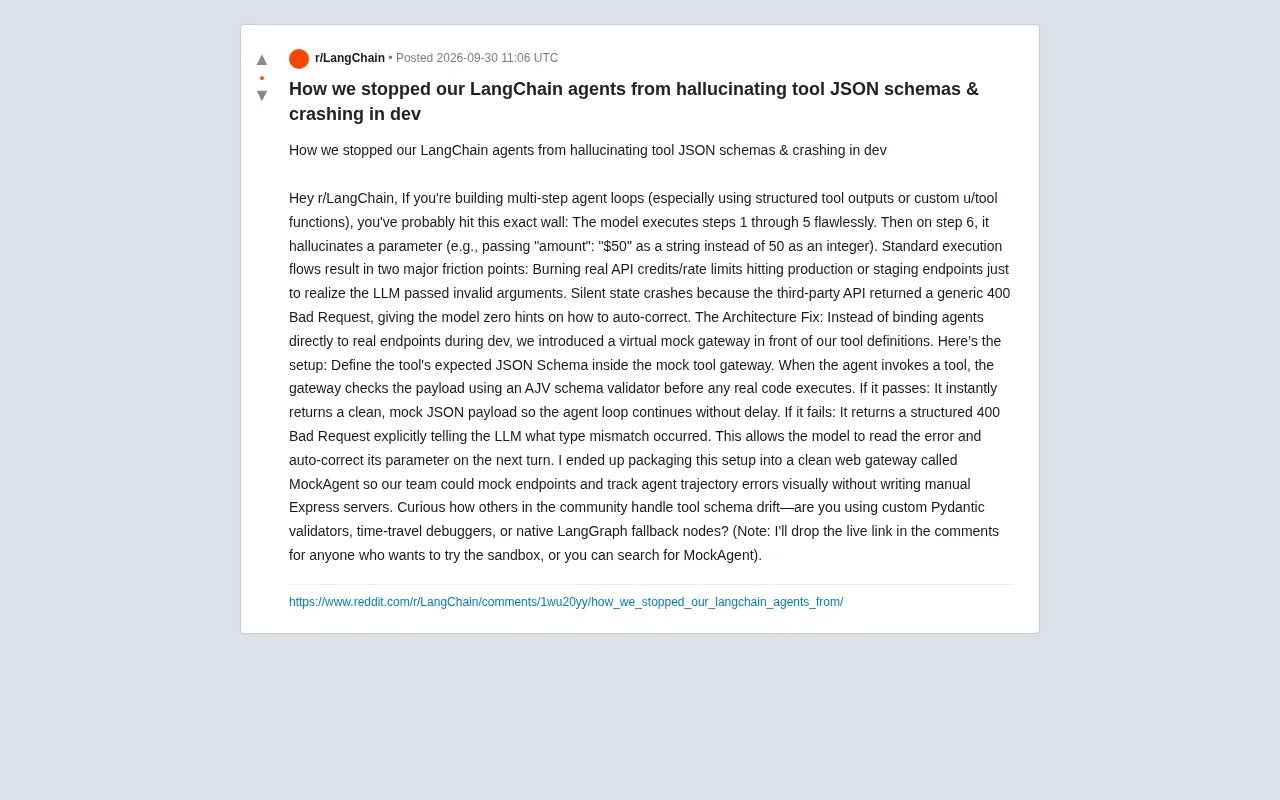
在LangChain智能体工具调用前插入Mock网关,通过AJV前置Schema校验与结构化错误反馈消除参数幻觉。
多步骤智能体在工具调用时容易出现JSON Schema参数幻觉——模型生成的参数类型、格式与工具定义不符,导致真实API调用失败、额度浪费,且通用400错误让模型无法自我纠错。针对这一痛点,一位LangChain社区开发者提出了「虚拟Mock网关」架构:在开发阶段于工具前置一层网关,用AJV校验器在任何真实代码执行前验证payload;校验通过则返回干净的mock响应,失败则返回结构化错误,精确告知LLM哪个字段类型不匹配。这一设计将原本导致崩溃的错误转化为模型可读取并自动修正的反馈信号,从而降低开发成本、加速调试、提升智能体自愈能力。该方案已被打包为MockAgent工具,并可与Pydantic校验器、LangGraph fallback节点等社区方案组合使用。
构建多步骤智能体循环的开发者大多遇到过这样的场景:模型顺利执行了前五个步骤,却在第六步突然「翻车」——它幻觉出一个错误的参数类型,比如把本应是整数 50 的金额字段传成了字符串 "$50"。这类工具调用的 Schema 漂移(tool schema drift)问题,正在成为智能体开发中隐蔽却高频的痛点。一位 Reddit 用户在 r/LangChain 社区分享了他们团队的架构解决方案,值得深入拆解。
问题的根源:工具调用中的参数幻觉
当智能体使用结构化工具输出或自定义 @tool 函数时,LLM 生成的调用参数并不总是符合工具定义的 JSON Schema。模型可能在类型、格式甚至字段命名上出现偏差,而这些错误往往要到真正命中 API 端点时才会暴露。
原帖作者指出,这带来了两个核心摩擦点:
第一是成本与限流的浪费。在开发或预发布环境中,智能体直接绑定真实端点意味着每一次错误调用都在消耗真实的 API 额度,或者触发速率限制——而这一切仅仅是为了发现「LLM 传了个无效参数」。
第二是静默的状态崩溃。第三方 API 通常只返回一个笼统的 400 Bad Request,这对模型的自我纠错毫无帮助。智能体拿到这样一个没有任何细节的错误,根本无法判断哪个参数出了问题、该如何调整,于是整个 agent loop 陷入停滞或反复失败。
JSON Schema 是一种用于描述和验证 JSON 数据结构的声明式规范,通过定义字段名称、数据类型(string、integer、boolean 等)、必填项及格式约束,来规定合法的数据形态。在 LangChain 等智能体框架中,工具(tool)的参数接口通常以 JSON Schema 的形式暴露给 LLM,模型需要根据这份「契约」生成符合格式的调用参数。Schema 漂移(schema drift)指的是模型实际生成的参数偏离了这份契约——这并非模型对工具功能的误解,而是对结构规范的不精确遵守。由于 LLM 本质上是概率性文本生成器,在长上下文或多轮对话中,参数类型的细微偏差(如整数变字符串、嵌套字段缺失)会随步骤累积而愈发常见,这正是多步骤 agent loop 比单次调用更脆弱的根本原因。
架构方案:在工具前加一层虚拟 Mock 网关
作者提出的核心思路是:在开发阶段,不要让智能体直接绑定真实端点,而是在工具定义前引入一个虚拟 Mock 网关(virtual mock gateway)。这个网关承担了「守门人」的角色,具体流程如下:
校验先行,执行在后
- 在 Mock 工具网关内部预先定义好每个工具期望的 JSON Schema;
- 当智能体调用某个工具时,网关先用 AJV Schema 校验器检查 payload,在任何真实代码执行之前完成验证;
- 若校验通过,网关立即返回一个干净的 mock JSON 响应,让智能体循环无延迟地继续下去;
- 若校验失败,网关返回一个结构化的 400 错误,明确告诉 LLM 是哪种类型不匹配。
这个设计最巧妙的地方在于错误反馈的「可读性」。传统的通用 400 错误对模型是黑盒,而结构化错误相当于给模型递上了一张纠错提示卡,让它能在下一轮对话中读取错误信息并自动修正参数。这把原本会导致崩溃的失败,转化成了智能体自我迭代的机会。
AJV(Another JSON Validator) 是 JavaScript/Node.js 生态中最广泛使用的 JSON Schema 校验库,以高性能和对 JSON Schema 规范的完整支持著称。它能够将 JSON Schema 编译为优化后的校验函数,在毫秒级时间内完成对任意 JSON payload 的类型、格式、枚举值、必填字段等全方位检查,并生成详细的错误报告,精确指出是哪个字段、哪种约束发生了违反。在 Mock 网关场景中,AJV 充当了智能体与真实工具之间的「类型守卫」——其生成的错误信息(例如 "$.amount" should be integer, got string)足够结构化和语义化,可以直接被 LLM 作为上下文读取,从而在下一轮推理中定向修正参数,而无需人工介入。
从架构到工具化
作者进一步把这套设置打包成了一个名为 MockAgent 的 Web 网关工具,让团队无需手写 Express 服务器就能 mock 端点,并以可视化方式追踪智能体的轨迹错误(agent trajectory errors)。对于需要频繁调试多步骤智能体的团队来说,可视化的轨迹追踪能显著降低定位问题的成本。
智能体轨迹(agent trajectory) 指的是一个 agent loop 从起始状态到终止状态所经历的完整动作序列,包括每一步的推理输出、工具调用参数、工具返回结果及状态变更。在多步骤智能体中,单步错误往往会通过状态传递「污染」后续步骤,导致最终失败的根因与表面现象相距甚远。可视化轨迹追踪工具能将这条执行链以时间线或图结构呈现,让开发者直观看到在第几步、调用哪个工具时参数开始出现偏差,从而将调试时间从「大海捞针」缩短为精准定位。LangSmith、LangFuse 等社区工具也提供了类似的轨迹可观测性能力,是生产级智能体调试的重要基础设施。
这套方案的价值与边界
从工程实践角度看,这个方案的本质是把「Schema 校验」从运行时后置的隐性检查,前移成了开发时显性的、可反馈的环节。它带来的直接收益是:降低开发阶段的 API 成本、加快 agent loop 的调试速度、提升模型的自愈能力。
不过需要理性看待其适用范围。Mock 网关主要解决的是开发与预发布环境下的 Schema 漂移问题,返回的是模拟数据而非真实业务响应,因此无法覆盖真实 API 的语义正确性和业务逻辑验证。它是调试链路的补充,而非生产环境的替代。
社区还有哪些解法
原帖也向社区抛出了一个开放性问题:大家还在用哪些方式应对工具 Schema 漂移?作者列举了几种常见思路:
- 自定义 Pydantic 校验器:在 Python 生态中用 Pydantic 模型对工具参数做强类型约束,是相当主流的做法;
- 时间旅行调试器(time-travel debuggers):允许回放智能体的执行轨迹,便于复现和定位错误;
- 原生 LangGraph fallback 节点:利用 LangGraph 的图结构在校验失败时路由到降级或重试逻辑。
这几种方案各有侧重:Pydantic 强调类型层面的静态约束,LangGraph fallback 强调流程层面的容错编排,而 Mock 网关则介于两者之间,专注于「校验 + 结构化反馈」的闭环。在实际项目中,它们并不互斥,完全可以组合使用。
小结
工具 Schema 幻觉是智能体系统走向可靠的一道必经关卡。这位 Reddit 开发者的方案提供了一个清晰的思路:与其在真实端点上试错,不如在工具前架一层能校验、能反馈的 Mock 网关,让模型在受控环境中学会自我纠正。对于正在构建生产级智能体的团队而言,无论是否采用 MockAgent 这个具体工具,「前置校验 + 结构化错误反馈」的设计模式都值得纳入自己的工程实践。
相关推荐

Claude Code v2.1.316 更新解析:企业级网关与多项稳定性修复
Claude Code v2.1.316 发布:新增企业网关池化组预算、分层策略模式、子智能体 effort 控制,修复 Shell、网络与会话恢复等数十项问题,并弃用 Opus 4.8 fast 模式。
17世纪英国洪水与末日恐慌:天气史新解
基于Hacker News讨论的'17世纪英国洪水与不祥预感',解读极端天气如何被赋予神意与政治预兆意义,并探讨天气史对当代气候传播与灾害舆情的启示。

合理使用制度为何对AI时代人人有益
从Hacker News讨论出发,解析合理使用(Fair Use)原则在AI训练与内容创作中的法律逻辑、争议焦点及其对创作者与技术生态的双重影响。