SafeRoute-MAS:多智能体推理的消息路由新方法

SafeRoute-MAS用覆盖感知与风险校准路由专家消息,但收益有限、标签不稳、验证回顾性。
本文梳理了多智能体科学推理中的消息路由方法 SafeRoute-MAS。该方法采用两阶段决策:先评估每条专家消息对当前任务的覆盖贡献,再结合风险模型决定保留或移除,且仅使用整合前信息以保证决策独立。在密封缓存的 5,328 个委员会上,它取得 +1.80 个百分点提升并减少 12.76% 消息 token;但在 gpt-oss-120b 端点的 4,580 次受控实验中,样本估计仅为 -0.09 个百分点,设计加权后为 +0.94 个百分点,置信区间宽且跨零。标签可靠性方面,88 个非中性标签中仅 13 个(14.8%)在多数投票下方向一致。风险上,加权预期损坏 UCL 为 4.60%,11 个预设边际仅 2 个通过,数值资格认证为回顾性应用。总体而言,该方法框架有理论吸引力,但收益不稳定、标签噪声大、缺乏前瞻性验证,距实际部署仍有距离。
多智能体系统在科学推理中展现出巨大潜力,但专家消息的冗余和错误传播也成为瓶颈。近期提出的SafeRoute-MAS试图通过覆盖感知和风险校准的消息路由,在保留关键信息的同时剔除冗余内容。本文基于公开的预印本信息,梳理其方法、实验结果与局限。
方法核心:覆盖感知与风险校准
SafeRoute-MAS的核心是一个两阶段决策流程:先评估每条专家消息对当前推理任务的覆盖贡献,再结合风险模型决定是保留还是移除该消息。关键在于,该过程仅使用消息整合前的信息,不依赖后续推理结果,从而保证路由决策的独立性。
这种设计试图解决多智能体协作中的一个常见矛盾:专家消息越多,信息覆盖越全面,但噪声和冲突也随之增加。SafeRoute-MAS通过覆盖感知来量化每条消息的独特价值,并通过风险校准来控制移除消息可能带来的错误风险。
覆盖感知(coverage-aware) 一词借鉴自集合覆盖与信息检索中的覆盖度评估:对给定推理任务,它衡量某条消息是否引入了其他消息尚未涉及的关键论据、证据或推理步骤。常见的量化方式包括基于语义相似度的去重计数、基于任务关键词的命中率,或由模型判断消息是否提供“新增信息”。覆盖感知的价值在于把“冗余”从笼统的重复中区分出来——两条措辞不同的消息可能高度冗余,而一条简短消息可能承载唯一关键事实。
风险校准(risk calibration) 指在决定移除消息前,估计该移除动作导致最终答案出错的概率,并使这一估计与真实错误率对齐。校准通常通过历史数据上的可靠性曲线(reliability diagram)或温度缩放等方法检验。若风险分数系统性偏低,路由会过度移除消息;偏高则保守保留冗余。SafeRoute-MAS 将覆盖贡献与校准后的移除风险联合决策,正是为了避免“只看冗余、不看代价”的激进裁剪。
实验结果:有限提升与统计不确定性
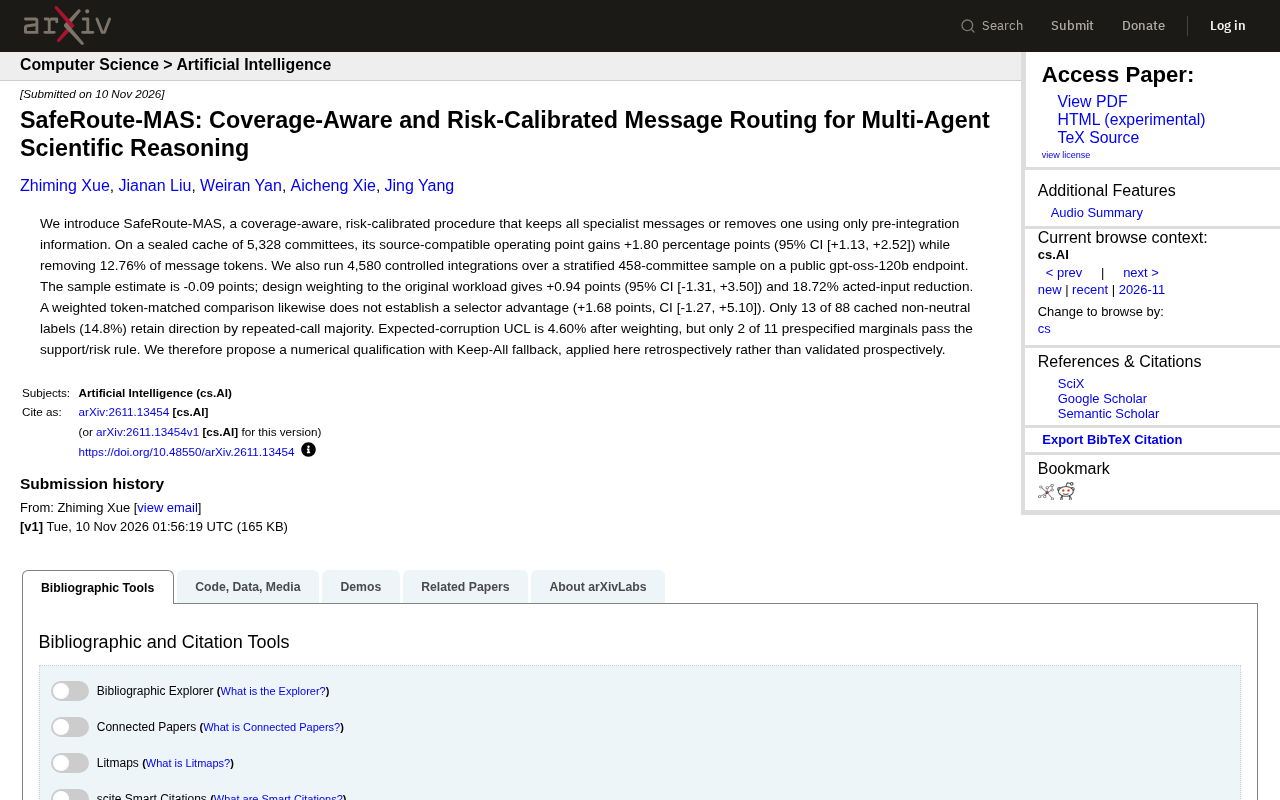
在密封缓存(sealed cache)的5,328个委员会(committee)上,SafeRoute-MAS在源兼容操作点(source-compatible operating point)上取得了+1.80个百分点的提升(95%置信区间[+1.13, +2.52]),同时移除了12.76%的消息token。这一结果看似积极,但需要结合后续实验谨慎解读。
研究者还在公开的gpt-oss-120b端点上进行了4,580次受控整合实验,样本来自458个委员会的分层抽样。样本估计值为-0.09个百分点,即几乎无提升;对原始工作负载进行设计加权后,提升变为+0.94个百分点(95%置信区间[-1.31, +3.50]),同时减少了18.72%的输入。加权后的token匹配比较同样未能确立选择器优势(+1.68个百分点,置信区间[-1.27, +5.10])。这些结果表明,SafeRoute-MAS的收益在不同评估设置下并不稳定,且置信区间较宽,统计显著性存疑。
密封缓存(sealed cache) 指实验者预先固定、不再随模型或提示变化而更新的推理轨迹与消息集合,通常用于可复现的离线评估。其优点是评估条件受控、结果可重复;缺点是可能与真实部署时的新鲜输入分布存在偏差,容易高估方法收益。
源兼容操作点(source-compatible operating point) 指在路由阈值等超参数上选取的一个工作点,使得该方法在与基线相同的消息来源与预算约束下运行,从而保证比较公平。不同操作点对应不同的保留率与风险取舍,单点提升不能代表整条权衡曲线。
设计加权(design weighting) 用于纠正分层抽样带来的分布偏移:若实验按委员会分层抽样,各层被抽中的概率不同,直接平均会偏离原始工作负载,需按抽样设计的逆概率加权还原总体估计。加权后置信区间变宽,正说明有效样本量下降、估计不确定性上升。
标签可靠性堪忧:仅14.8%的非中性标签方向一致
一个值得警惕的发现是,在88个缓存的非中性标签中,只有13个(14.8%)在重复调用多数投票下保持了方向一致。这意味着大多数标签的指示方向不稳定,可能影响路由决策的可靠性。标签不一致可能源于模型输出的随机性或评估标准的不确定性,这对依赖标签进行风险校准的SafeRoute-MAS构成了根本性挑战。
非中性标签 指并非“无倾向/中立”的标注,例如标记某条消息为“有益”或“有害”、“应保留”或“应移除”。这类标签直接决定风险模型的正负样本,因此其方向稳定性至关重要。
重复调用多数投票 是一种常用的标签稳定性检验:对同一输入多次调用模型并让多个评审投票,若多数结果的方向在多次重复中保持一致,则认为标签可靠。14.8% 的方向一致率意味着绝大多数标签在重复采样下会翻转,说明标签更多反映模型输出的随机波动而非稳定信号。对依赖标签训练风险校准器的 SafeRoute-MAS 而言,这相当于在噪声标签上拟合,校准曲线可能严重失真,进而使路由决策在部署时不可信。
风险控制与资格认证:回顾性而非前瞻性验证
在风险方面,加权后的预期损坏上置信限(UCL)为4.60%,但11个预设边际中只有2个通过了支持/风险规则。因此,研究者提出了一种带有Keep-All回退的数值资格认证(numerical qualification),但该认证是回顾性应用的,而非前瞻性验证。这意味着SafeRoute-MAS的实际部署风险尚未经过严格的前瞻性测试,其可靠性仍需进一步验证。
预期损坏上置信限(UCL) 是对“移除消息导致答案错误”这一损坏率的单侧置信上界:在给定置信水平下,真实损坏率以较高概率不超过该值。UCL 为 4.60% 表示统计上不能排除损坏率接近该水平,而非点估计。
支持/风险规则 是预设的验收判据,通常要求同时满足“效果有正向支持”和“风险低于边际”两条。11 个边际中仅 2 个通过,说明多数风险预算下方法未达验收标准。
回顾性验证与前瞻性验证 的区别在于:回顾性是在已有数据上事后选择阈值并评估,容易过拟合;前瞻性是在未参与调参的新数据上预先锁定规则再评估,才能反映真实部署表现。Keep-All 回退 指当风险无法认证时默认保留全部消息,以安全但低效的方式兜底。数值资格认证若仅回顾性应用,其结论不能直接推广到线上。
总结与展望
SafeRoute-MAS为多智能体科学推理中的消息路由提供了一种新思路,其覆盖感知和风险校准的框架具有理论吸引力。然而,实验结果揭示了收益的有限性和统计不确定性,标签可靠性的低下以及风险验证的回顾性性质,都提示该方法距离实际部署还有距离。未来工作需要在前瞻性验证、标签稳定性提升以及更稳健的风险控制机制上继续探索。
相关推荐

Pi Agent凭什么爆火?极简内核+可扩展的AI编程新思路
Pi Agent 为何在 AI 编程工具赛道脱颖而出?本文解析其极简内核、按需扩展的设计哲学,对比 Cloud Code、Codex 等主流工具的功能膨胀困境,探讨开发者自主控制 agent 的价值与轻量路线的取舍。

Claude Code用量总提前耗尽?7个技巧让额度撑更久
Claude Code额度总提前耗尽?本文整理七个实用技巧:切换到新任务时使用 slash clear、按任务选择Sonnet或Opus、调低effort等级、精简CLAUDE.md、关闭不用的MCP服务器、plan mode先规划、用slash usage定位消耗源头,帮助你延长用量额度的使用时间。

Cursor多智能体协作:浏览器扩展里看AI设计网站
YouTube短视频展示了多光标AI智能体在浏览器中协作设计网站的画面,其载体为浏览器扩展而非独立平台。本文梳理该演示的关键细节、信息缺口及其反映的多智能体协作趋势。