SaluNet:用可学习几何替代BatchNorm与LayerNorm

SaluNet 用每层两个标量的几何形变替代归一化层,小批量下表现稳定。
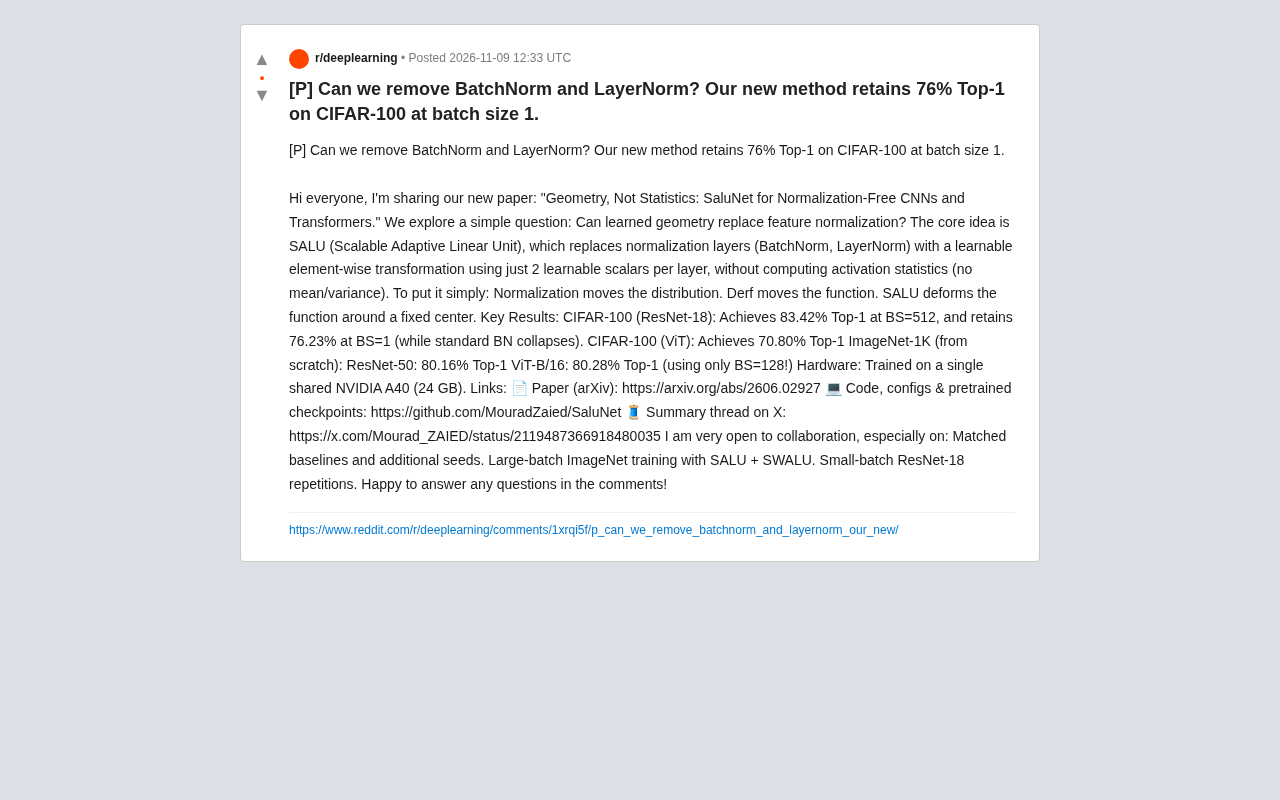
论文《Geometry, Not Statistics: SaluNet for Normalization-Free CNNs and Transformers》提出 SALU 模块,在每个归一化层的位置用逐元素可学习几何变换替代 BatchNorm/LayerNorm,每层仅引入 2 个标量且不计算激活统计量,从而从原理上避开小批量敏感与训练/推理不一致问题。实验显示 CIFAR-100 上 ResNet-18 在 BS=512 达 83.42% Top-1,BS=1 仍保留 76.23%,而标准 BN 在 BS=1 下崩溃;ImageNet-1K 从零训练 ResNet-50 达 80.16%、ViT-B/16 达 80.28%(仅 BS=128),全部在单张 A40 上完成。作者正征集匹配基线与更多随机种子的复现合作,稳健性仍需独立验证。
深度学习模型中的归一化层(BatchNorm、LayerNorm)几乎已是标配,但它们对批次大小的依赖、在分布式训练中的同步开销,以及推理时统计量估计的偏差,一直是工程与理论上的痛点。最近 Reddit 上有一篇讨论度颇高的论文《Geometry, Not Statistics: SaluNet for Normalization-Free CNNs and Transformers》提出了一个直接的问题:能否用可学习的几何变换,彻底取代特征归一化?
核心思路:从“移动分布”到“形变函数”
作者提出的 SALU(Scalable Adaptive Linear Unit)模块,在每个归一化层的位置替换为一个可学习的逐元素变换,每层仅引入 2 个可学习标量,且完全不计算激活的均值与方差。作者用一句话概括了三种范式的差异:“Normalization moves the distribution. Derf moves the function. SALU deforms the function around a fixed center.”
这意味着 SALU 不依赖任何批次统计量,因此从原理上消除了对小批量敏感、训练与推理行为不一致等问题。每层两个标量的参数量,相比 BN 的缩放与偏移参数也极为轻量。
批量统计量估计的方差问题:BatchNorm 在训练时用当前 mini-batch 的均值和方差对激活做标准化,这两个统计量本身是随机变量。当批量大小为 B 时,均值估计的方差大致与 1/B 成正比,方差估计的偏差也随 B 减小而显著增大。BS=1 时,每个通道的“方差”退化为零(或仅由数值稳定项决定),标准化实际上失去意义,网络输出会剧烈震荡,这正是标准 BN 在极小批量下崩溃的机制根源。LayerNorm 虽不依赖批量维度,但对每个样本在特征维度上重新中心化与缩放,在大规模 Transformer 中会引入额外的归约计算与内存访问开销,且其统计量同样来自有限维度的估计。SALU 完全绕开统计量估计,因此不受 B 的大小影响,也不存在训练/推理阶段统计量来源不一致的问题。
实验结果:小批量下的稳定性是亮点
论文报告的主要结果如下(均来自原文):
- CIFAR-100(ResNet-18):BS=512 时 Top-1 为 83.42%;BS=1 时仍保留 76.23% Top-1,而标准 BN 在该条件下会崩溃。
- CIFAR-100(ViT):Top-1 为 70.80%。
- ImageNet-1K(从零训练):ResNet-50 达到 80.16% Top-1;ViT-B/16 达到 80.28% Top-1,且仅使用 BS=128。
- 硬件:训练在单张共享的 NVIDIA A40(24 GB)上完成。
最值得关注的是 BS=1 时 CIFAR-100 上 76.23% 的保留率。BatchNorm 在极小批量下因统计量估计方差过大而性能骤降,这是业界共识;SALU 的“无统计量”设计正好绕开了这一机制,使其在小批量场景下具备结构性优势。
为什么这件事值得关注
归一化层的问题不止于精度。BatchNorm 在数据并行训练中需要跨设备同步统计量,带来通信开销;在批量很小时,其表现又不可靠。LayerNorm 则在大规模 Transformer 训练中引入额外计算。如果 SALU 的思路能被更广泛地验证,它可能为以下场景提供替代方案:
- 单卡或小批量训练(如研究者常用的 24 GB 级显卡);
- 对训练/推理一致性要求高的部署环境;
- 需要减少跨设备同步的分布式训练。
从“几何”而非“统计”的角度处理特征尺度,也为归一化-free 网络的研究提供了一个新视角——不是去修正统计量,而是让网络自己学习如何形变激活函数。
数据并行中的同步开销:在数据并行训练中,BatchNorm 的均值和方差需要在所有设备上做 all-reduce 聚合,才能在每张卡上得到一致的标准化结果。这意味着每个 BN 层在前向和反向传播中都会触发跨设备通信,层数越多、设备越多,通信量越大,在大规模集群上可能成为扩展瓶颈。LayerNorm 不跨设备同步批量统计量,但在张量并行场景下,沿特征维度的归约仍可能涉及设备间通信。SALU 的逐元素变换只依赖各元素自身的可学习参数,前向与反向都不需要任何跨样本或跨设备的统计量聚合,因此从通信模式上更接近逐元素激活函数,而非归一化层。
需要保持审慎的地方
论文目前仍处于早期传播阶段,作者本人也在征集合作,明确提出希望补充:匹配的基线对比与更多随机种子、SALU + SWALU 的大批量 ImageNet 训练、以及小批量 ResNet-18 的重复实验。这说明当前结果的稳健性仍需更多独立复现来支撑。
另外,CIFAR-100 上 ViT 的 70.80% 与 ImageNet 上的结果来自不同设置,跨任务的横向比较需要谨慎。BS=1 场景下“BN 崩溃”的具体幅度、SALU 与其他归一化-free 方法(如 Fixup、GroupNorm)的直接对比,在原始贴文中并未展开,这些是判断该方法实际价值的关键缺口。
Fixup 与 GroupNorm 作为对照基线:Fixup 是一类不依赖归一化层的残差网络训练技巧,通过特定的参数初始化与缩放策略(如对残差分支乘一个小常数、对最后几层置零初始化)来维持深层网络的信号传播,从而在无归一化条件下训练 ResNet。GroupNorm 则将通道分组,在每组内对空间维度和组内通道做归一化,不依赖批量大小,常用于小批量检测与分割任务。这两者与 SALU 的目标场景有重叠:Fixup 同样追求归一化-free,GroupNorm 同样对小批量友好。若 SALU 要与它们直接比较,需要在相同骨干、相同训练轮数与相同数据增强下报告结果,并说明 SALU 的额外可学习标量是否改变了有效学习率或初始化敏感性,否则难以判断其精度优势来自几何形变本身还是来自超参适配。
小结
SaluNet 提出的 SALU 用每层两个标量的几何形变替代归一化层,在 CIFAR-100 和 ImageNet 上给出了可用的精度数字,小批量下的稳定性尤其引人注意。它是否真能成为 BatchNorm/LayerNorm 的通用替代品,取决于后续的基线补齐与独立复现。对关注归一化-free 架构、小批量训练和轻量硬件训练的研究者来说,这篇论文与开源代码值得跟进。
相关推荐
5.3英寸手机众筹:小屏复兴还是599美元的无奈?
Enough Phone 在 Kickstarter 众筹,5.3 英寸小屏搭配 8GB 内存和 5000 万像素传感器,定价 599 美元。The Vergecast 讨论小屏手机能否在旗舰大屏与功能机之间找到中间地带,以及廉价手机为何越来越难做。
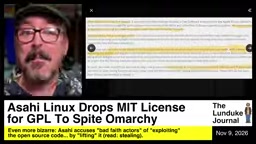
Asahi Linux弃用MIT转GPL:一场针对Omarchy的闹剧?
Asahi Linux将代码许可证从MIT改为GPL V2,指控Omarchy窃取代码并商业化。分析认为此举理由牵强且违反MIT协议,暴露开源社区政治分歧与AI争议。
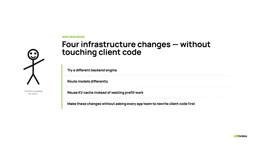
5分钟读懂NVIDIA Dynamo前端:兼容OpenAI的推理架构入口
NVIDIA Dynamo前端是什么?本文基于官方5分钟系列视频,解析它如何以OpenAI兼容API作为稳定边界,实现后端引擎替换、路由与KV缓存复用的解耦架构。