Semantica:开源版Palantir的图上下文基础设施详解

Semantica 是开源图结构上下文基础设施,将非结构化文本转化为知识图谱,帮助 AI Agent 做出更可靠的决策。
Semantica 是一个面向 Agentic AI 系统的开源知识图谱基础设施,GitHub 已获超 8000 颗 star,被誉为「开源版 Palantir」。它的核心能力是将原始文本解析为实体(Node)和关系(Edge)构成的图结构,通过内置冲突检测与去重保证数据质量,并支持传统方式和 LLM 辅助两种图构建路径,最终存入 VectorStore 供后续检索。系统将「决策」作为一等公民纳入图谱,支持追溯决策来源、查找相似决策、分析连锁影响等能力。配套的 Semantic Explorer 提供可视化浏览,支持邻居视图、时间轴、热力图等多种视角。Semantica 还支持多 Agent 共享同一上下文图谱,并通过 MCP Server、REST API 和 CLI 三种方式灵活集成到现有 AI 工作流中。
什么是 Semantica
在 AI Agent 快速发展的今天,如何让智能体真正"理解"上下文,而不是简单地把一大段文本丢给大模型自行判断,成为了一个关键工程问题。Semantica 正是针对这一痛点诞生的开源项目——它被社区称为"开源版 Palantir",目前在 GitHub 上已经收获了超过 8000 颗 star。
从定位上看,Semantica 是一个基于 Graph(图结构)的上下文基础设施,专门为 Agentic AI 系统服务。它的核心能力是把一段原始字符串转换成结构化、图化的丰富上下文。这样一来,Agent 就能沿着节点(Node)和边(Edge)去理解信息之间的关系,从而做出更准确的决策。
简单来说,它解决的问题是:与其把一整段冗长的文本作为 prompt 丢给 LLM,让模型"看着办",不如先把这段文本拆解成实体与关系的图谱,再引导 Agent 基于结构化上下文进行推理。
知识图谱(Knowledge Graph) 是一种以图结构表示现实世界实体及其相互关系的数据模型,最早由 Google 于 2012 年引入搜索引擎。图中的「节点」代表实体(如人物、地点、事件),「边」代表实体间的关系(如「创立了」「属于」「发生于」)。相较于纯文本,图结构的优势在于显式表达了信息之间的关联,使计算机能够进行路径推理和关系查询。Palantir 是一家知名数据分析公司,其核心产品 Palantir Gotham 和 Foundry 也以图化知识管理见长,但属于闭源商业软件,授权费用极高,主要服务于政府和大型企业。Semantica 被称为「开源版 Palantir」,意指它以开放方式提供了类似的图化上下文管理能力,使中小团队和独立开发者也能构建类似的智能体基础设施。
核心架构:从原始文本到知识图谱
Semantica 的架构设计相当清晰,整个数据流可以拆分为几个关键阶段。
上下文解析与实体抽取
最前端是 Sources(原始上下文来源)。当上下文进入系统后,会先被解析成对象并做标准化处理,随后被拆分成不同的 Entity(实体) 和 Edge(边),把所有关键信息抽取出来。
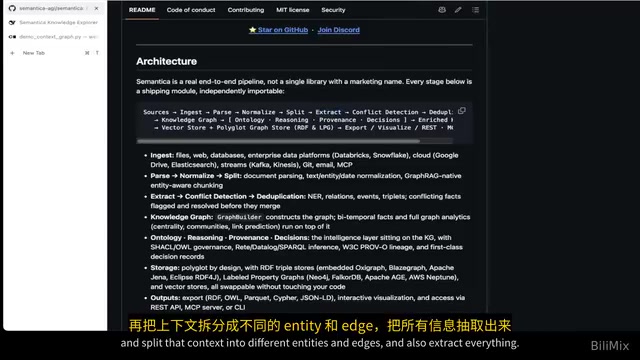
值得一提的是,在抽取过程中系统内置了冲突检测机制,可以消除信息冲突并进行去重。这一步对于保证知识图谱的准确性至关重要——毕竟脏数据会直接影响 Agent 的判断质量。
知识图谱构建
抽取完实体和边之后,系统进入 Graph 构建阶段。这里提供了两种构建方式:一种是传统的直接构建方式,另一种是借助 LLM 来完成抽取和构建。
以 LLM 方式为例,流程大致是:先读取一大段上下文,交由 LLM 抽取所有信息(即抽取出各个实体和边),再用 Relationship Extractor(关系抽取器)建立实体之间的关系,最后交给 Graph Builder 统一构建成图。构建完成后,图谱会被存入 VectorStore,方便后续检索。
此外,Semantica 支持 Polyglot GraphStore 导出,可以把整张图导出成 JSON 文件,方便可视化和迁移。
VectorStore(向量存储) 是一类专门用于存储和检索高维向量的数据库,如 Chroma、Pinecone、Weaviate 等。在知识图谱场景中,每个实体节点除了存储结构化属性外,还会被编码为语义向量,从而支持「语义相似性搜索」——即在没有精确关键词匹配的情况下,通过向量距离找到语义相近的节点。Semantica 将图结构与向量检索结合,意味着 Agent 既可以通过图的边关系进行结构化遍历,也可以通过向量相似度进行模糊语义检索,两种检索方式互补,能覆盖更广泛的查询场景。Polyglot GraphStore 则指系统能够与多种图数据库或格式兼容导出(如 JSON、Neo4j 等),体现了架构的灵活性与可迁移性。
决策智能:让 Agent 有据可循
Semantica 最有价值的设计之一,是它把"决策"作为一等公民纳入了图结构。一切最终都归结为——基于上下文做出更好的决策。
构建好图之后,如果你想记录一个决策,直接调用图的 Record Decision 即可。基于这个决策,系统支持一系列强大的操作:
- 追溯决策来龙去脉:查看某个决策是如何一步步做出来的
- 查找相似决策:复用历史经验
- 分析决策影响:评估决策的连锁效应
- 检查决策规则:验证决策是否符合既定逻辑
这些能力本质上是在帮 Agent 理解"上下文是如何运作的",以及"如何在上下文中做出更优决策"。项目还提供了决策树的可视化——当你创建一个决策后,它会以决策图的形式呈现,你可以直观地看到各个决策之间的分支关系。
Semantic Explorer:强大的图谱可视化工具
光有底层结构还不够,Semantica 提供了一个功能丰富的 Web 可视化工具 Semantic Explorer,让抽象的知识图谱变得一目了然。
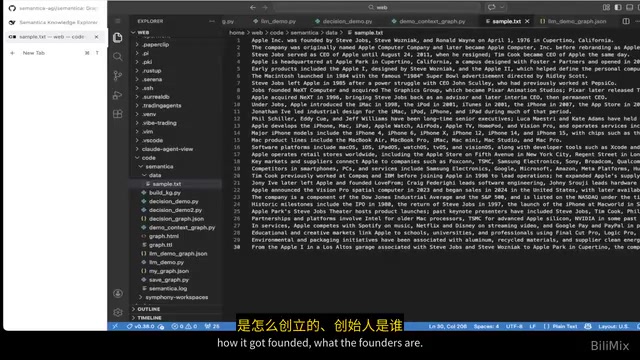
在演示中,作者粘贴了一段关于 Apple Inc. 的介绍文本,系统自动将其拆分成 140 个 Node 和 11 条 Edge。你可以清楚地看到 Apple 是如何创立的、创始人是谁、以及各实体之间的连接关系。
Semantic Explorer 提供了多种浏览视角:
- 邻居视图:点击任意节点即可看到它的直接邻居。比如点击 2007 这个节点,就能看到它同时连接着 iPhone 和 Apple
- 时间维度:支持按时间轴查看上下文如何随时间演变
- Ego 模式:以某个节点为中心展开关系网
- 热力图:包括结构热力图和隐喻热力图
- 分组视图与完整图:从不同粒度观察上下文
- Link Prediction:一键运行链接预测
- 搜索功能:搜索 "Apple" 会列出所有相关节点,如 Apple Park、Apple Silicon 等
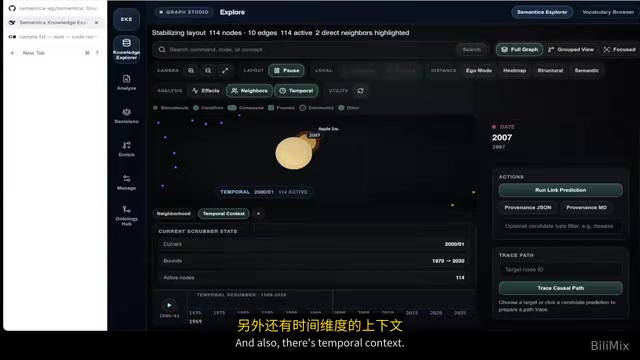
相比于把整段冗长原文直接丢给 Agent(容易理解错或理解不到位),这种拆解成 Node 和 Edge 的图结构,再结合决策信息,能显著提升 Agent 对上下文的理解质量。
多 Agent 共享上下文与集成方式
Semantica 另一个亮点是支持共享上下文。通常情况下,上下文是按 Agent 隔离的——每个 Agent 拥有自己独立的上下文。但在 Semantica 中,同一份上下文可以在多个 Agent 之间共享。
举例来说,你可以把一份共享上下文同时传给 Researcher Agent 和 Knowledge Agent,甚至把多个 Agent 组成一个团队,让整个系统在同一份图基础设施上协作。这对于构建复杂的多智能体系统非常有用。
在集成方面,Semantica 提供了多种接入方式:
- MCP Server 集成:可以直接接入 Claude Code、Codex 等编码 Agent
- REST API 集成:提供标准的 HTTP 接口
- CLI 方式:通过命令行操作
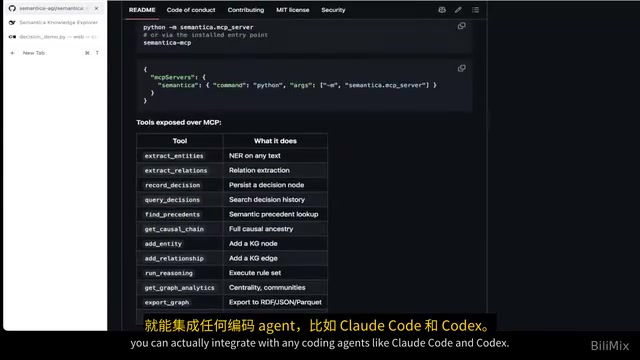
换句话说,只要把 Semantica 接到 MCP 或后端服务器上,任何编码 Agent 都能通过查询它来获取结构化上下文。
MCP(Model Context Protocol) 是 Anthropic 于 2024 年推出的开放协议,旨在标准化 AI 模型与外部工具、数据源之间的通信方式。可以将其理解为 AI 领域的「USB 接口」——工具提供方只需实现 MCP Server,模型侧只需支持 MCP Client,双方即可无缝对接,无需为每个工具单独开发集成逻辑。Claude Code、Cursor 等主流编码 Agent 均已支持 MCP,这意味着将 Semantica 部署为 MCP Server 后,这些 Agent 可以在对话过程中直接调用 Semantica 的图查询和决策接口,实时获取结构化上下文,而无需开发者手动编写任何胶水代码。这一集成方式大幅降低了 Semantica 接入已有工作流的门槛。
快速上手:安装与配置指南
对于想尝试的开发者,配置流程并不复杂。
基础安装步骤
- 克隆仓库到本地
- 运行
pip install安装所有依赖 - 安装
openai库(用于 LLM 方案) - 安装向量存储与嵌入相关依赖
启动服务
安装完成后,你可以选择性地启动以下组件:
- Semantic Kernel / Semantic Server(REST 服务器)
- Explorer(数据浏览可视化工具)
- Semantica MCP(供 Agent 调用)
关键环境变量配置
配置时需要注意几个重要变量:
CORS Origins:如果部署到 VPS,需要设置 Explorer 的跨域来源API Key:Semantica 的访问密钥Allow Anonymous:默认为 false。测试时可设为 true 允许匿名访问,但生产环境务必设为 false 以保证安全OpenAI API Key与Base URL:用于配置 LLM。支持 OpenAI、Bedrock、Llama 等多种模型
总结
Semantica 之所以被称为"开源版 Palantir",在于它把复杂的上下文管理、知识图谱构建和决策智能整合到了一套开源框架中。对于正在构建 Agentic AI 系统的开发者而言,它提供了一条清晰的路径:把非结构化文本转化为可推理的图结构,让 Agent 基于结构化上下文做出更可靠的决策。
无论是丰富的可视化能力、决策追溯机制,还是多 Agent 上下文共享和 MCP/REST 集成,Semantica 都展现出了成为下一代 AI 上下文基础设施的潜力。8000+ star 的社区认可,也印证了这个方向的价值。
相关推荐

AI检测误判风波:作家被指用AI写作,谁该举证?
2026年英联邦短篇小说奖地区获奖者被Pangram检测工具判定100% AI生成,最终靠草稿自证清白。这起事件揭示了AI检测工具的误判风险与创作者面临的举证困境,以及作家协会承认没有可靠AI检测方法的现实。

Paul Ford新作引热议:Web本身已经足够
Paul Ford 文章《The Web Is More Than Enough》在 Hacker News 引发讨论,主张 Web 标准已足够承载应用开发,反对动辄引入封闭平台。本文梳理其核心论点、与当前 AI 应用潮流的张力,以及对开发者技术选型的实际含义。

斯坦福如何教授AI原生工程:CS146S课程揭秘
斯坦福CS146S课程直面AI一键生成作业的挑战,探索AI原生工程教育。Mihail Eric分享如何将AI作为工程伙伴,培养系统设计和代码审查能力,为工程教育提供新范本。