Seq2Seq模型只会预测填充符?常见问题与修复思路
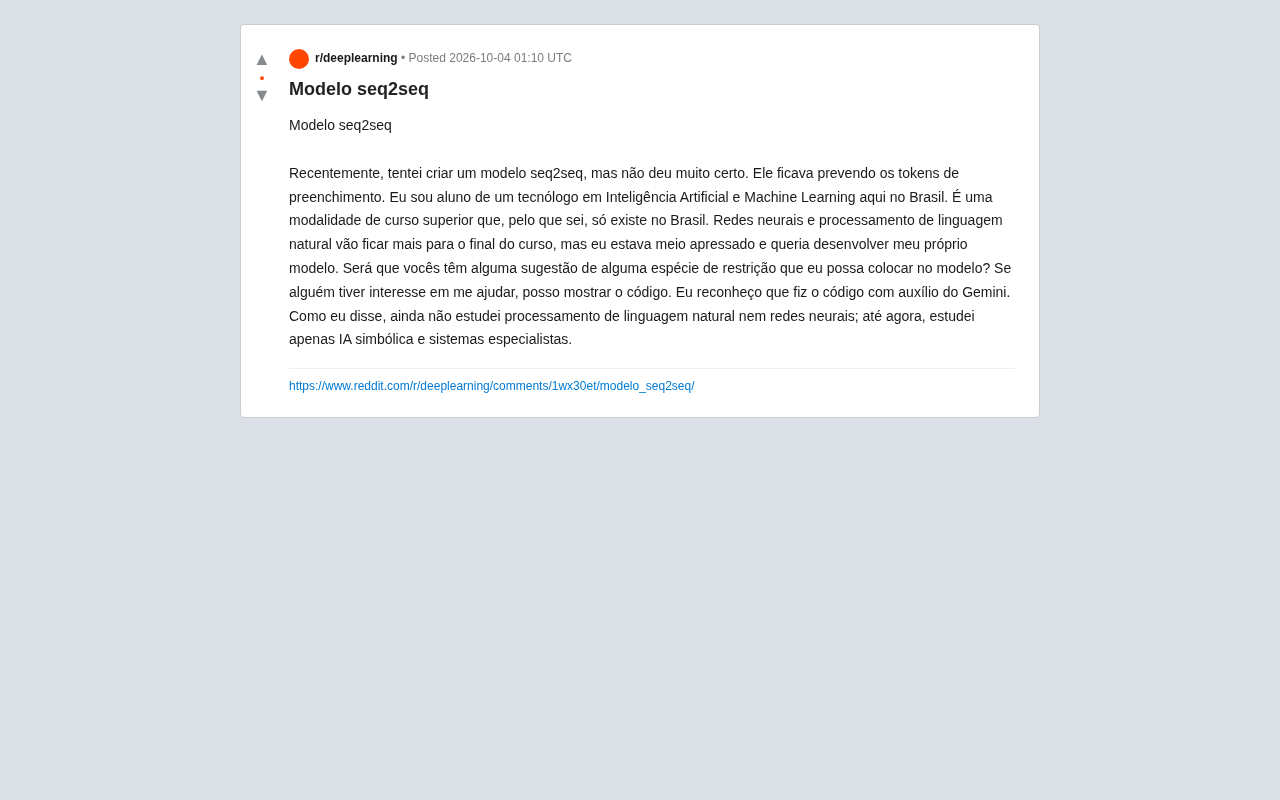
初学者搭建seq2seq模型时,损失函数未屏蔽padding是导致模型只输出填充符的头号原因。
一位尚未系统学习神经网络的学生在尝试搭建seq2seq模型时遭遇了典型新手陷阱:模型不断预测填充(padding)token而非有意义的输出。文章系统梳理了这一问题的根本成因——损失函数未对填充位置做掩码,导致模型发现"无脑输出padding"是降低损失的捷径。此外,训练数据中padding占比过高也会加剧这一倾向。解决方案涵盖多个层面:训练层面需设置loss mask、引入teacher forcing并配合梯度裁剪;推理层面可通过beam search和生成长度约束改善输出质量。文章同时建议零基础自学者从玩具数据集入手,先跑通最简任务再逐步增加复杂度,将每次失败转化为深入理解底层机制的契机。
一个常见的新手困境
一位来自巴西的AI与机器学习技术类专业学生在Reddit上发帖求助:他尝试自己搭建一个seq2seq(序列到序列)模型,却遇到了典型的训练失败现象——模型反复预测填充(padding)token,而不是生成有意义的输出。
这位学生坦言,自己的课程还没有正式教到神经网络和自然语言处理,目前只学过符号主义AI和专家系统。他在借助Gemini的辅助下完成了代码,但模型的表现并不理想。这其实是许多初学者在首次接触深度学习序列模型时都会碰到的经典问题,背后的原因值得系统梳理。
为什么模型只会预测填充符
seq2seq模型在NLP任务中广泛用于机器翻译、文本摘要、对话生成等场景。它通常由编码器(encoder)和解码器(decoder)两部分组成。当模型“偷懒”到只输出padding token时,往往不是模型架构本身有问题,而是训练流程中的几个关键环节出了纰漏。
损失函数未屏蔽填充位置
最常见的根源在于:计算损失时没有忽略padding token。在序列任务中,为了让一个batch内长短不一的句子对齐,会用特殊的填充符补齐到相同长度。如果在计算交叉熵损失时不对这些填充位置做掩码(mask),模型会发现——只要无脑输出padding,就能在大量填充位置上获得很低的损失。于是它就学会了这种“捷径”。
解决方法是在损失函数中设置ignore_index指向padding的索引(PyTorch的CrossEntropyLoss支持此参数),或手动构建attention mask与loss mask,确保填充位置不参与梯度更新。
数据分布严重失衡
如果训练数据中填充token的占比过高(例如大量短句被补到很长的固定长度),模型同样会倾向于预测这个高频符号。合理控制最大序列长度、按长度分桶(bucketing)打batch,可以显著缓解这一问题。
seq2seq(Sequence-to-Sequence)架构由Sutskever等人于2014年提出,最初用于解决机器翻译问题。编码器将输入序列逐步压缩成一个固定维度的上下文向量(context vector),解码器再以此为起点逐token生成输出序列。早期实现多基于LSTM或GRU,现代实现则大量采用Transformer架构中的注意力机制(Attention Mechanism),后者能更有效地处理长距离依赖,避免信息在压缩为单一向量时丢失。理解编码器-解码器的信息传递方式,是诊断模型输出异常的重要基础——当解码器在第一步就"跑偏",问题往往出在训练信号(即损失函数)的设计上,而非架构本身。
可以尝试的约束与改进手段
帖主特别问到:是否有某种“约束”可以加到模型上。这里的“约束”可以从几个层面理解。
训练层面的约束
- Loss masking(损失掩码):这是最该优先做的,直接屏蔽padding对损失的贡献。
- Teacher forcing(教师强制):在训练解码器时,用真实的目标token作为下一步输入,而不是用模型自己的预测。缺少teacher forcing会让早期训练极不稳定。
- 学习率与梯度裁剪:序列模型容易梯度爆炸或消失,适当的梯度裁剪(gradient clipping)和合理的学习率调度能让训练更平稳。
Teacher Forcing是训练序列生成模型时的核心技巧,由Williams和Zipser于1989年提出。其核心思想是:在训练解码器时,每一步的输入不使用模型上一步的预测结果,而是直接使用真实目标序列中的对应token。这样做的好处是梯度信号更稳定,训练初期不会因为模型早期预测质量极差而导致误差随时间步快速累积(称为"曝光偏差"问题)。然而,Teacher Forcing也有副作用:模型在训练和推理阶段的输入分布存在差异,可能导致推理时性能下降。为此,研究者提出了Scheduled Sampling等折中方案,在训练后期逐渐引入模型自身的预测作为输入,帮助模型适应推理场景。
解码层面的约束
在推理阶段,可以通过以下方式限制输出行为:
- 禁止或降低生成padding、特殊token的概率;
- 使用beam search替代贪心解码,提升输出质量;
- 设置最小/最大生成长度,避免过早输出结束符。
Beam Search(束搜索)是序列生成任务中最常用的解码算法,相比贪心解码(每步只保留概率最高的一个token)能探索更广的候选空间。它在每个时间步维护K条(K称为beam width)得分最高的候选序列,最终选取整体概率最高的输出。较大的beam width通常能提升输出质量,但计算开销也随之线性增加。在实践中,beam width设为4到10是较常见的选择。此外,长度惩罚(length penalty)参数可防止模型偏好过短的序列,重复惩罚(repetition penalty)则可抑制模型反复生成相同token的倾向——这在模型训练不充分时尤为常见。
给零基础自学者的建议
这位学生的处境颇具代表性:课程进度还没到神经网络,但求知欲促使他提前动手。这种实践精神值得肯定,但也要认识到seq2seq涉及的前置知识并不少——反向传播、词嵌入、RNN/LSTM或Transformer的工作原理,都是理解“为什么模型这样表现”的基础。
借助Gemini等AI助手生成代码是高效的学习方式,但如果不理解每一行代码的作用,遇到bug时就很难定位根源。更稳妥的路径是:先从一个极小规模的玩具数据集入手,确保能正确跑通一个最简单的翻译或复制任务,再逐步增加复杂度。许多成熟的教程(如PyTorch官方的seq2seq翻译教程)都提供了可直接运行并带详细注释的参考实现,是排查自己代码问题的好对照。
小结
模型只预测填充符,几乎可以断定是损失计算未屏蔽padding所致,这是seq2seq入门阶段的头号陷阱。配合teacher forcing、梯度裁剪与合理的解码策略,大多数此类问题都能解决。对于尚未系统学习NLP的自学者而言,把这类“失败”当作深入理解底层机制的契机,远比直接复制一段能跑的代码更有价值。
相关推荐
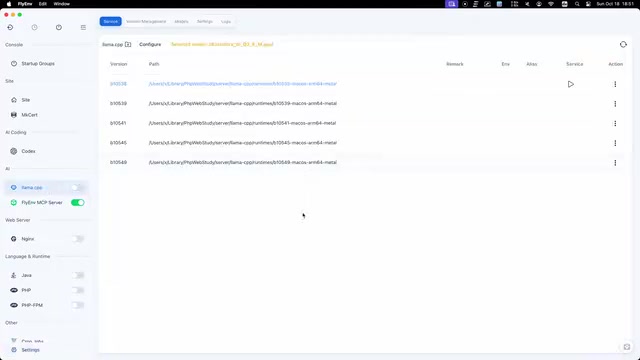
FlyEnv 插件实测:可视化运行 llama.cpp 与 GGUF 模型管理
FlyEnv 推出 llama.cpp 官方插件,提供多个 Metal 运行时并存管理、公共 GGUF 仓库索引与模型文件类型标注,以及上下文、线程、GPU 层数等推理参数可视化配置,支持模板与投机解码随模型保存,一键启动本地 LLM 推理服务。
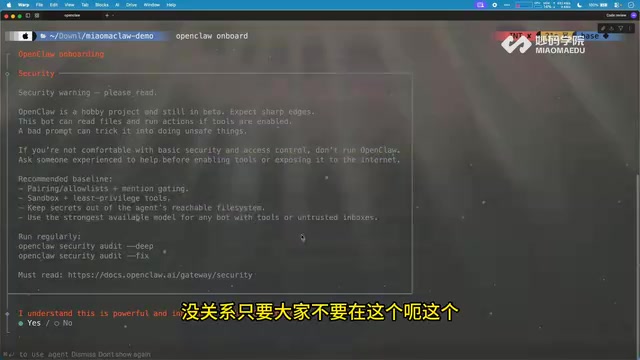
前端如何进阶AI智能体开发?从OpenClaw拆解系统级Agent架构
从B站公开课演示的OpenClaw出发,拆解系统级AI智能体的三层架构与通用公式,分析前端开发者基于TypeScript切入Agent开发的路径、插件化设计与安全记忆层难点,附面试回答框架。
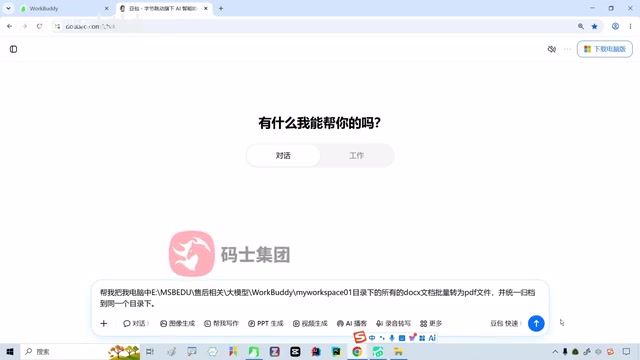
WorkBuddy实战:AI Agent如何自动批量转换与归档文件
通过B站UP主珊瑶老师的实测,对比豆包与WorkBuddy在文件批量转换任务中的表现,解析AI Agent如何从“给方案”到“直接执行”,附完整操作流程与积分消耗参考。